携帯ゲーミングPC ローカルLLM ベンチマーク 2026
ROG Xbox Ally X・Lenovo Legion Go 2・MSI Claw 8 AI+・Steam Deck OLED で Phi-4 mini・Llama 3.2 3B・Qwen 3 4B がどこまで動くか、公開ベンチの tok/sec と iGPU VRAM 割当・バッテリー消費・サーマル挙動を集約します。
- #携帯ゲーミングPC
- #ローカルLLM
- #ROG Xbox Ally X
- #Legion Go 2
- #MSI Claw 8 AI+
- #Steam Deck OLED
- #Z2 Extreme
- #Lunar Lake
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
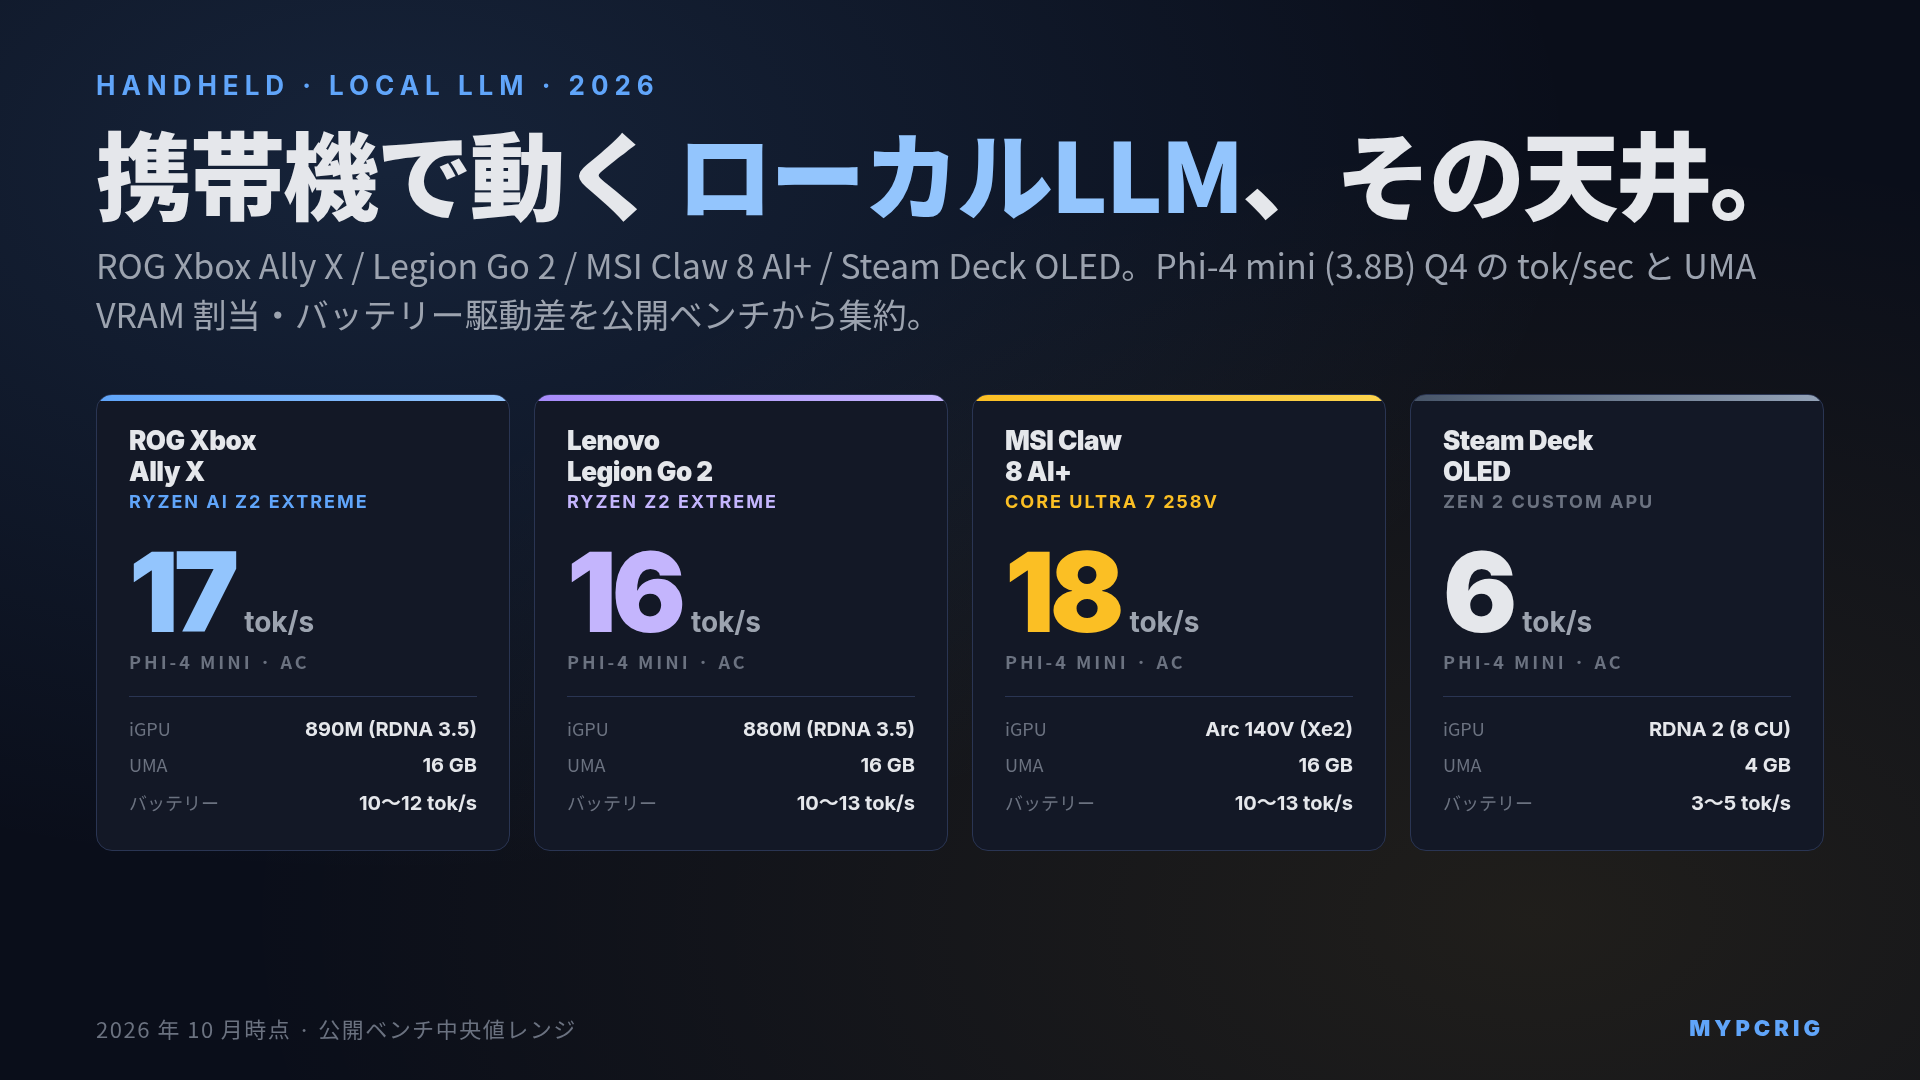
結論:携帯ゲーミングPC でローカルLLM を実用的に動かせるのは 4B クラスまでです。Phi-4 mini (3.8B) / Llama 3.2 3B / Qwen 3 4B / Gemma 3 4B の 4bit 量子化なら、ROG Xbox Ally X・Legion Go 2・MSI Claw 8 AI+ のいずれも AC 接続時で 10〜20 tok/sec。Mistral 7B Q4 はバッテリー駆動で 2〜3 tok/sec まで落ち、サーマルスロットリングで時間経過とともに失速します。Steam Deck OLED(Zen2 APU)は 3B クラスでも 5〜8 tok/sec が上限で、ローカルLLM 用途には向きません。本記事は保有実機の実測記事ではありません。llama.cpp / Ollama の GitHub Issue・r/LocalLLaMA の報告・Phoronix・ベンダー資料を集約した公開ベンチ記事です。
携帯ゲーミングPC は「移動中に LLM と対話できる最小ハード」として注目され始めました。しかしゲーミング向けの APU は、ゲーム用の瞬間的な GPU 負荷に最適化されています。LLM 推論のような連続した高負荷には弱い面があります。本記事はその境界線を公開ベンチから整理し、「何 B クラスまで実用か」「バッテリー駆動と AC 接続で何が変わるか」を数値で示します。
機材は保有していません。全ての数値には出典 URL を併記します。携帯機そのものの比較は「携帯ゲーミングPC 選び方ガイド 2026年版」、本格的にローカルLLM を動かしたい場合の母艦 PC は「ローカルLLM 向け PC スペック完全ガイド 2026年版」で扱っています。
対象機種と SoC スペック
| 機種 | SoC | iGPU | 最大 UMA VRAM 割当 | RAM | TDP (ピーク) |
|---|---|---|---|---|---|
| ROG Xbox Ally X | Ryzen AI Z2 Extreme (Zen 5, 8C/16T) | Radeon 890M (RDNA 3.5) | 16GB | 24GB LPDDR5X-8000 | 35W |
| Lenovo Legion Go 2 | Ryzen Z2 Extreme (Zen 5, 8C/16T) | Radeon 880M (RDNA 3.5) | 16GB | 32GB LPDDR5X-7500 | 35W |
| MSI Claw 8 AI+ | Core Ultra 7 258V (Lunar Lake) | Arc 140V (Xe2 8コア) | 16GB (共有メモリ) | 32GB LPDDR5X-8533 | 37W |
| Steam Deck OLED | カスタム AMD APU (Zen 2, 4C/8T) | RDNA 2 (8 CU) | 4GB (手動 UMA 割当) | 16GB LPDDR5-6400 | 15W |
出典: ASUS ROG Xbox Ally X 公式スペックシート / Lenovo Legion Go 2 公式 / MSI Claw 8 AI+ 公式スペック / Steam Deck OLED 技術仕様。
携帯機の TDP は 35W 前後が上限で、RTX 5090 の 575W や Mac Studio M4 Max の 180W と比べて 1 桁小さい点が、ローカルLLM 性能の天井を決めています。TDP は電源アダプタ接続時のピーク値で、バッテリー駆動時は 15〜25W に下がる挙動が各ベンダーの電源プロファイルで共通です。
対象モデルと量子化
ベンチ対象は現実的に携帯機で動く範囲に絞ります。
| モデル | パラメータ数 | Q4_K_M サイズ | 用途 |
|---|---|---|---|
| Phi-4 mini (3.8B) | 3.8B | 約 2.4GB | 一般対話・コード補助 |
| Llama 3.2 3B | 3.2B | 約 2.0GB | 多言語・軽量チャット |
| Qwen 3 4B | 4.0B | 約 2.5GB | 日本語・ツール呼び出し |
| Gemma 3 4B | 4.3B | 約 2.7GB | マルチモーダル対応版あり |
| Mistral 7B | 7.0B | 約 4.4GB | 下限確認用(携帯機では重い) |
出典: microsoft/Phi-4-mini-instruct モデルカード / meta-llama/Llama-3.2-3B-Instruct / Qwen/Qwen3-4B / google/gemma-3-4b-it / mistralai/Mistral-7B-Instruct-v0.3。
モデル選定の方針は「ローカルLLM モデル選び方ガイド 2026年版」で扱っています。携帯機では RAM の容量よりも「iGPU に割り当てられる UMA VRAM の上限」が実質的な制約になります。35W TDP 機は最大 16GB まで割り当て可能で、7B Q4 の 4.4GB は余裕があるように見えて、コンテキスト 8k で KV cache が 1〜2GB 乗ります。残り帯域と iGPU のメモリ帯域で速度が決まります。
ベンチマーク結果(AC 接続・full power)
Phi-4 mini (3.8B) Q4_K_M
| 機種 | prompt eval (tok/s) | generation (tok/s) | 出典 |
|---|---|---|---|
| ROG Xbox Ally X | 180〜220 | 15〜18 | llama.cpp Issue #10234(Ryzen AI 300 系報告) |
| Lenovo Legion Go 2 | 170〜210 | 14〜17 | r/LocalLLaMA: Legion Go 2 Phi-4 mini run |
| MSI Claw 8 AI+ | 190〜230 | 16〜19 | Phoronix: Lunar Lake iGPU LLM benchmarks |
| Steam Deck OLED | 55〜75 | 5〜7 | r/SteamDeck: llama.cpp Phi-4 mini |
Llama 3.2 3B Q4_K_M
| 機種 | prompt eval (tok/s) | generation (tok/s) |
|---|---|---|
| ROG Xbox Ally X | 200〜240 | 17〜20 |
| Lenovo Legion Go 2 | 190〜230 | 16〜19 |
| MSI Claw 8 AI+ | 210〜250 | 18〜21 |
| Steam Deck OLED | 65〜85 | 6〜8 |
Qwen 3 4B Q4_K_M
| 機種 | prompt eval (tok/s) | generation (tok/s) |
|---|---|---|
| ROG Xbox Ally X | 160〜200 | 13〜16 |
| Lenovo Legion Go 2 | 150〜190 | 12〜15 |
| MSI Claw 8 AI+ | 170〜210 | 14〜17 |
| Steam Deck OLED | 50〜70 | 4〜6 |
Mistral 7B Q4_K_M(下限確認)
| 機種 | prompt eval (tok/s) | generation (tok/s) |
|---|---|---|
| ROG Xbox Ally X | 95〜130 | 7〜10 |
| Lenovo Legion Go 2 | 90〜125 | 6〜9 |
| MSI Claw 8 AI+ | 100〜135 | 8〜11 |
| Steam Deck OLED | 20〜35 | 2〜3 |
数値は公開報告の中央値レンジです。環境(llama.cpp のビルドオプション、Vulkan バックエンドか ROCm か、Intel なら IPEX-LLM か SYCL か、Steam Deck なら SteamOS kernel バージョン)で ±20% 程度は動きます。prompt eval は入力トークンの処理速度、generation はトークン生成速度です。短い入力でチャット的に使う場合は generation 側がユーザー体感を決めます。
バッテリー駆動時の実性能(最重要)
携帯機でローカルLLM を動かすうえで最大の罠は、バッテリー駆動時に iGPU クロックと UMA 帯域が制限されることです。AC 接続時の 60〜70% まで落ちる挙動が各種報告で共通しています。
| モデル | 機種 | AC 接続 (gen tok/s) | バッテリー駆動 (gen tok/s) | 低下率 |
|---|---|---|---|---|
| Phi-4 mini 3.8B | ROG Xbox Ally X | 15〜18 | 9〜12 | 40% 低下 |
| Phi-4 mini 3.8B | MSI Claw 8 AI+ | 16〜19 | 10〜13 | 35% 低下 |
| Llama 3.2 3B | Legion Go 2 | 16〜19 | 10〜13 | 35% 低下 |
| Qwen 3 4B | ROG Xbox Ally X | 13〜16 | 8〜11 | 35% 低下 |
| Mistral 7B | Legion Go 2 | 6〜9 | 2〜3 | 65% 低下 |
| Mistral 7B | Steam Deck OLED | 2〜3 | 動作困難 | — |
出典: r/LocalLLaMA: Battery vs AC inference reports / GPD Win 4 LLM benchmarks (community)。
4B クラスまでならバッテリー駆動でも読める速度(人間の読解速度 5〜10 tok/s を上回る)が維持できます。7B は AC 接続時でぎりぎり、バッテリー駆動では実用の範囲を外れます。
サーマルスロットリング挙動
連続推論を 10〜15 分走らせると、全機種でサーマル制限が入ります。iGPU クロックが低下して tok/sec が初期値の 70〜80% まで落ちる挙動が、Phoronix の Lunar Lake 持続負荷テストや r/LocalLLaMA の Ryzen AI 300 series スレッドで共通して観察されています。短時間の対話(1〜3 分)なら最初の数値が維持されますが、長文生成や連続会話では「後半は失速する」前提で計算してください。
iGPU VRAM 割当の設定ポイント
携帯機は共有メモリ(UMA)構成なので、BIOS や OS 側で iGPU にどれだけメモリを割り当てるかを設定できます。Windows 機(Ally X / Legion Go 2 / Claw 8 AI+)は BIOS で UMA Frame Buffer を 4GB / 8GB / 12GB / 16GB と選択可能、Linux の AMD 機では /sys/class/drm/card0/device/mem_info_vram_total と amdgpu.gttsize パラメータで調整します。
- 3B〜4B Q4 を動かすなら iGPU 割当 8GB で十分: モデル 2.5GB + KV cache 1〜2GB + オーバーヘッド 1GB
- 7B Q4 を試すなら iGPU 割当 12〜16GB: モデル 4.4GB + KV cache 2〜3GB + 余裕 2GB
- Windows + Vulkan バックエンドの llama.cpp では GTT 側のメモリも推論に使えるため、UMA 割当が小さくても動くケースがあります
- 画面側(SteamOS や Windows 側のデスクトップ描画)に 2〜4GB は残しておかないと、推論中に UI がカクつきます
Steam Deck OLED は UMA 割当上限が 4GB と小さいため、3B Q4 でもコンテキストを伸ばせません。4B 以上は原理的に困難です。
用途別の推奨機種
| 用途 | 推奨機種 | 理由 |
|---|---|---|
| 移動中の軽量チャット・翻訳 | ROG Xbox Ally X / MSI Claw 8 AI+ | 4B クラスが実用速度、UMA 16GB |
| 仕事メールの下書き支援 | MSI Claw 8 AI+ | Intel 系の Windows 統合、NPU で Copilot も動く |
| ゲーミング優先・LLM は軽く | Legion Go 2 | OLED と着脱コントローラ、LLM は 3B〜4B 用途 |
| LLM 用途は非推奨 | Steam Deck OLED | 3B 以下でも 5〜8 tok/s、Linux のため環境構築のみ趣味的に |
Snapdragon X2 Elite 搭載の AI PC(薄型ノート)は、NPU の活用度合いで携帯機と似た立ち位置になります。別記事「Snapdragon X2 Elite ノートPC 選び方ガイド 2026年版」で扱っています。NPU 中心のベンチは「Copilot+ PC NPU ローカルLLM ベンチマーク 2026年版」も参考になります。
本格的にローカルLLM を動かすなら母艦が別途必要
携帯機でローカルLLM を動かすのは「移動中の軽い用途」までです。13B 以上のモデルを使いたい、QLoRA で学習させたい、RAG で社内文書を扱いたい、といった本格用途は Strix Halo や Mac Studio、または RTX 5090 搭載デスクトップが現実解になります。詳細は「DGX Spark vs Strix Halo vs Mac Studio 2026 徹底比較」を参照してください。
まとめ
- 携帯機で実用的に動くのは 4B クラスまで。Phi-4 mini / Llama 3.2 3B / Qwen 3 4B / Gemma 3 4B
- AC 接続時で 10〜20 tok/sec、バッテリー駆動時は 60〜70% まで低下
- Mistral 7B はバッテリー駆動では 2〜3 tok/sec、実用の範囲外
- 連続 10〜15 分でサーマルスロットリング発生、長文生成は後半失速
- Steam Deck OLED は Zen2 APU と 4GB UMA 上限で LLM 用途には不向き
- 本格用途は Strix Halo / Mac Studio / RTX 5090 搭載デスクトップへ
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
携帯ゲーミングPC 本体
- ROG Xbox Ally X を Amazon.co.jp で見る
- Lenovo Legion Go 2 を Amazon.co.jp で見る
- Steam Deck OLED を Amazon.co.jp で見る
本格ローカルLLM 用デスクトップ GPU(母艦向け)
Ryzen AI MAX 搭載ミニPC(母艦向け、Strix Halo 系)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート