ローカルLLMの使い道:7Bで何ができるか11題で実測
ローカルLLM 7Bの使い道をQwen2.5の0.5B・1.5B・7Bに11題を4回ずつ出して実測。メール・JSON・計算は7Bで安定、知識と推論は全滅
- #ローカルLLM
- #7B
- #Qwen2.5
- #使い道
- #llama.cpp
- #WebLLM
- #RTX 4070
- #Mac mini
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
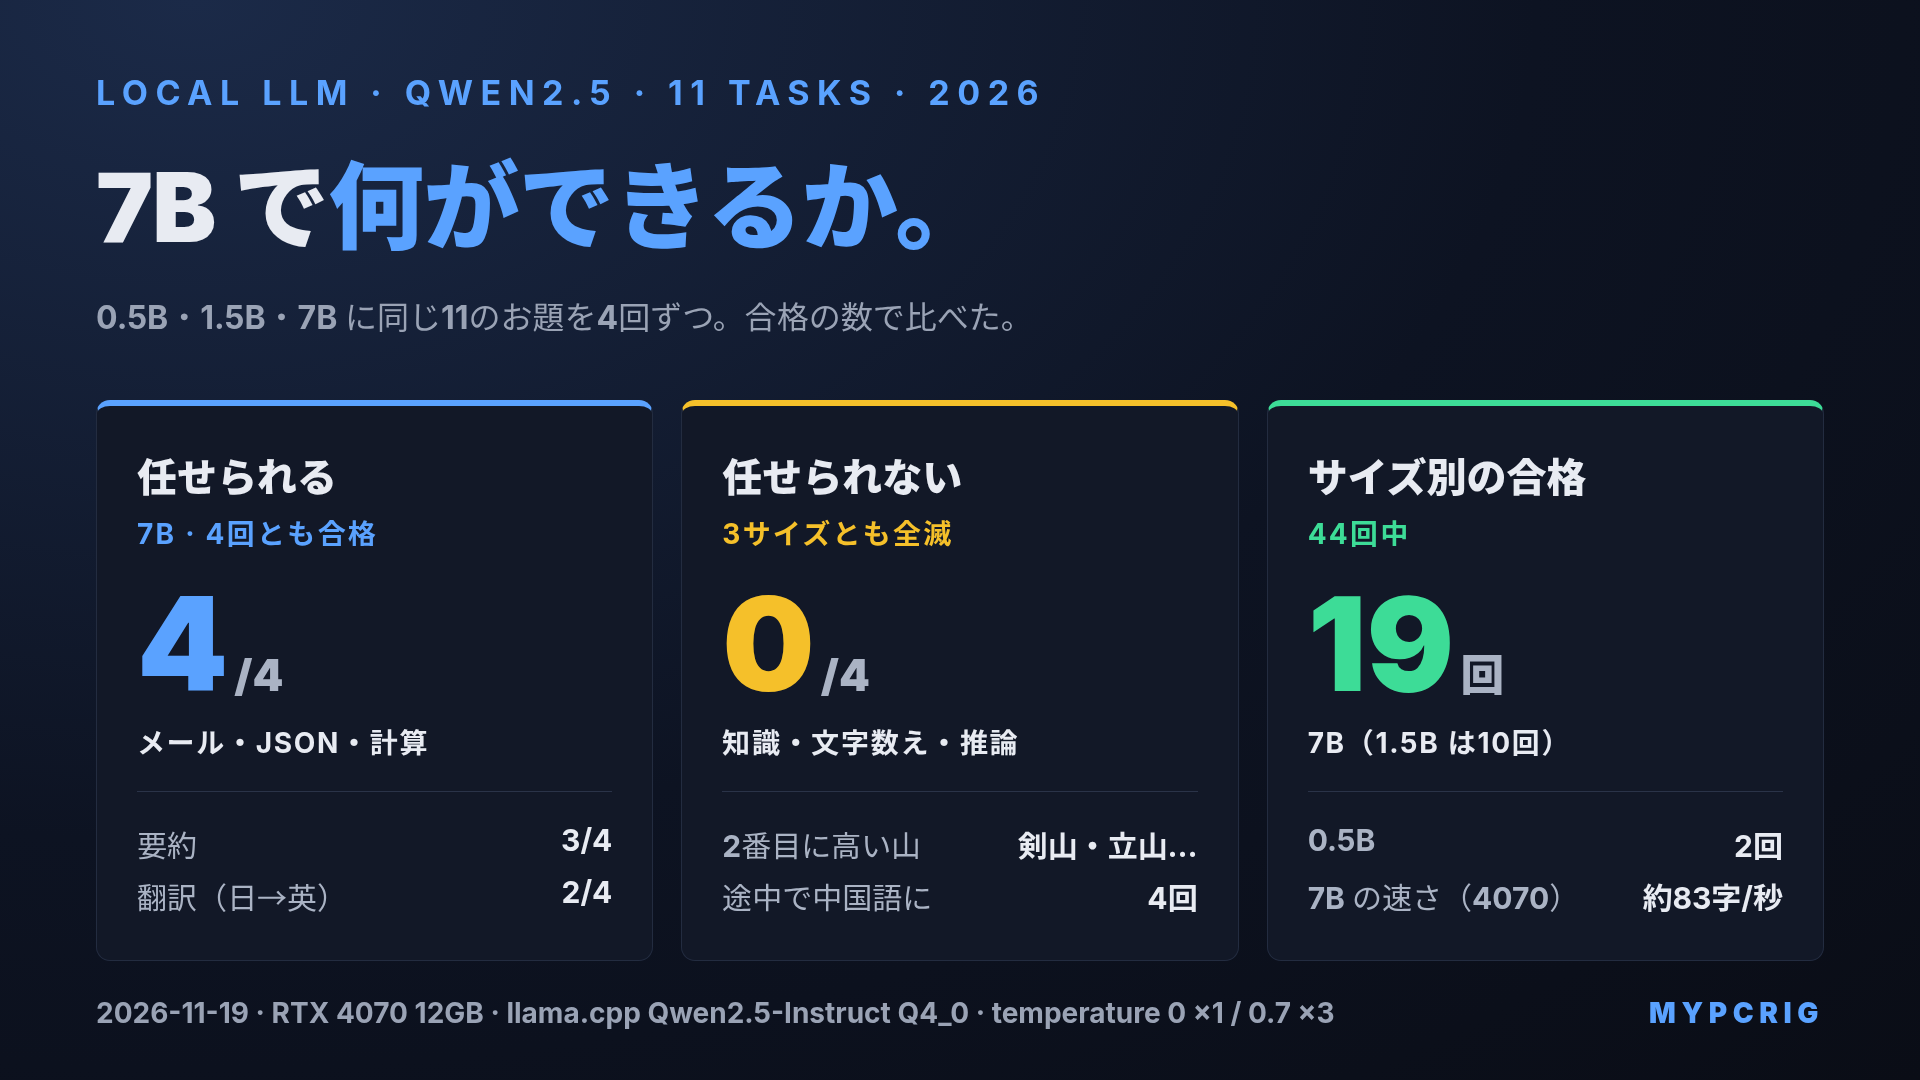
結論:ローカルLLM の 7B は「渡した文章を整える・形を変える」仕事なら任せられます。Qwen2.5 7B(4bit)に11のお題を4回ずつ出すと、お詫びメールの下書き、文章から JSON を取り出す、文章題の計算は4回とも合格しました。一方で、知識の質問・文字数え・条件を組み合わせる推論は4回とも外れ、「日本で2番目に高い山」には剣山や立山と答えました。0.5B と 1.5B は日本語の実用には厳しく、合格は44回中2回と10回でした。
mypcrig の「ブラウザでローカルLLMの速度を測る」では、あなたの PC で 7B が何 tok/s 出るかが分かります。ただ、57 tok/s と出ても、それで何ができるのかは数字だけでは分かりません。
そこで、ツールで選べる3つのサイズ(Qwen2.5-Instruct の 0.5B / 1.5B / 7B)に同じお題を出し、どのサイズで何ができるかを確かめました。モデル名の「7B」が何を表すかは「ローカルLLMのパラメータ数 7B / 13B / 70B とは何か」で説明しています。
同じお題は「ブラウザでローカルLLMと話す」でボタン1つで試せます。インストールは要らず、入力した文章はPCの外に送りません。
試した条件
- 機材: 私の検証機(RTX 4070 12GB)、llama.cpp の
llama-server、GPU に全層を載せる(-ngl 99) - モデル: Qwen2.5-0.5B / 1.5B / 7B-Instruct の GGUF、4bit(Q4_0)。7B は速度比較で使ったものと同じファイルです
- 1つのお題につき4回: 毎回同じ答えになる設定(temperature 0)で1回、ふだんのチャットに近い設定(temperature 0.7)で3回
- お題は11個。7B が得意そうなもの7個と、苦手そうなもの4個です
- 合否の基準は、回す前にお題ごとに決めて書いておきました。答えが1つに決まる7問はプログラムで、要約・翻訳・メール・敬語の4問は基準に沿って読んで判定しています
ブラウザ(WebLLM)で動くモデルは量子化の形式が少し違う(q4f16_1)ので、細かい言い回しまでは一致しません。どのお題が得意かという傾向を見るための結果です。
結果:7B は44回中19回、0.5B は2回
| 分類 | お題 | 0.5B | 1.5B | 7B |
|---|---|---|---|---|
| 得意そう | 要約(3つの箇条書きに) | 0/4 | 0/4 | 3/4 |
| 得意そう | 翻訳(日→英) | 0/4 | 0/4 | 2/4 |
| 得意そう | お詫びメールの下書き | 0/4 | 2/4 | 4/4 |
| 得意そう | 文章から JSON を取り出す | 0/4 | 2/4 | 4/4 |
| 得意そう | レビューの分類(5件) | 0/4 | 0/4 | 1/4 |
| 得意そう | 敬語への書き換え | 0/4 | 1/4 | 1/4 |
| 得意そう | 簡単なコード(Python) | 2/4 | 4/4 | 0/4 |
| 苦手そう | 知識を問う質問 | 0/4 | 0/4 | 0/4 |
| 苦手そう | 計算(文章題) | 0/4 | 1/4 | 4/4 |
| 苦手そう | 文字を数える | 0/4 | 0/4 | 0/4 |
| 苦手そう | 条件を組み合わせる推論 | 0/4 | 0/4 | 0/4 |
| 合計 | 2/44 | 10/44 | 19/44 |
数字は4回中の合格数です。サイズを上げるほど合格が増えますが、7B でも半分に届きません。どのお題で合格し、どこで落ちたかを見ていきます。
7B に任せられること
お詫びメールは4回ともそのまま下書きになる
「取引先の佐藤様に、納品が遅れるお詫びを。当初の納期は11月26日、部品の入荷遅れで新しい納期は11月28日。件名も」と頼みました。7B は4回とも、件名・宛名・お詫び・理由・2つの日付をすべて入れ、再発防止の一文まで付けました。
ただし、架空の社名「株式会社XYZ」を入れた回と、「遅れを oma する」と意味のない語が1つ混ざった回がありました。送る前に読み直す必要はあります。1.5B も1回目はそのまま使える出来でしたが、宛名や旧納期を落とした回が4回中2回ありました。
文章から JSON を取り出すのは4回とも正確
注文メールの文から、氏名・注文日・商品名・個数・合計金額を JSON で取り出させました。7B は4回とも、個数の3と合計の3960を数値で返しました。1.5B は4回中2回、数値を "3,960" のような文字列で返し、0.5B は個数を1と読み違えました。問い合わせメールを表に流し込む、といった定型の作業は 7B から任せられます。
計算は 7B で急に解けるようになる
「1個120円のりんごを7個、85円のみかんを12個。1000円札2枚で払うとおつりは?」(答えは140円)。7B は4回とも、840 + 1020 = 1860、2000 − 1860 = 140 と途中の式を書いて正解しました。1.5B は途中の合計1860円までは合っているのに、4回中2回は最後を「1860 − 1000 × 2 = 860円」と計算し、合格は1回です。
要約は要点を拾うが、数字を落とす
問い合わせ件数が「月400件→900件」に増え、FAQ ページで「600件・返信1日」に改善した、という段落を3つの箇条書きにさせました。7B は3回合格しましたが、合格した回も数字はすべて落とし、「大幅に増加」「減少した」と書きました。もう1回は「月600件減り」と、600件まで減ったことを取り違えています。
1.5B は箇条書きを4つや5つに増やし、本文にない「約500件」を作りました。数字が大事な要約は、7B でも元の文と見比べる必要があります。
7B でも当てにならないこと
知識の質問は4回ともはずれ
「日本で2番目に高い山の名前と標高は?」(北岳、3,193m)。7B の答えは、剣山、高千穂岳、立山、立山でした。剣山と高千穂岳には「2,261m」「1,982m」ともっともらしい標高まで付けています。立山の2回は標高を3,193m と答えており、北岳の標高は覚えているのに、山の名前と結びついていません。1.5B は富士山と答えました。
7B は自信のある文で、所在地や由来まで説明を続けます。事実を答えさせる使い方は避け、調べものは検索か、手元の資料を渡して答えさせる形にしたほうが安全です。
文字を数えられず、途中で中国語になる
「とうきょうとっきょきょかきょく」に「きょ」は何回出てくるか(答えは4回)。7B は 5回、5回、3回、3回と答え、うち3回は中国語かベトナム語で答えました。敬語の書き換えでも1回、途中から中国語に変わっています。
LLM は文字を1文字ずつではなく、まとまり(トークン)で読むので、文字数えは苦手です。中国語への切り替えは、中国語のデータを多く学習した Qwen 系でときどき起こります。
条件を組み合わせる推論は全滅
「A〜D の4人の並び順を、4つの条件から当てる」問題(答えは A→D→C→B)は、3つのサイズとも4回すべて外れました。7B は条件を1つずつ書き出すところまではできますが、「B は A の前にいる」と条件を逆に読み、自分で矛盾する並びを答えます。
結果が悪かった「得意そう」なお題
- コード(7B 0/4): 中身は正しいのですが、4回とも
yieldを使って書き、リストではなくジェネレータを返しました。list()で包めば動きます。「リストを返す」という基準どおりに不合格としています。1.5B は4回ともふつうにリストを返して合格でした - レビューの分類(7B 1/4): 5件のうち「届いてすぐ壊れた」を「わけでもない」と答えるなど、5件中3件しか合わない回が2回、壊れた文字を出して止まった回が1回ありました
- 敬語(7B 1/4): ていねいな文にはなりますが、「ご了承ください」で終わってお詫びが抜けた回が2回ありました
速さに直すと:7B は読むより速く書く
日本語の出力では、Qwen2.5 の1トークンが平均約1.45文字でした。ブラウザ版の速度計測で測った 7B の生成速度に掛けると、こうなります。
| 機材(ブラウザ、7B) | 生成速度 | 文字にすると |
|---|---|---|
| RTX 4070 | 57.2 tok/s | 約83文字/秒 |
| Mac mini(M4 16GB) | 19.5 tok/s | 約28文字/秒 |
大学生200名を調べた研究では、日本語の黙読の速さは平均653字/分(約11文字/秒)、速い人でも1,200字/分(20文字/秒)でした(小林・川嶋 2018)。7B なら Mac mini でも、読むより速く文字が出てきます。上のメールの下書き(約330文字)なら、RTX 4070 で約4秒、Mac mini で約12秒です。
つまり 7B では、返事を書く速さはもう困りごとになりません(長い文章を渡したときの読み込みの時間は、今回は測っていません)。困るのは中身のほうで、上の表のどこまでを任せるかが使い道を決めます。
どのサイズを選ぶか
- 7B が動くなら 7B を使う。 日本語で実用になるのは 7B からです。VRAM は約5GB、目安は VRAM 8GB 以上の GPU か、メモリ16GB の Apple シリコンの Mac です
- 1.5B は、決まった形の短い出力を試す用。 短いコードや定型メールなら当たることもありますが、指示を落とすので、出力は必ず読み直します
- 0.5B は動作確認用。 日本語の文章仕事は任せられません
7B より上を狙うなら、14B 以上のモデルが入る VRAM が必要です。VRAM ごとにどのモデルが入るかは「ローカルLLMのVRAM別モデル早見表」、日本語に強いモデルの比較は「ローカルLLM 日本語性能比較」を見てください。Mac で動かす場合は「Mac mini M4 のローカルLLM実測」にまとめています。
この結果の限界
- お題は11個、各4回です。サイズごとの傾向を見るための確認で、能力を点数で比べるベンチマークではありません
- 採点の4問(要約・翻訳・メール・敬語)は、事前に決めた基準に沿った私の判定です。境界の判断(敬語の「ご了承ください」をお詫びと見なさない、など)は1人の判断です
- 結果は llama.cpp の GGUF(Q4_0)でのものです。ブラウザ版(q4f16_1)では出力の細部が変わります。ブラウザ版の 7B(RTX 4070 の Chrome)でメールと JSON を1回ずつ試すと、メールは合格の水準でしたが、JSON は個数を
"3本"、合計を"3960"と文字列で返し、注文日も2023-11-15と年を補っていました - 試したのは Qwen2.5 だけです。新しい世代のモデルでは、同じ 7B 前後でも結果が変わります
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- ローカルLLMの7Bモデルで何ができますか?
- 手元で Qwen2.5 7B(4bit)に11のお題を4回ずつ出したところ、お詫びメールの下書き、文章から JSON を取り出す、文章題の計算は4回とも合格し、要約も4回中3回合格しました。一方で「日本で2番目に高い山」のような知識の質問、文字数え、条件を組み合わせる推論は4回とも不合格でした。文章を整える・形を変える仕事は任せられ、事実を答えさせる使い方には向きません。
- 0.5B や 1.5B の小さいモデルでも使えますか?
- 日本語の実用には厳しい結果でした。0.5B は44回中2回しか合格せず、要約で本文にない話を作ったり、メールを「AIなので書けない」と断ったりしました。1.5B は44回中10回で、短いコードは4回とも正しく、メールも半分は使える出来でしたが、「3つに」「社内で」といった指示をよく落としました。7B は44回中19回です。
- 7B の生成速度は実用的ですか?
- 日本語では1トークンが約1.45文字でした。ブラウザで測った7Bの生成速度に掛けると、RTX 4070 で約83文字/秒、Mac mini(M4)で約28文字/秒です。大学生200名の黙読の平均は653字/分(約11文字/秒)、速い人でも1,200字/分(20文字/秒)なので、どちらも読む速さより速く文字が出ます。
- ローカルLLMの7Bが日本語の途中で中国語になるのはなぜですか?
- Qwen2.5 は中国語のデータも多く学習しているため、日本語で聞いても途中で中国語に切り替わることがあります。手元では7Bの44回のうち4回、中国語かベトナム語に切り替わりました。4回とも、ふだんのチャットに近い設定(temperature 0.7)の回で、毎回同じ答えになる設定(temperature 0)の11回では起きませんでした。