ローカルLLM KV キャッシュ量子化ガイド 2026年版:llama.cpp / vLLM で KV Cache を Q4 / Q8 に落として VRAM と tok/sec はどう変わるか
llama.cpp の KV cache を q8_0 / q4_0 にした速度・メモリ・精度。Mac mini M4 と RTX 4070 での実測
- #KV Cache
- #量子化
- #llama.cpp
- #vLLM
- #SGLang
- #Ollama
- #Flash Attention
- #Mac mini M4
- #RTX 4070
- #ローカルLLM
- #VRAM
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。

結論:文脈を 16K / 32K に伸ばしたときにメモリを食うのは KV Cache です。llama.cpp で q8_0 にすると KV は FP16 の 53%、q4_0 で 28% になります。メモリが足りている範囲では速度はほぼ変わらず、足りない場面では「載る」ぶん速くなります。Mac mini M4 16GB では Qwen3 14B の 32K が FP16 だと止まり、q8_0 で動くものの swap が出て、q4_0 で swap なしに収まりました。精度は手元の Qwen3 8B / 14B で測ると、q8_0 は Perplexity +0.06% 以下で FP16 と区別がつかず、q4_0 は +0.3〜0.5%(文脈 16K では約 2 倍の +1.05%)でした。gpt-oss-20b は q4_0 で +2.4% と影響が大きく出ます。まず q8_0、それでも足りなければ q4_0、という順に下げるのが無難です。
ローカル LLM のコンテキスト長を伸ばしたら「メモリが足りない」と止まった経験がある方は、多くの場合、原因は KV Cache です。Llama 3.3 70B(GQA・n_kv_heads=8・head_dim=128・n_layers=80)を 128K コンテキストで動かすと、モデル本体(Q4_K_M で約 42.5GB)に加えて KV Cache が FP16 で約 40GiB 必要になり、合計は約 80GiB です。RTX 5090(32GB)では足りず、RTX PRO 6000 Blackwell(96GB)でも残りはわずかです。これを減らすのが KV Cache 量子化で、llama.cpp / vLLM / SGLang / Ollama のそれぞれに実装があります。本記事では設定手順・精度への影響・Flash Attention との関係を実装別に整理し、Mac mini M4 16GB と RTX 4070 12GB で測った値を後半に載せます。数値の出典は、速度・メモリ・精度の実測が「保有実機での実測」の節(手元の 2 台)、K と V を別の型にした精度が llama.cpp の PR #7412 の公開値、KV の容量表が各モデルの config.json からの計算です。vLLM / SGLang / Ollama は手元では測っていません。
用語対応表:cache-type-k / kv_cache_dtype / OLLAMA_KV_CACHE_TYPE
同じ「KV Cache 量子化」でも、バックエンドごとにパラメータ名がバラバラです。最初に対応表を置きます。
| バックエンド | パラメータ | 指定できる値 | Flash Attention 要件 |
|---|---|---|---|
| llama.cpp | --cache-type-k / --cache-type-v | f16 q8_0 q4_0 q4_1 iq4_nl など | K は不要、V は必須(既定の auto なら自動で有効) |
| vLLM | --kv-cache-dtype / kv_cache_dtype | auto(FP16 相当)fp8(= fp8_e4m3)fp8_e5m2 | 内部デフォルト有効 |
| SGLang | --kv-cache-dtype | auto fp8_e5m2 fp8_e4m3 | 内部デフォルト有効 |
| Ollama | OLLAMA_KV_CACHE_TYPE 環境変数(v0.5.0 以降) | f16 q8_0 q4_0 | OLLAMA_FLASH_ATTENTION=1 と組み合わせる |
| Text Generation WebUI | --cache_8bit --cache_4bit(llama.cpp バックエンド時) | フラグ | Exllama v2 は独自 |
llama.cpp の q8_0 / q4_0 は 整数量子化、vLLM / SGLang の fp8_e5m2 / fp8_e4m3 は FP8 浮動小数点 で、仕組みが違います。大きさも少し違い、FP8 は 1 値 8bit でちょうど FP16 の半分ですが、llama.cpp の q8_0 は 32 個ごとに FP16 のスケールを 1 つ持つので 1 値あたり 8.5bit(FP16 の 53%)、q4_0 は 4.5bit(28%)です。
KV Cache の容量式:なぜ 128K で 40GiB になるか
KV Cache の容量は次の式で決まります。
KV Cache 容量 = 2 × n_layers × n_kv_heads × head_dim × context_len × 1 値あたりのバイト数
(FP16 = 2 バイト、q8_0 = 8.5bit ≒ 1.06 バイト、q4_0 = 4.5bit ≒ 0.56 バイト)
「2」は Key と Value の 2 系統ぶんです。GQA(Grouped-Query Attention)採用モデルでは n_kv_heads が n_heads より少ないため、MHA より小さくなります。Llama 3.x / Qwen 3 系はすべて GQA です。
代表モデルで計算した値は次のとおりです。単位は GiB(1GiB = 1,024MiB)、層数などは各モデルの config.json の公開値です。
| モデル | n_layers | n_kv_heads | head_dim | 1 トークンあたり(FP16) | 8K FP16 | 32K FP16 | 128K FP16 | 128K q8_0 | 128K q4_0 |
|---|---|---|---|---|---|---|---|---|---|
| Llama 3.1 8B | 32 | 8 | 128 | 128 KiB | 1.0 | 4.0 | 16.0 | 8.5 | 4.5 |
| Qwen3 14B | 40 | 8 | 128 | 160 KiB | 1.25 | 5.0 | 20.0 | 10.6 | 5.6 |
| Qwen3 32B | 64 | 8 | 128 | 256 KiB | 2.0 | 8.0 | 32.0 | 17.0 | 9.0 |
| Llama 3.3 70B | 80 | 8 | 128 | 320 KiB | 2.5 | 10.0 | 40.0 | 21.3 | 11.3 |
| gpt-oss-20b | 24(うち全文脈を見るのは 12) | 8 | 64 | 24 KiB | 0.19 | 0.75 | 3.0 | 1.6 | 0.84 |
gpt-oss-20b は 24 層のうち半分が直近 128 トークンだけを見る sliding window で、文脈に比例して伸びるのは残り 12 層ぶんだけです。そのため 20B 級でも KV Cache は 8B の 5 分の 1 以下に収まります。
この式は実機のログと一致しました。Mac mini M4 で Qwen3 14B の 32K を動かしたとき、llama.cpp が確保した KV Cache は FP16 で 5,200MiB、q8_0 で 2,762MiB、q4_0 で 1,462MiB でした。llama-bench は積んだ文脈 32,768 に読み込み 512 を足した 33,280 トークン分の文脈を確保するので(n_ctx = 33,280 のログ)、160KiB × 33,280 = 5,200MiB、その 8.5/16 が 2,762MiB、4.5/16 が 1,462MiB で、ログの値どおりです。
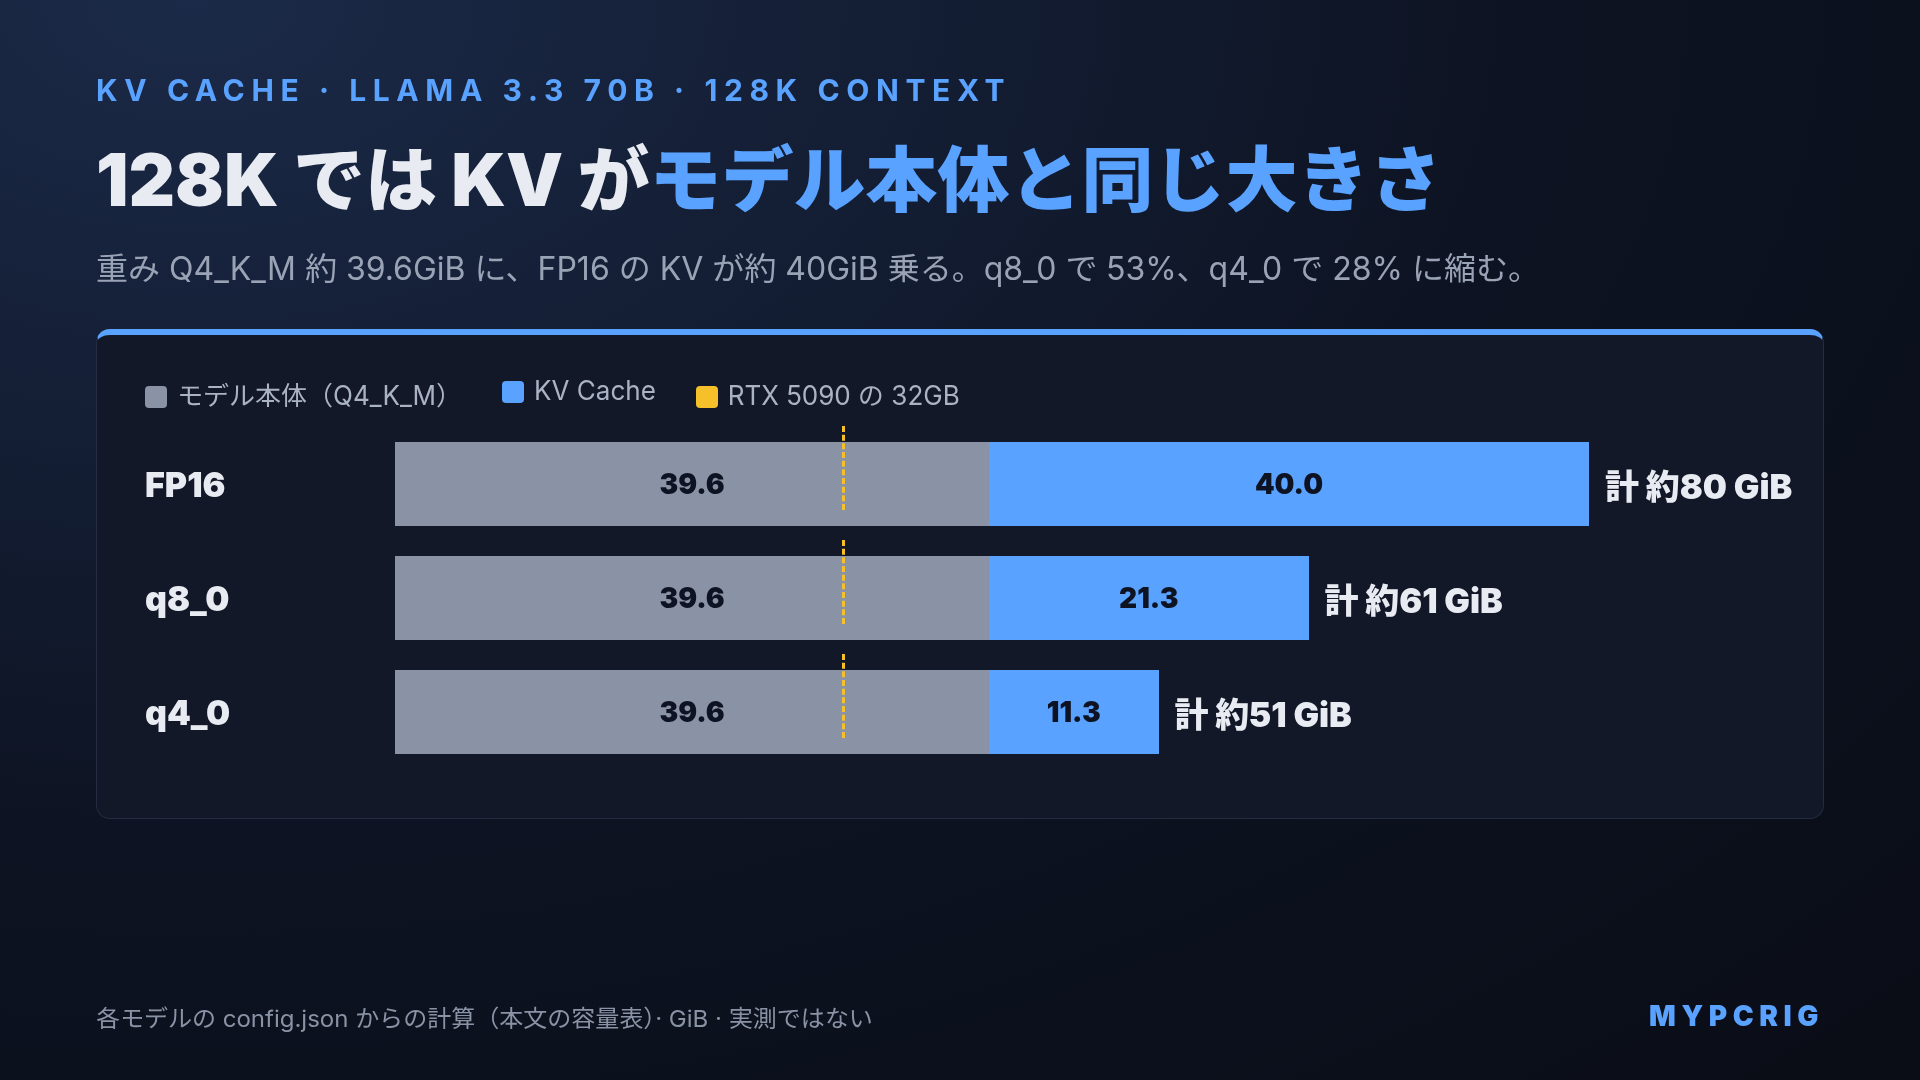
Llama 3.3 70B を 128K コンテキストで回すと、KV Cache だけで 40GiB です。モデル本体(Q4_K_M で約 39.6GiB)を足すと約 80GiB になります。
q8_0 に量子化すれば KV Cache は約 21GiB、q4_0 なら約 11GiB まで減ります。モデル本体を Q4 のままにして長い文脈を使えるかは、この差で決まります。
KV Cache とコンテキスト長の関係の入門は「ローカルLLM のコンテキスト長と VRAM の関係 2026年版」で扱っています。
llama.cpp:—cache-type-k / —cache-type-v と Flash Attention
llama.cpp が最も広く使われている構成なので、まずこれから見ます。設定例は次のとおりです。
# K のみ q8_0(Flash Attention 不要)
./llama-server -m Qwen3-14B-Q4_K_M.gguf \
  --cache-type-k q8_0 \
  -c 32768 -ngl 99 --host 0.0.0.0 --port 8080

# K と V の両方を q8_0(Flash Attention が必要。既定の auto なら自動で有効)
./llama-server -m Qwen3-14B-Q4_K_M.gguf \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --flash-attn on \
  -c 32768 -ngl 99 --host 0.0.0.0 --port 8080

# さらに小さく:K と V の両方を q4_0
./llama-server -m Qwen3-14B-Q4_K_M.gguf \
  --cache-type-k q4_0 --cache-type-v q4_0 \
  --flash-attn on \
  -c 32768 -ngl 99 --host 0.0.0.0 --port 8080
V 側の量子化は Flash Attention が有効なときだけ動く、というのが llama.cpp の実装上の制約です。現行版(コミット cd959bae9 のソースで確認)では --flash-attn(-fa)が on / off / auto の値を取り、既定は auto です。auto のまま V を量子化すると Flash Attention が自動で有効になり、off を明示すると「quantized V cache was requested, but this requires Flash Attention」というエラーで起動が止まります。古い版の --flash-attn(値なし)の書き方は、現行版では値を付けて書きます。
推論チューニング全般(--n-gpu-layers の刻み方、--n-batch の調整、CPU オフロード)は「ローカルLLM 推論チューニングガイド 2026年版」で扱っています。
精度への影響:llama.cpp 開発者の公開値
精度(Perplexity)は、手元の 2 台で測った値を後半の「保有実機での実測」に載せています。ここではまず、K と V を別々の型にした組み合わせまで含む公開値を挙げます。llama.cpp の CUDA 実装を担当している Johannes Gaessler が、2024 年 5 月に GitHub の PR #7412 で、K と V の型の組み合わせごとに Perplexity を測った表を公開しています。モデルのウェイトは FP16 で、モデル名は書かれていません。そこから抜き出したのが次の表です。
| K / V | 1 値あたりのビット数 | Perplexity | FP16 との差 |
|---|---|---|---|
| f16 / f16 | 16 | 6.2322 | 基準 |
| q8_0 / f16 | 12.25 | 6.2331 | +0.01% |
| q8_0 / q8_0 | 8.5 | 6.2344 | +0.03% |
| q8_0 / q4_0 | 6.5 | 6.2541 | +0.35% |
| q4_0 / q8_0 | 6.5 | 6.4181 | +2.98% |
| q4_0 / q4_0 | 4.5 | 6.4384 | +3.31% |
本人の結論は「q8_0 にしても有意な品質の低下は見られない」で、あわせて「K のほうが V より量子化に弱い」と書いています。表でも、同じ 6.5bit でも K を q8_0 に残した組み合わせ(+0.35%)のほうが、K を q4_0 にした組み合わせ(+2.98%)より差が小さくなっています。下げるなら V から、K は q8_0 に残す、という順番がこの表から読めます。
1 つのモデル・1 つのデータセットでの値なので、ほかのモデルや長文の後半での振る舞いにそのまま当てはまるとは限りません。K と V を別々の型にする組み合わせは手元では測っていないので、この表が唯一の根拠です。K / V をそろえた q8_0 / q4_0 の精度と、速度・メモリは、次の節で手元の 2 台で測った値を載せます。
Flash Attention 2 / 3 の内部仕様と KV Cache の関係は「Flash Attention 2 / 3 の中身と何が速くなったのか 2026年版」で扱っています。
保有実機での実測:Mac mini M4 16GB と RTX 4070 12GB
手元の Mac mini M4 16GB(メモリ帯域 120GB/s、Metal が GPU に回せる上限は 12,713MB)と RTX 4070 12GB で、KV Cache の型を変えて速度・メモリと精度(Perplexity と KLD)を測りました。要約やコード生成のような実際のタスクでの出力の品質は比べていません。
速度とメモリの条件:2026-11-13、llama.cpp(コミット cd959bae9、Mac は Metal、4070 は CUDA)、flash attention on、llama-bench で文脈を積んだ後に読み込み 512 トークン(prefill)と生成 128 トークン、2 回平均。モデルは Qwen3 14B Q4_K_M(8.38GiB)と Qwen3 8B Q4_K_M(4.68GiB)。KV の大きさは llama.cpp のログの値です。Mac のメモリは計測中の memory_pressure の空き率の最小値と、vm_stat の swap 書き出し(Swapouts)の増分で見ました。
Mac mini M4 16GB:Qwen3 14B Q4_K_M
| KV | 積んだ文脈 | prefill tok/s | 生成 tok/s | KV の大きさ | 空き率(最小) | swap |
|---|---|---|---|---|---|---|
| FP16 | 0 | 119.5 | 12.0 | 80 MiB | 22% | なし |
| q8_0 | 0 | 120.8 | 11.9 | 42 MiB | 16% | なし |
| q4_0 | 0 | 120.7 | 12.0 | 22 MiB | 16% | なし |
| FP16 | 16K | 68.7 | 8.8 | 2,640 MiB | 5% | あり(約 10GiB 書き出し) |
| q8_0 | 16K | 70.1 | 9.2 | 1,402 MiB | 19% | なし |
| q4_0 | 16K | 69.6 | 9.1 | 742 MiB | 23% | なし |
| FP16 | 32K | 止まる(Metal のメモリ不足) | — | 5,200 MiB | — | — |
| q8_0 | 32K | 50.4 | 7.5 | 2,762 MiB | 5% | あり(約 11GiB 書き出し) |
| q4_0 | 32K | 50.8 | 7.5 | 1,462 MiB | 9% | なし |
FP16 の 32K は、文脈を積む段階で Metal の kIOGPUCommandBufferCallbackErrorOutOfMemory で止まりました。KV だけで 5,200MiB あり、モデルと足すと Metal の上限 12,713MB を超えます。q8_0 と q4_0 では 32K が動きました。ただし q8_0 は空き率が 5% まで下がって swap が出ており、swap なしで収まったのは q4_0 だけです。16GB の Mac で 14B を 32K で使うなら、q4_0 が現実的な線です。
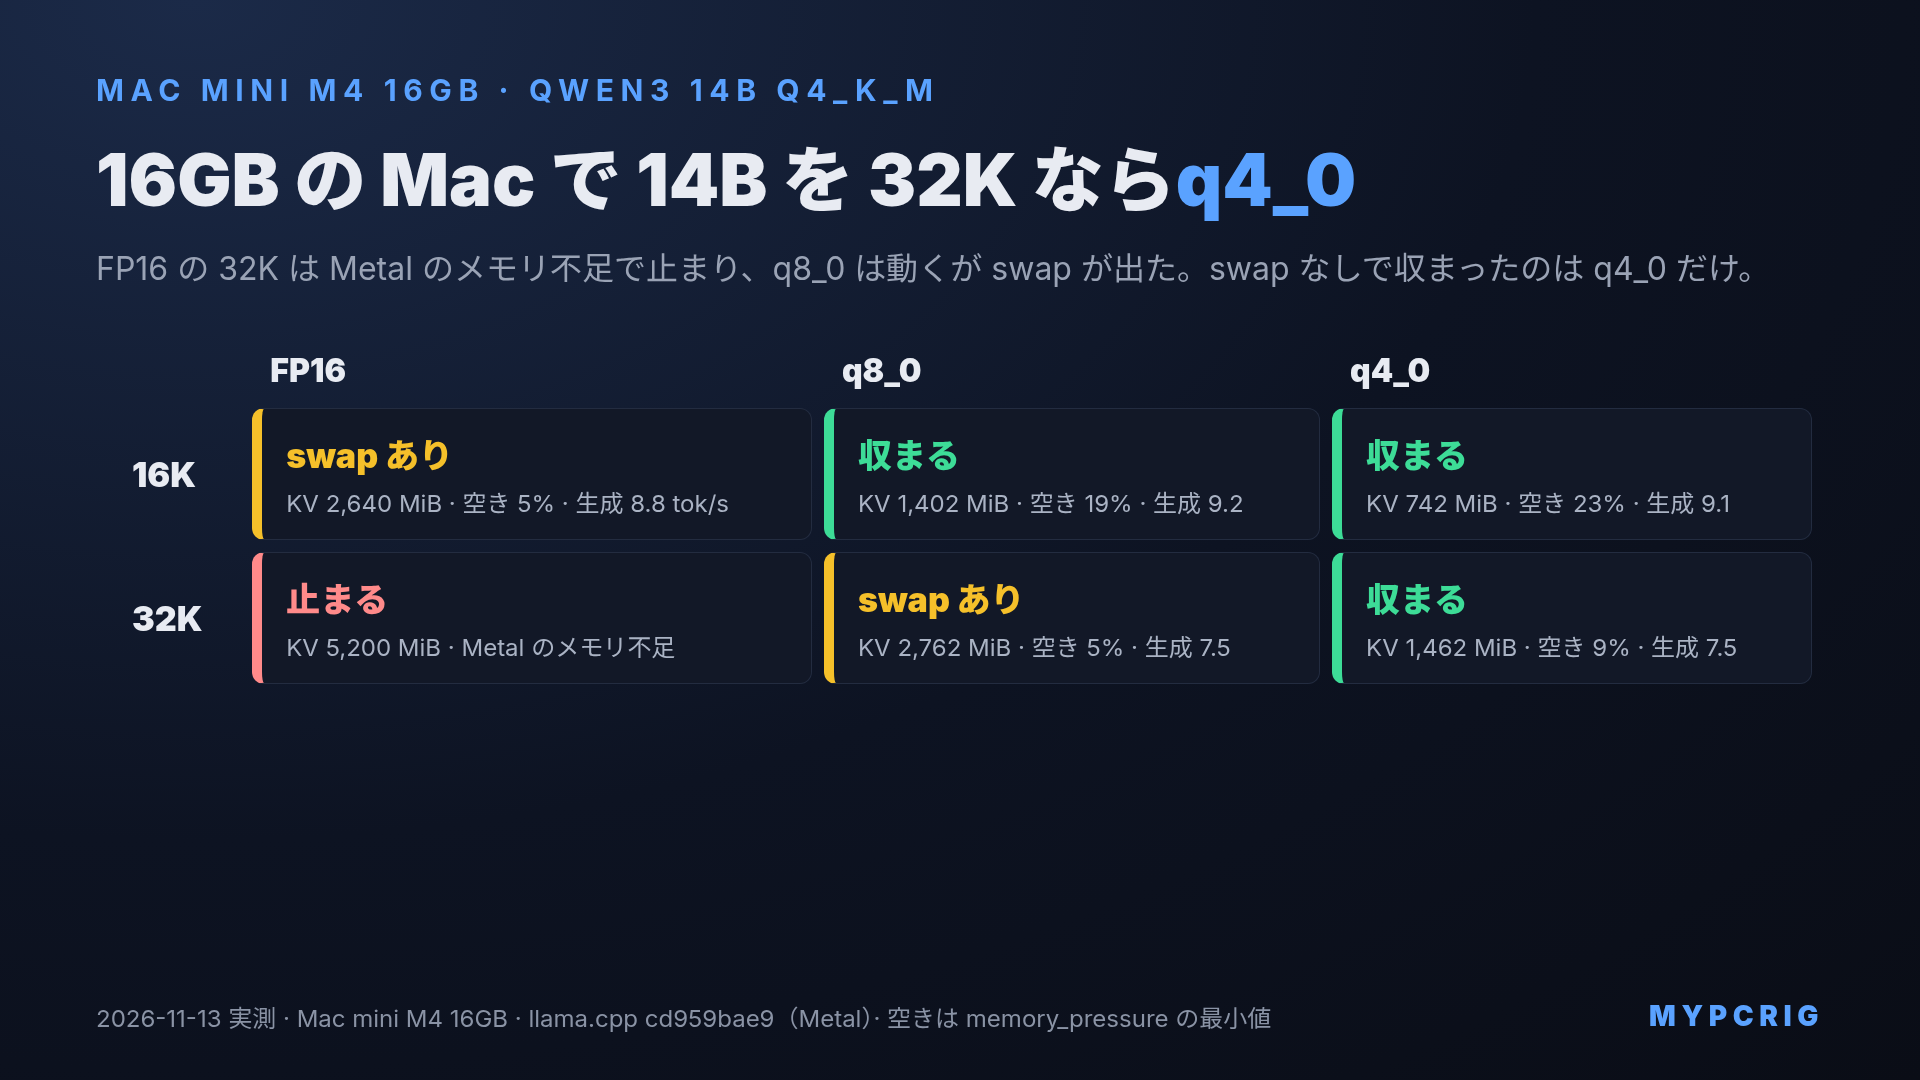
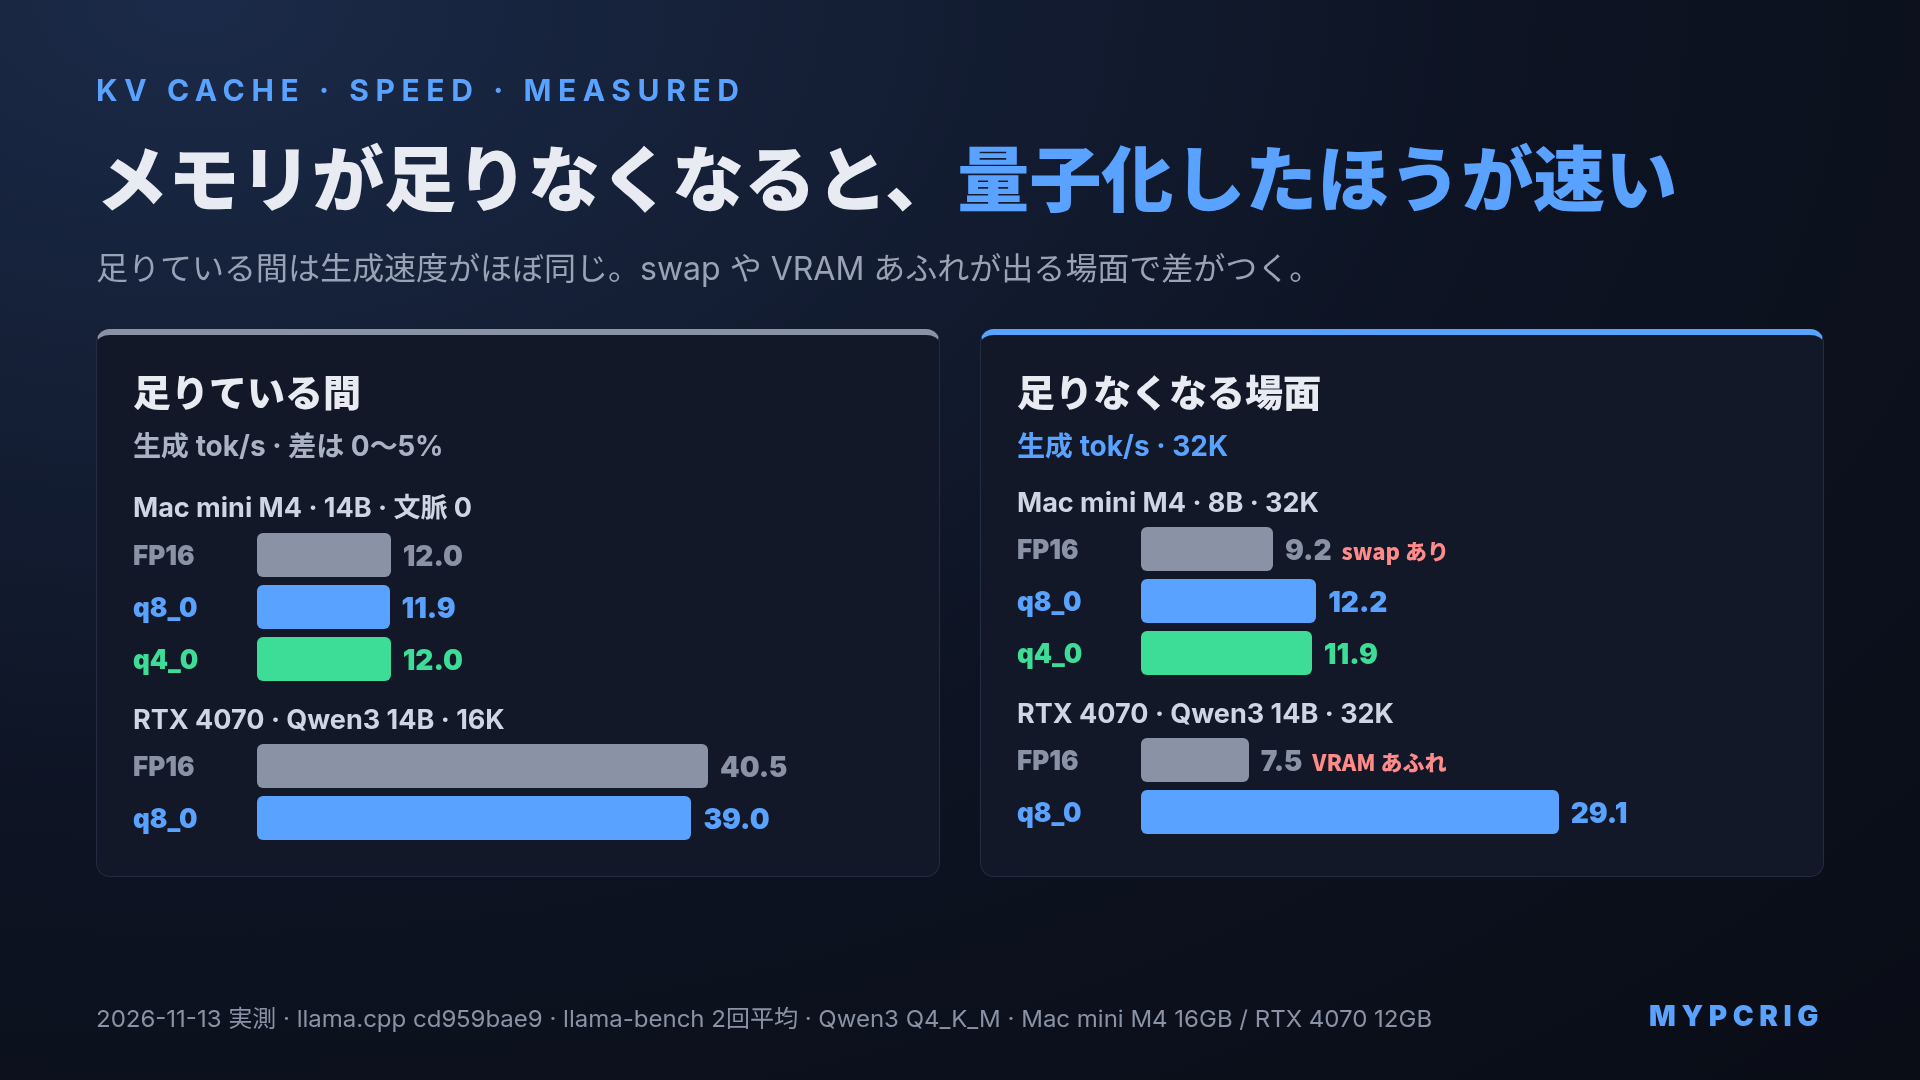
速度は、文脈 0 では KV の型でほとんど変わりません(生成 12.0 / 11.9 / 12.0 tok/s)。KV が小さいうちは、1 トークンごとに読む量のほとんどがモデル本体だからです。32K でも q8_0 と q4_0 は生成 7.5 tok/s で同じでした。
Mac mini M4 16GB:Qwen3 8B Q4_K_M の 32K
| KV | prefill tok/s | 生成 tok/s | KV の大きさ | 空き率(最小) | swap |
|---|---|---|---|---|---|
| FP16 | 77.7 | 9.2 | 4,680 MiB | 9% | あり(約 17GiB 書き出し) |
| q8_0 | 78.8 | 12.2 | 2,486 MiB | 36% | なし |
| q4_0 | 78.7 | 11.9 | 1,316 MiB | 43% | なし |
8B は FP16 でも 32K が動きますが、swap が出ていました。q8_0 にすると swap が消え、生成は 9.2 から 12.2 tok/s に 33% 速くなりました。メモリが足りない場面では、KV を量子化したほうが速くなる例です。prefill はほとんど変わりません。
RTX 4070 12GB:14B の 16K と 32K
同じ llama.cpp のコミットを CUDA でビルドし、Qwen3 14B Q4_K_M と Qwen 2.5 14B Instruct Q4_K_M(bartowski 版)で測りました。VRAM は nvidia-smi で見た計測中の最大値です。
| モデル | KV | 積んだ文脈 | prefill tok/s | 生成 tok/s | VRAM(最大) |
|---|---|---|---|---|---|
| Qwen3 14B | FP16 | 16K | 1,220.8 | 40.5 | 11,526 MiB |
| Qwen3 14B | q8_0 | 16K | 1,169.9 | 39.0 | 10,298 MiB |
| Qwen3 14B | FP16 | 32K | 51.1 | 7.5 | 11,773 MiB(頭打ち) |
| Qwen3 14B | q8_0 | 32K | 698.4 | 29.1 | 11,674 MiB |
| Qwen 2.5 14B | FP16 | 16K | 370.7 | 35.9 | 11,734 MiB |
| Qwen 2.5 14B | q8_0 | 16K | 1,038.9 | 34.2 | 10,552 MiB |
| Qwen 2.5 14B | q8_0 | 32K | 20.1 | 22.2 | 11,799 MiB(頭打ち) |
Qwen3 14B は FP16 の 32K で VRAM からはみ出し、エラーでは止まらずに生成 7.5 tok/s まで落ちました。Windows の共有 GPU メモリ(メインメモリ)に溢れて動き続けたと見ています。q8_0 にすると 32K が VRAM に収まり、29.1 tok/s に戻りました。
Qwen 2.5 14B は 48 層あり、1 トークンあたりの KV が Qwen3 14B の 1.2 倍です。FP16 の 16K ですでに VRAM が上限近くに張り付き、prefill は 2 回の試行で 509 と 233 tok/s とぶれました。q8_0 なら 16K は余裕を持って載りますが、32K は q8_0 でもはみ出し、prefill は 20 tok/s まで落ちました。
足りている範囲での速度の差は小さく、Qwen3 14B の 16K で FP16 40.5、q8_0 39.0 tok/s(4% 遅い)、Qwen 2.5 14B の 16K で 35.9 と 34.2 tok/s(5% 遅い)でした。
精度:Perplexity と KLD(Qwen3 8B / 14B、gpt-oss-20b)
速度とは別に、KV の型で精度がどれだけ変わるかを llama-perplexity で測りました。
条件:2026-11-13、llama.cpp(コミット cd959bae9)、llama-perplexity -fa on -ngl 99。データは wikitext-2-raw の test。文脈 4,096 では 40 チャンク、16,384 では 10 チャンクで、どちらも 163,840 トークンを読んで後半の約 8.2 万トークンで採点します。モデルは Qwen3 8B / 14B Q4_K_M と gpt-oss-20b(MXFP4)。「FP16 比」は同じ機材・同じモデル・同じ文脈の FP16 に対する Perplexity の増分です。「KLD」は FP16 の実行で保存した出力の確率分布に対するトークンごとの KL ダイバージェンスの平均、「top-1 一致」は最も確率の高いトークンが FP16 と同じだった割合です。
| 機材 | モデル | 文脈 | KV | Perplexity | FP16 比 | 平均 KLD | top-1 一致 |
|---|---|---|---|---|---|---|---|
| RTX 4070 | Qwen3 8B | 4,096 | FP16 | 8.3432 | 基準 | — | — |
| RTX 4070 | Qwen3 8B | 4,096 | q8_0 | 8.3445 | +0.015% | 0.000620 | 98.93% |
| RTX 4070 | Qwen3 8B | 4,096 | q4_0 | 8.3866 | +0.520% | 0.025987 | 93.85% |
| RTX 4070 | Qwen3 14B | 4,096 | FP16 | 7.1877 | 基準 | — | — |
| RTX 4070 | Qwen3 14B | 4,096 | q8_0 | 7.1919 | +0.058% | 0.000397 | 99.12% |
| RTX 4070 | Qwen3 14B | 4,096 | q4_0 | 7.2146 | +0.374% | 0.012666 | 95.27% |
| RTX 4070 | Qwen3 8B | 16,384 | FP16 | 7.6599 | 基準 | — | — |
| RTX 4070 | Qwen3 8B | 16,384 | q8_0 | 7.6621 | +0.029% | 0.000599 | 98.90% |
| RTX 4070 | Qwen3 8B | 16,384 | q4_0 | 7.7405 | +1.052% | 0.022703 | 93.98% |
| RTX 4070 | gpt-oss-20b | 4,096 | FP16 | 1836.79 | 基準 | — | — |
| RTX 4070 | gpt-oss-20b | 4,096 | q8_0 | 1845.98 | +0.501% | 0.047647 | 88.27% |
| RTX 4070 | gpt-oss-20b | 4,096 | q4_0 | 1881.49 | +2.434% | 0.301466 | 63.89% |
| Mac mini M4 | Qwen3 8B | 4,096 | FP16 | 8.3393 | 基準 | — | — |
| Mac mini M4 | Qwen3 8B | 4,096 | q8_0 | 8.3391 | -0.003% | 0.000125 | 99.61% |
| Mac mini M4 | Qwen3 8B | 4,096 | q4_0 | 8.3801 | +0.490% | 0.024796 | 93.79% |
| Mac mini M4 | Qwen3 14B | 4,096 | FP16 | 7.1861 | 基準 | — | — |
| Mac mini M4 | Qwen3 14B | 4,096 | q8_0 | 7.1864 | +0.004% | 0.000052 | 99.72% |
| Mac mini M4 | Qwen3 14B | 4,096 | q4_0 | 7.2057 | +0.273% | 0.011921 | 95.32% |
q8_0 は、Qwen3 では Perplexity の増分が +0.06% 以下で、Mac では FP16 と区別がつきません(8B -0.003%、14B +0.004%)。q4_0 は文脈 4,096 で +0.3〜0.5% です。14B のほうが 8B より影響が小さく、4070 で +0.37% 対 +0.52%、Mac で +0.27% 対 +0.49% でした。
文脈を伸ばすと q4_0 の影響は大きくなります。Qwen3 8B の q4_0 は文脈 4,096 で +0.52%、16,384 で +1.05% と約 2 倍です。一方で KLD と top-1 一致は 4,096 と 16,384 でほとんど変わらないので(0.026 と 0.023、93.85% と 93.98%)、1 トークンごとのずれ方は同じでも、長い文脈の後半で正解トークンの確率を下げる方向に効いている、と読んでいます。1 モデル 1 回の観測です。
gpt-oss-20b は KV の量子化に弱く出ました。q8_0 でも KLD 0.048・top-1 一致 88% で、Qwen3 の q4_0 よりずれが大きく、q4_0 では Perplexity +2.4%・top-1 一致 64% です。ただし gpt-oss-20b はチャット形式の入力を前提にしたモデルで、wikitext のような生のテキストでは Perplexity が 1,837 と極端に高く出ます。予測の分布が平らなぶん KLD や top-1 が動きやすい可能性があり、この表だけで「gpt-oss では KV を量子化できない」とは言えません。使うなら q8_0 にとどめるのが無難です。
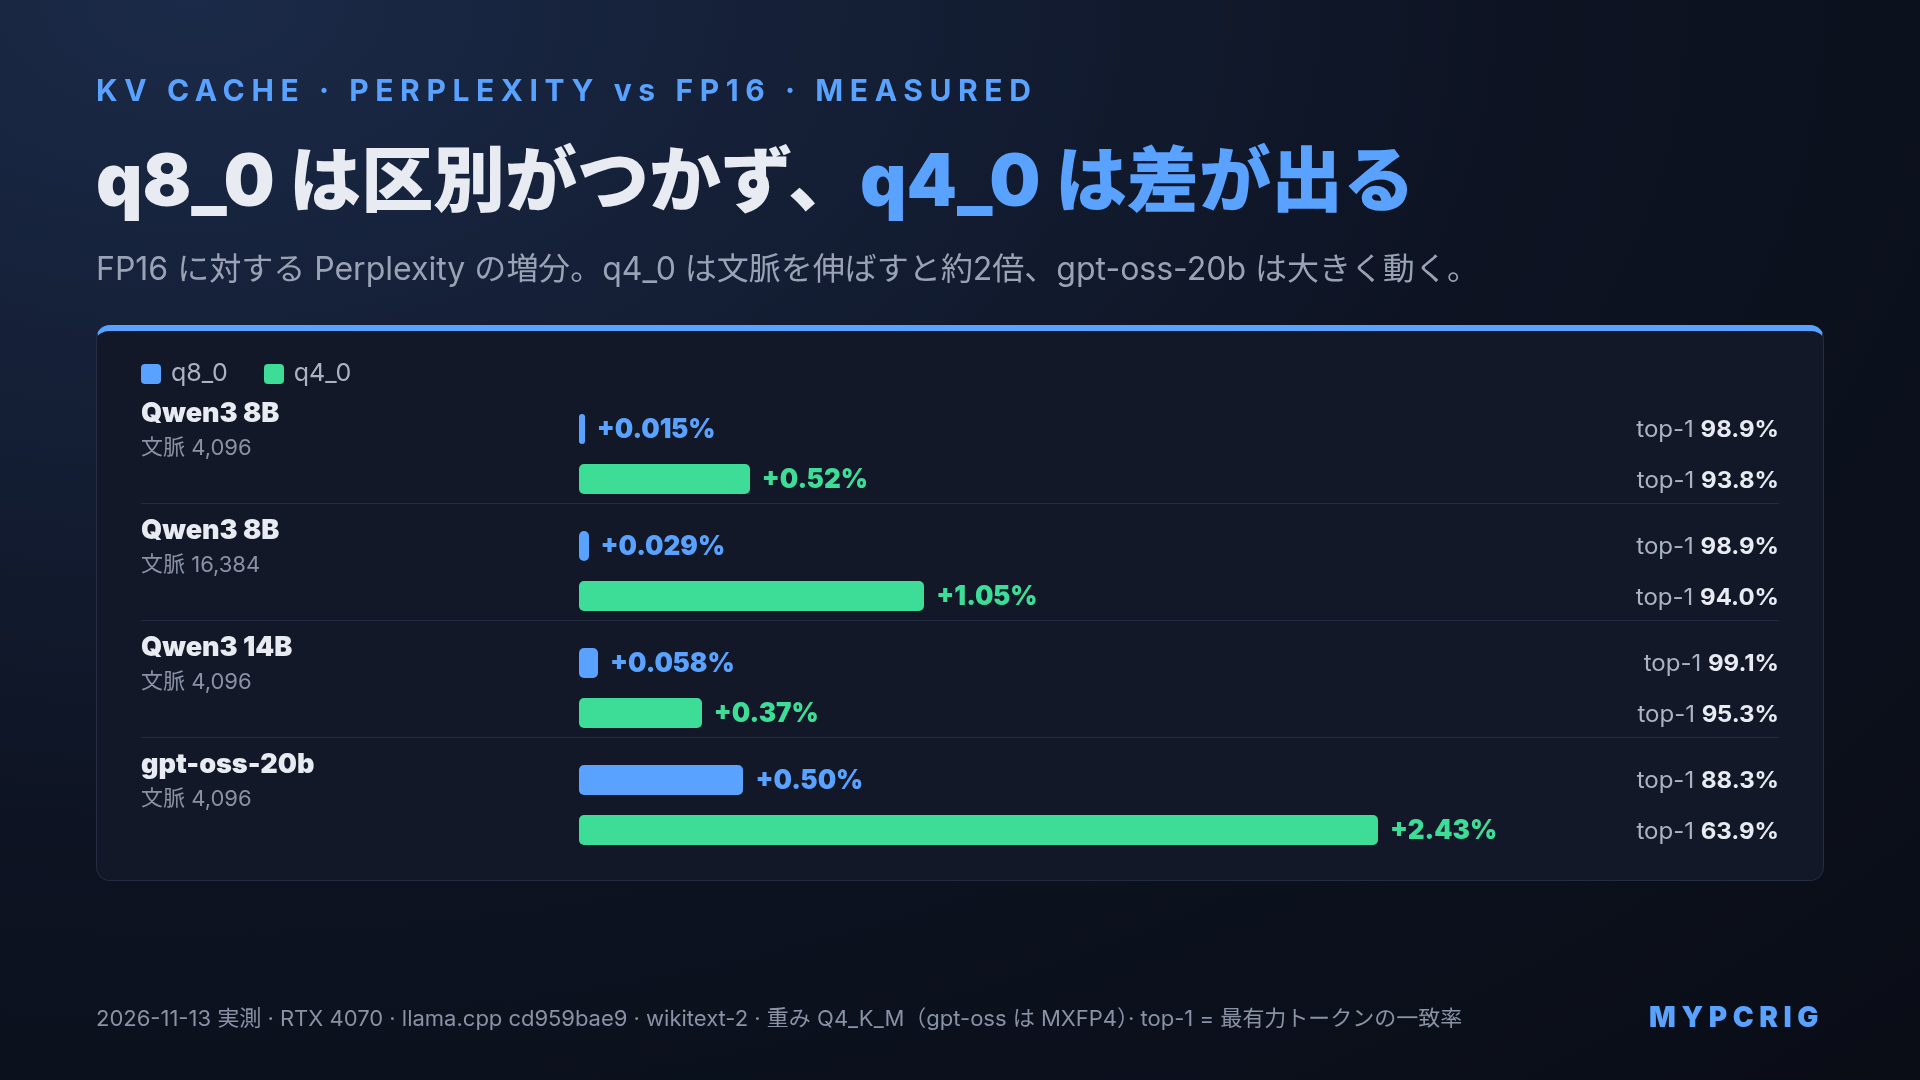
同じ GGUF でも、Mac と 4070 の値は完全には一致しません。FP16 どうしで Mac が 0.047% 低く出ました。同じ 4070 で FP16 を 2 回回すと値はほぼ完全に一致したので(Perplexity 同値、KLD 0.000000)、乱数のぶれではなく Metal と CUDA の計算の違いです。それでも FP16 比で見た q4_0 の劣化は両機で近く、q8_0 は誤差の範囲・q4_0 は 8B で約 +0.5%、14B で +0.3〜0.4%、という結論は機材によりません。
メモリの節約は、文脈 16,384 の Qwen3 8B で VRAM の最大が FP16 7,474 MiB、q8_0 6,398 MiB、q4_0 5,822 MiB でした。文脈 4,096 では 0.2〜0.5GB しか変わらないので、精度を少し払ってでも量子化する意味があるのは文脈が長いときです。
公開値と並べる
| K / V | 公開値(PR #7412)FP16 比 | 公開値 KLD | 手元 Qwen3 8B(4070 / Mac)FP16 比 | 手元 KLD(4070 / Mac) |
|---|---|---|---|---|
| q8_0 / q8_0 | +0.035% | 0.000980 | +0.015% / -0.003% | 0.000620 / 0.000125 |
| q4_0 / q4_0 | +3.31% | 0.036509 | +0.520% / +0.490% | 0.025987 / 0.024796 |
q8_0 はどちらも「FP16 と区別がつかない」水準で一致します。q4_0 は手元の Perplexity の増分が公開値の 6 分の 1 程度ですが、KLD は 0.026 と 0.037 で近い値です。条件はかなり違います。公開値はウェイトが FP16 でモデル名と文脈長の記載がなく(FP16 の Perplexity 6.23 から LLaMA 系と推測されますが未確認)、llama.cpp も 2024 年 5 月の試作です。手元はウェイトが Q4_K_M の Qwen3 です。重みの量子化で既に FP16 の重みから離れているぶん、KV の量子化で上乗せされる差が小さく見えている可能性がありますが、ウェイト FP16 の Qwen3 は測っていないので確かめていません。
測っていないものも書いておきます。Mac の gpt-oss-20b と文脈 16,384、4070 の 14B と gpt-oss の文脈 16,384、K と V を別々の型にする組み合わせ、要約やコードなど実際のタスクでの品質です。
128K:Qwen3 の 4B / 8B は q4_0 でないと載らない
文脈を 128K まで伸ばした結果も、同じ 2 台で取りました(llama-server で文脈いっぱいを読ませてから 128 トークン生成、Q4_K_M、全層 GPU、各 1 回。Mac は 2026-11-14、4070 は 2026-11-17)。
| モデル | KV | Mac mini M4 16GB | RTX 4070 12GB |
|---|---|---|---|
| Qwen3 4B | q4_0 | 動作(生成 5.6 tok/s) | 動作(生成 21.6 tok/s、VRAM 最大 8,751 MiB) |
| Qwen3 4B | q8_0 | 起動直後に Metal のメモリ不足で失敗 | VRAM からあふれ、読み込みが 83% のところで止めた |
| Qwen3 8B | q4_0 | 動作(生成 5.1 tok/s) | 動作(生成 20.1 tok/s、VRAM 最大 10,829 MiB) |
| Qwen3 8B | q8_0 | 起動直後に Metal のメモリ不足で失敗 | VRAM からあふれ、読み込みが 28% のところで止めた |
32K までは「まず q8_0」で足りていましたが、12GB と 16GB で Qwen3 を 128K まで伸ばすと、q8_0 では 4B でも収まらず、q4_0 が必須になりました。q4_0 の精度の増分は文脈 16K の 8B で +1.05% だったので、128K ではそれより大きい可能性がありますが、128K の Perplexity は測っていません。詳しい表は「ローカルLLM のコンテキスト長と VRAM の関係」に載せています。
2 台の結果から言えること
- メモリが足りている間は、KV の型で生成速度はほとんど変わらない(Mac で差なし、4070 で q8_0 が 4〜5% 遅い)
- 足りなくなる場面では、量子化したほうが速い。Mac の 8B 32K は 9.2 → 12.2 tok/s、4070 の Qwen3 14B 32K は 7.5 → 29.1 tok/s
- 精度は、Qwen3 なら q8_0 で FP16 と区別がつかず(+0.06% 以下)、q4_0 で +0.3〜0.5%。文脈 16K では q4_0 の増分が約 2 倍になる
- gpt-oss-20b は KV の量子化で精度が動きやすい(q4_0 で +2.4%、top-1 一致 64%)
- 16GB の Mac で 14B を 32K で使うなら q4_0。q8_0 は動くが swap が出た
- 12GB の GPU で 14B を 32K で使えるかはモデル次第。Qwen3 14B は q8_0 で載り、Qwen 2.5 14B は q8_0 でもはみ出した
- 128K は、12GB の 4070 でも 16GB の Mac でも、Qwen3 4B / 8B が載るのは q4_0 のときだけだった
モデルごとの tok/s の全体像は「Mac mini M4 / M4 Pro でローカルLLMはどこまで動くか」と「RTX 5060 Ti 16GB vs RTX 5070 12GB でローカルLLM はどっちを買うべきか」に、同じ 2 台で測った値を載せています。
vLLM:kv_cache_dtype=“fp8_e5m2” / “fp8_e4m3” の違い
vLLM は本番運用向けのバックエンドです。FP8 KV Cache が Hopper / Ada Lovelace / Blackwell 世代でハードウェア加速されます。CLI での指定は次のとおりです。
# vLLM のオンライン推論サーバー起動時
vllm serve meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --max-model-len 131072 \
  --kv-cache-dtype fp8_e5m2 \
  --gpu-memory-utilization 0.92
Python API から呼ぶ場合は LLM(model=..., kv_cache_dtype="fp8_e5m2") です。
fp8_e5m2 と fp8_e4m3 のどちらを選ぶか
FP8 には 2 種類あります。e5m2(指数 5bit、仮数 2bit)と e4m3(指数 4bit、仮数 3bit)です。
- fp8_e5m2:ダイナミックレンジが広い(±57344 まで表現可)、仮数の解像度が粗い。スケール係数を用意しなくても値が収まりやすい
- fp8_e4m3:ダイナミックレンジが狭い(±448 まで)、仮数の解像度が細かい。スケーリング係数の調整が必要で、llm-compressor などで事前にキャリブレーションされたスケールがモデルに同梱されていると精度が出やすい
なお --kv-cache-dtype fp8 と書いた場合は fp8_e4m3 になります。スケール係数を用意していないモデルでは fp8_e5m2 が扱いやすい、というのが使い分けの目安です。
fp8_e4m3 は DeepSeek / Mistral などのモデル配布時に scale が公開されている構成で、より高い精度を狙う時に選びます。
vLLM FP8 と Ampere(A100 / RTX 3090)の落とし穴
FP8 演算のハードウェア加速は Hopper(H100 / H200)、Ada Lovelace(L40S / RTX 4090)、Blackwell(RTX 5090 / RTX PRO 6000 Blackwell)で入っています。Ampere 世代(A100 / RTX 3090 / RTX A6000)では FP8 のハードウェア命令がなく、内部で FP16 にプロモートされて計算されます。結果として:
- VRAM 節約効果はある(KV Cache 自体は FP8 で保存される)
- tok/sec は下がる(FP16 プロモート分のオーバーヘッド)
Ampere で「vLLM FP8 KV Cache を試したら遅くなった」は既知の挙動です。
Ampere 世代なら kv_cache_dtype=auto(FP16)のままで良い、というのが実運用の判断です。
SGLang:—kv-cache-dtype fp8_e5m2 と RadixAttention
SGLang は vLLM に近い API です。RadixAttention によるプレフィックス共有が特徴です。KV Cache 量子化の指定は vLLM とほぼ同じです。
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.3-70B-Instruct \
  --tp 2 \
  --context-length 131072 \
  --kv-cache-dtype fp8_e5m2
RadixAttention のプレフィックス共有と FP8 KV Cache は独立して動作します。
プレフィックス共有によってヒットしたキャッシュも FP8 で保存されるので、複数リクエストが同じシステムプロンプトを使う構成では VRAM の合計消費が明確に下がります。
Ollama:OLLAMA_KV_CACHE_TYPE 環境変数
Ollama は v0.5.0(2024 年 12 月)で環境変数指定に対応しました。CLI に組み込みのフラグはありません。systemd や Docker の起動時に環境変数を渡す運用です。
# systemd の場合
sudo systemctl edit ollama
# 以下を追記
# [Service]
# Environment="OLLAMA_KV_CACHE_TYPE=q8_0"
# Environment="OLLAMA_FLASH_ATTENTION=1"

sudo systemctl restart ollama

# Docker の場合
docker run -d \
  -e OLLAMA_KV_CACHE_TYPE=q8_0 \
  -e OLLAMA_FLASH_ATTENTION=1 \
  -p 11434:11434 \
  ollama/ollama
v0.5.0 のリリースノートでは OLLAMA_FLASH_ATTENTION=1 と組み合わせる手順が示されています。KV の量子化は Flash Attention が前提なので、2 つをセットで設定してください。
Open WebUI / LibreChat のような UI 側から切り替えることはできず、モデル単位の細かい制御もできない、というのが llama.cpp 直叩きとの違いです。日常運用で「モデルごとに切り替えなくていい」場合は Ollama で十分です。モデルごとに Q8 / Q4 / f16 を出し分けたい構成なら llama.cpp サーバーを直接立てるほうが柔軟です。
Q8 と Q4、どちらまで下げるか:判断表
用途別の判断軸を 1 枚に集約します。
| 用途 | 推奨 KV dtype | 理由 |
|---|---|---|
| メモリに余裕がある(モデル + KV が上限の 8 割未満) | f16 のまま | 速度も精度も変わらないので、下げる理由がない |
| 境目に近い(swap が出る、VRAM が頭打ちになる) | q8_0 K + q8_0 V | KV は 53% に。手元の Qwen3 で Perplexity +0.06% 以下(公開値 +0.03%)、swap が消えて速くなった |
| q8_0 でも収まらない(16GB Mac で 14B を 32K など) | K q8_0 + V q4_0、それでも足りなければ q4_0 / q4_0 | K を残すほうが劣化が小さい(公開値 +0.35% と +3.31%)。q4_0 / q4_0 は手元の Qwen3 で +0.3〜0.5%、文脈 16K で約 +1% |
| gpt-oss-20b | q8_0 まで | KV が小さく量子化の効きが薄いうえ、手元では q4_0 で Perplexity +2.4%・top-1 一致 64% |
| 本番 API 代替、複数リクエスト並列 | vLLM fp8_e5m2 | Hopper / Ada / Blackwell 世代は FP8 をハードウェアで扱える |
| Ampere 世代(A100 / RTX 3090)で vLLM | auto(FP16)のまま | FP8 のハードウェア命令が無く、量子化しても速くはならない |
モデルウェイトの量子化フォーマット(GGUF Q4_K_M / GPTQ / AWQ / EXL2)と KV Cache 量子化は別軸です。ウェイト側の量子化整理は「ローカル LLM 量子化フォーマット徹底解説 2026年版」で扱っています。
モデルのウェイトを Q4_K_M などで小さくしたうえで、それでも長い文脈が載らないときに KV を q8_0 に下げる、という順番が扱いやすいです。
トラブルシューティング:起動時にエラーが出る 3 パターン
実運用で遭遇する典型的なエラーです。
- llama.cpp で
--cache-type-v q8_0を指定して起動時にエラー:--flash-attn offを指定しています。V 側の量子化は Flash Attention が必要なので、onか既定のautoにしてください - vLLM で
kv_cache_dtype=fp8_e5m2を指定して tok/sec が下がる:Ampere 世代の GPU です。nvidia-smi --query-gpu=name --format=csvで Compute Capability を確認し、8.9(Ada)以上でないと FP8 加速はありません - Ollama で
OLLAMA_KV_CACHE_TYPE=q8_0が効かない:v0.5.0 未満です。ollama --versionで確認し、v0.5.0 以降にアップデートしてください
3 番目の Ollama は既定が f16(FP16)なので、環境変数を設定していなければ KV Cache は圧縮されていません。「Ollama で VRAM が足りない」と感じたら、まず OLLAMA_KV_CACHE_TYPE=q8_0 OLLAMA_FLASH_ATTENTION=1 を試すのが最短ルートです。
まとめ:足りなくなったら q8_0、それでも足りなければ q4_0
KV Cache の量子化は、メモリが足りている間は速度をほとんど変えず、足りなくなったときに効きます。Mac mini M4 16GB では、Qwen3 8B の 32K が q8_0 で swap が消えて 9.2 から 12.2 tok/s になり、Qwen3 14B の 32K は FP16 で止まっていたものが q4_0 で swap なしに動きました。RTX 4070 12GB でも、Qwen3 14B の 32K が q8_0 で VRAM に収まり 7.5 から 29.1 tok/s に戻っています。
精度は、手元の Qwen3 8B / 14B で q8_0 が Perplexity +0.06% 以下、q4_0 が +0.3〜0.5% でした。q8_0 は FP16 と区別がつかないので最初に試す値として扱いやすく、q4_0 は文脈 16K で増分が約 2 倍(+1.05%)になるので、「q8_0 では収まらない」ときに使うのが無難です。gpt-oss-20b は q4_0 で +2.4% と影響が大きく、q8_0 までにとどめます。公開値(PR #7412)によれば、下げるなら V から下げ、K は q8_0 に残すほうが劣化は小さく済みます。
FP8(vLLM / SGLang)は Hopper / Ada Lovelace / Blackwell 世代で使うと最速の選択肢になりますが、Ampere 世代では逆に遅くなる、という世代依存があります。GPU の Compute Capability を確認してから採用してください。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
長い文脈を KV Cache の量子化と組み合わせて扱う構成の例です。
価格の注記(2026 年 8 月実測): Amazon.co.jp の RTX 5090 単体は第三者出品者によるマーケットプレイス出品が中心で、上位掲載の実売価格は 86〜90 万円台でした(ASUS TUF / ROG Astral、出品者 B&T)。PC 専門店やメーカー直販の価格も確認してから判断してください。
- GeForce RTX 5090(32GB)を Amazon.co.jp で探す — 32B クラスの Q4_K_M を長い文脈で回すコンシューマ最上位(70B の Q4_K_M は約 42.5GB で単体には載りません)
- Mac mini M4 24GB を Amazon.co.jp で探す — 16GB では 14B の 32K が q4_0 でぎりぎりだったので、14B を長い文脈で使うなら 24GB 以上
- GMKtec EVO-X2(Ryzen AI Max+ 395 / 128GB / 2TB)を Amazon.co.jp で見る — 96GB を VRAM に割り当てられる Strix Halo ミニPC、70B / 120B を 128K で常用したい向け
RTX PRO 6000 Blackwell(96GB)は国内 Amazon での取扱が安定していないため、パソコン工房・ドスパラなどの法人向け窓口で見積り購入するのが確実です。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- KV Cache 量子化で tok/sec はどれくらい落ちますか?
- メモリが足りている範囲では、ほとんど変わりません。Mac mini M4 16GB で Qwen3 14B Q4_K_M を測ると、文脈 0 の生成は FP16 / q8_0 / q4_0 で 12.0 / 11.9 / 12.0 tok/s でした。RTX 4070 12GB の文脈 16K では FP16 40.5、q8_0 39.0 tok/s で、q8_0 のほうが 4% 遅い程度です。逆にメモリが足りない場面では、量子化したほうが速くなります。Mac の Qwen3 8B 32K は FP16 だと swap が出て 9.2 tok/s、q8_0 で 12.2 tok/s。4070 の Qwen3 14B 32K は FP16 だと VRAM からはみ出して 7.5 tok/s、q8_0 で 29.1 tok/s でした。
- KV Cache 量子化で精度(Perplexity)はどれくらい悪化しますか?
- Qwen3 8B / 14B(重み Q4_K_M)を wikitext-2 で測ったところ、q8_0 は FP16 と区別がつかない程度でした(Perplexity の増分 +0.06% 以下)。q4_0 は文脈 4,096 で +0.3〜0.5%、文脈 16,384 にすると 8B で +1.05% と約 2 倍に増えました。gpt-oss-20b は KV の量子化に弱く、q4_0 で +2.4%、最も確率の高いトークンが FP16 と一致した割合は 64% でした。llama.cpp 開発者が PR #7412 で公開した値(ウェイト FP16、モデル名の記載なし)は q8_0 で +0.03%、q4_0 で +3.3% で、q8_0 は手元と同じ水準、q4_0 は手元の Qwen3 よりずっと大きい値です。モデルと重みの量子化が違うので、そのまま比べられる数字ではありません。
- Flash Attention を有効にしないと KV Cache 量子化は使えませんか?
- llama.cpp では K(キー)の量子化は Flash Attention 無しでも使えますが、V(バリュー)の量子化は Flash Attention が必要です。現行版(コミット cd959bae9 のソースで確認)は -fa の既定が auto で、V を量子化すると Flash Attention が自動で有効になります。-fa off を明示したまま --cache-type-v q8_0 を指定すると、起動時にエラーで止まります。vLLM / SGLang は Flash Attention(または FlashInfer)が内部で既定有効なので、この制約は意識せず使えます。
- Llama 3.3 70B を 128K コンテキストで動かすと KV Cache は何 GB になりますか?
- Llama 3.3 70B(n_layers=80、n_kv_heads=8、head_dim=128)は 1 トークンあたり FP16 で 320KiB の KV Cache を使います。128K(131,072 トークン)で FP16 約 40GiB、q8_0 約 21GiB、q4_0 約 11GiB です。モデル本体は Q4_K_M で約 42.5GB(約 39.6GiB)あり、RTX 5090(32GB)にはモデルだけでも収まりません。q4_0 の KV と合わせても約 51GiB になるので、RTX PRO 6000 Blackwell(96GB)や 64GB 以上のユニファイドメモリを持つ Mac Studio、Strix Halo ミニPC(96GB を GPU に割り当て)の範囲になります。
- Ollama で KV Cache 量子化はどう有効化しますか?
- Ollama v0.5.0(2024 年 12 月)以降は、環境変数 OLLAMA_KV_CACHE_TYPE=q8_0 または q4_0 をサーバー起動時に設定すると有効になります。リリースノートでは OLLAMA_FLASH_ATTENTION=1 と組み合わせる手順が示されています。既定は f16(FP16)です。UI(Open WebUI / LibreChat)から切り替えることはできず、systemd や Docker の環境変数で指定するのが標準的な運用です。