AI画像生成は NVIDIA RTX か Apple Silicon か。ローカル運用の現実解 2026年版
ComfyUI か Mac か。Mac mini M4 と RTX 4070 の実測で画像1枚の速度は約11倍の差。NVIDIA と Mac の選び方を用途別に
- #AI画像生成
- #Stable Diffusion XL
- #Flux.1
- #RTX 5090
- #M4 Max
- #M3 Ultra
- #ComfyUI
- #Draw Things
- #MLX
- #ローカル画像生成
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。

結論:速度最優先・ComfyUI フル活用・LoRA や ControlNet を多段で重ねたいなら RTX 5090 / RTX 4090。静音・低消費電力で Flux.1 dev や動画生成(Wan 2.2 / HunyuanVideo)まで視野なら Mac Studio M3 Ultra 96GB 以上。ノートで完結したいなら MacBook Pro M4 Max 64GB が最も現実的です。RTX 4090 中古(25〜35万円)と M4 Max 64GB の Mac(約50〜60万円)は価格帯こそ違いますが、Apple は MLX + Draw Things で「ボタンを押せば動く」、NVIDIA は ComfyUI のエコシステムを全部使えるという別軸の価値があります。速さの差は、手元の Mac mini M4 16GB と RTX 4070 12GB で同じ画像生成モデルを測ると約 11 倍でした(実装と量子化方式は別)。
Apple Silicon は MLX / Core ML / Draw Things の改善で、2026年にローカル AI 画像生成が「実用」と呼べる領域に入りました。NVIDIA RTX が長年一強だった構図が崩れつつあり、「Mac で画像生成 AI は本当に実用なのか?」という質問が増えています。本記事では、SDXL・Flux.1・動画生成を含めて NVIDIA RTX と Apple Silicon を生成速度・対応エコシステム・メモリ・消費電力・初期投資の5軸で比較し、用途別の判断軸を整理します。
GPU 単体のベンチ詳細は Stable Diffusion XL / Flux.1 画像生成速度 GPU別ベンチマーク 2026年版 と Apple Silicon の Unified Memory と NVIDIA VRAM、ローカルLLM では何が違うのか 2026年版 を合わせて参照してください。
2026年5月時点の比較対象
ローカル画像生成で現実的な選択肢を整理します。
NVIDIA RTX 側
| モデル | VRAM | 帯域 | TBP | 実勢価格 |
|---|---|---|---|---|
| RTX 5090 | 32GB GDDR7 | 1,792 GB/s | 575W | 55〜62万円 |
| RTX 5080 | 16GB GDDR7 | 960 GB/s | 360W | 25〜30万円 |
| RTX 4090(中古) | 24GB GDDR6X | 1,008 GB/s | 450W | 25〜35万円 |
| RTX 5070 Ti | 16GB GDDR7 | 896 GB/s | 300W | 17〜20万円 |
Apple Silicon 側
| モデル | Unified Memory | 帯域 | 最大消費電力 | 実勢価格 |
|---|---|---|---|---|
| Mac Studio M3 Ultra 256GB | 256GB LPDDR5X | 約 800 GB/s | 約 215W | 約 160万円(初版時点。Apple 公式では販売終了) |
| Mac Studio M3 Ultra 96GB | 96GB LPDDR5X | 約 800 GB/s | 約 215W | 約 80万円(初版時点。Apple 公式では販売終了) |
| Mac Studio M4 Max 128GB | 128GB LPDDR5X | 546 GB/s | 約 145W | 約 90万円(初版時点。Apple 公式では販売終了) |
| Mac Studio M4 Max 64GB | 64GB LPDDR5X | 546 GB/s | 約 145W | 約 50万円(初版時点。Apple 公式では販売終了) |
| MacBook Pro M4 Max 64GB | 64GB LPDDR5X | 546 GB/s | 約 140W | 約 60万円 |
※ Mac Studio は 2026 年 8 月に M5 Max / M5 Ultra へ切り替わり、M4 Max / M3 Ultra は Apple 公式ストアで新品販売を終えています。2026 年 11 月時点の Apple 公式価格(税込)は、M5 Max 64GB(18 コア CPU / 40 コア GPU、SSD 512GB)が ¥599,800、M5 Max 128GB が ¥887,800、M5 Ultra 96GB(30 コア CPU / 64 コア GPU、SSD 1TB)が ¥949,800、M5 Ultra 256GB が ¥1,669,800 です。本記事の Mac の速度・電力は M4 / M3 世代の値です。
生成速度:NVIDIA が速い。ただし 12GB の GPU は量子化次第
保有実機での実測:Mac mini M4 16GB と RTX 4070 12GB
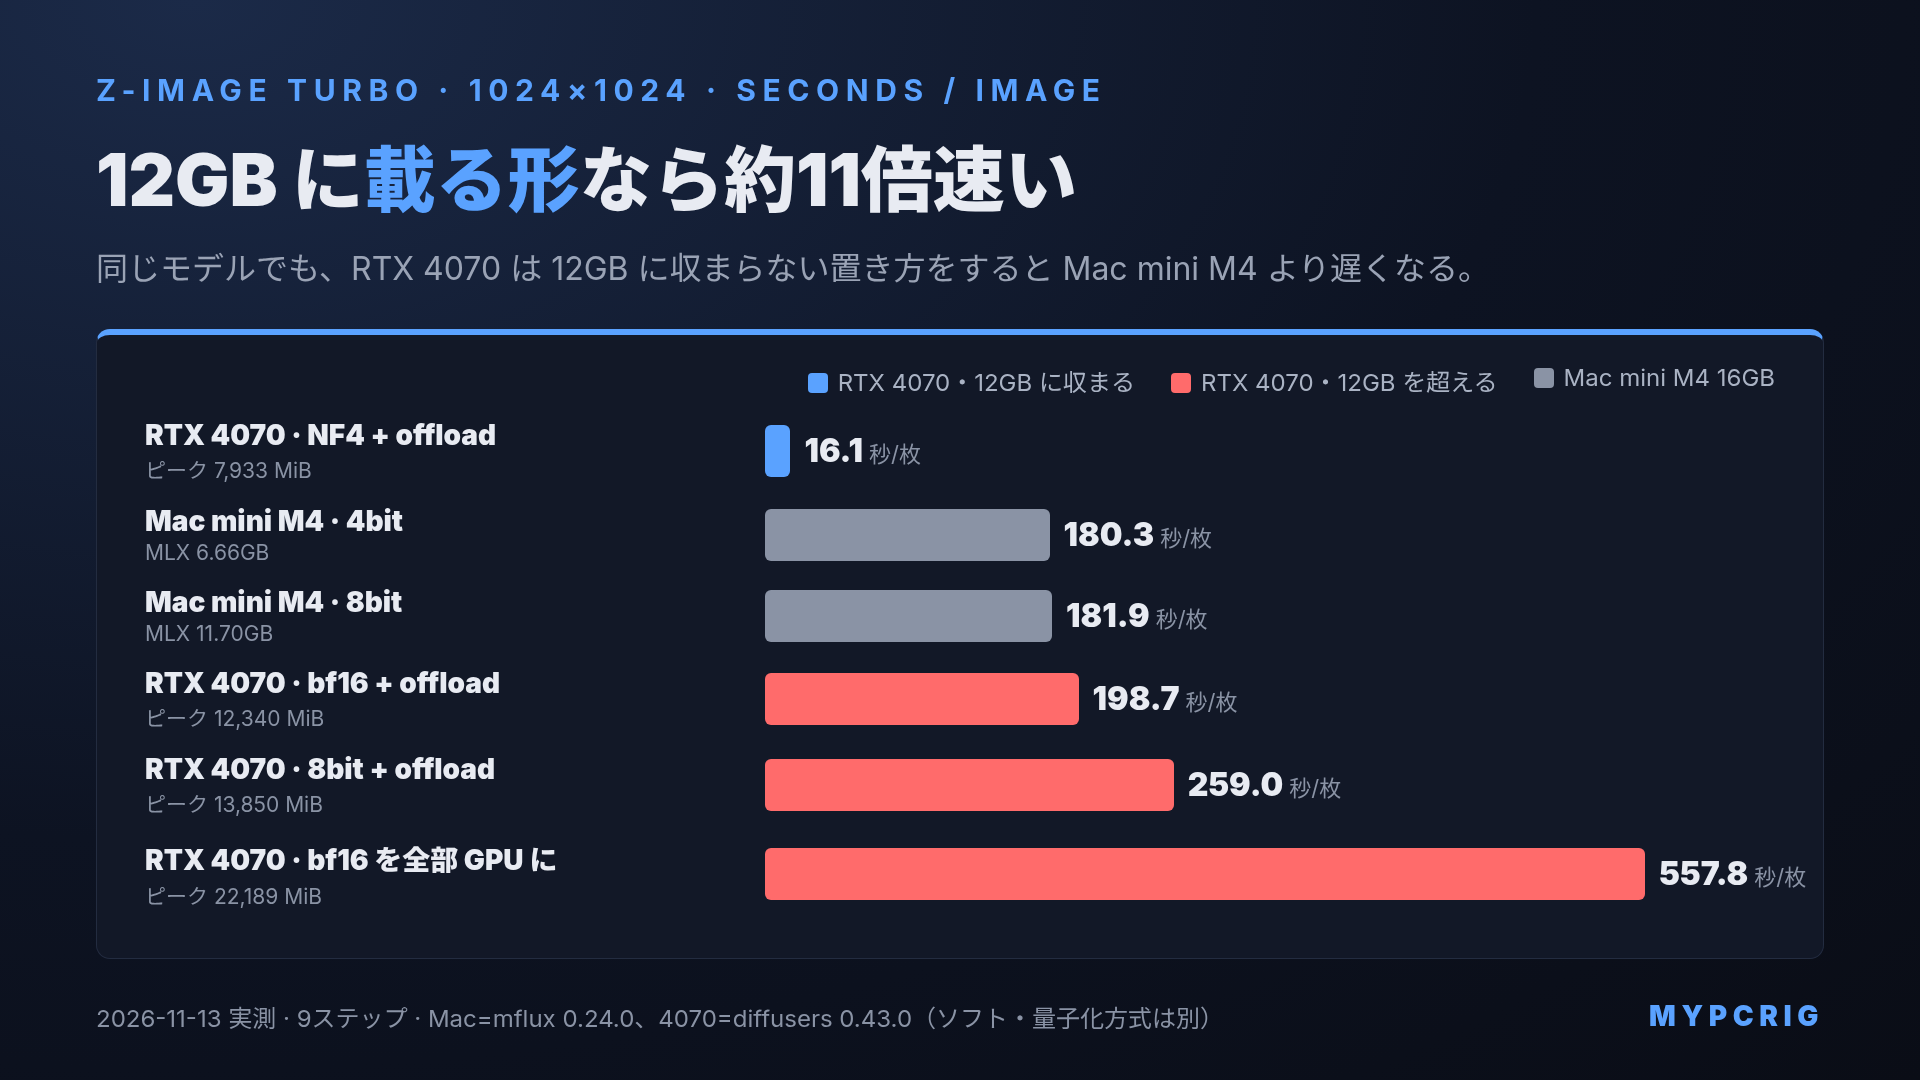
2026-11-13 に、手元の Mac mini M4 16GB(10 コア GPU)と RTX 4070 12GB で、同じ画像生成モデルを測りました。Flux.1 schnell は Hugging Face でライセンス同意が要るモデル(ゲート付き)で取得できなかったので、ゲートの無い Z-Image Turbo(Tongyi-MAI、Apache 2.0、6B の DiT + テキストエンコーダ Qwen3 4B)で代えています。
条件:1024×1024、9 ステップ、guidance 0、seed 42、ウォームアップ 1 回のあと 3 回の平均。秒/枚はテキストエンコードと VAE デコードを含む壁時計です。消費電力・温度と生成画像の品質は比べていません。
| 機材 | 実行方法 | 秒/枚 | ピークメモリ |
|---|---|---|---|
| Mac mini M4 16GB | mflux 0.24.0、4bit | 180.3 | MLX 6.66GB |
| Mac mini M4 16GB | mflux 0.24.0、8bit | 181.9 | MLX 11.70GB |
| RTX 4070 12GB | diffusers 0.43.0、transformer を NF4 + model offload | 16.1 | 7,933 MiB |
| RTX 4070 12GB | bf16 + model offload | 198.7 | 12,340 MiB(VRAM 超え) |
| RTX 4070 12GB | transformer を 8bit + model offload | 259.0 | 13,850 MiB(VRAM 超え) |
| RTX 4070 12GB | bf16 を全部 GPU に置く | 557.8 | 22,189 MiB(VRAM の約 1.8 倍) |
4070 の NF4 は 1 回目が 3.29 秒と原因不明の外れ値だったので、2・3 回目の平均にしています。
読み取れることは 2 つです。
- 無印 M4 は 4070(NF4)の約 11 倍遅い(180.3 / 16.1)。100 枚なら M4 が約 5 時間、4070 が約 27 分です。ただし Mac は mflux、4070 は diffusers で、量子化も mflux の 4bit と bitsandbytes の NF4 で方式が違います。同じソフト・同じ量子化での比較ではありません
- 4070 は 12GB に収まる量子化を選ばないと Mac より遅くなる。transformer は bf16 で 12.3GB あって 12GB に載らず、bf16 のまま全部 GPU に置くと共有 GPU メモリにはみ出して 557.8 秒、model offload でも 198.7 秒、8bit も 259.0 秒で、どれも M4 の 180.3 秒より遅くなりました。12GB クラスの GPU を買うなら「載る形に量子化する」手間が前提です
RTX 4070 では SDXL base 1.0(fp16、30 ステップ、diffusers)も測り、1 枚 11.4〜14.4 秒でした(同じ条件で 2 回測った 3 回平均が 11.42 秒と 14.39 秒)。Mac の SDXL は測っていません。
手元で測ったほかのモデル(Mac は mflux、4070 は Wan2GP)
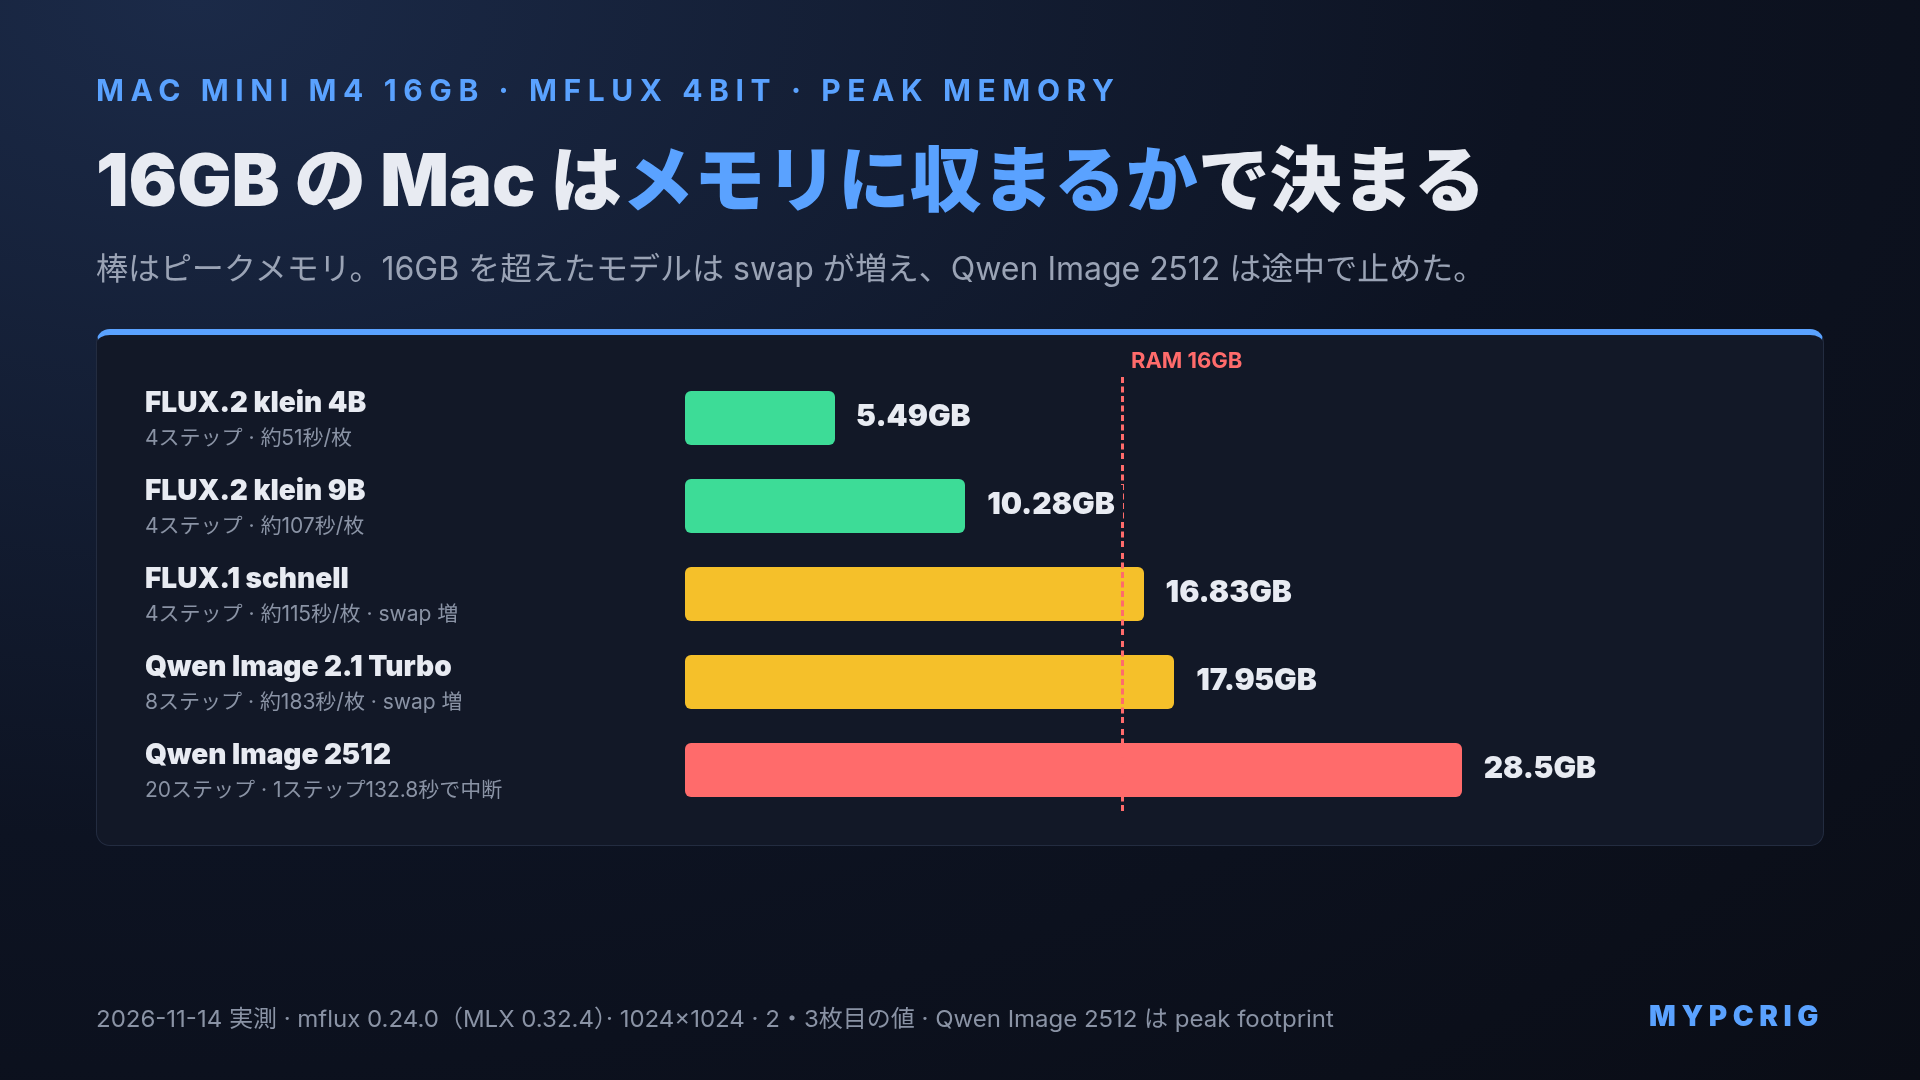
2026-11-14 に、両方の機材でモデルを増やして測りました。Mac mini M4 16GB は mflux 0.24.0(MLX 0.32.4)で、mflux-community が配布している量子化済み(4bit)のモデルを使い、1 プロセスで 3 枚続けて生成しました。RTX 4070 12GB は Wan2GP(quanto int8、重みをシステム RAM に置いて GPU に流す設定)で、読み込み込みの 1 回目のあと 3 回の平均です。どちらも 1024×1024・seed 42・各モデルの既定ステップで、プロンプトは上と同じです。
| 機材 | モデル | ステップ | 秒/枚 | ピークメモリ |
|---|---|---|---|---|
| Mac mini M4 16GB | FLUX.2 klein 4B(4bit) | 4 | 約 51(50.2 / 51.8) | MLX 5.49GB |
| Mac mini M4 16GB | FLUX.2 klein 9B(4bit) | 4 | 約 107(107.5 / 106.0) | MLX 10.28GB |
| Mac mini M4 16GB | FLUX.1 schnell(4bit) | 4 | 約 115(115.3 / 114.1) | MLX 16.83GB(swap 増) |
| Mac mini M4 16GB | Qwen Image 2.1 Turbo(4bit) | 8 | 約 183(184.4 / 182.3) | MLX 17.95GB(swap 増) |
| Mac mini M4 16GB | Qwen Image 2512(4bit) | 20 | 1 ステップ 132.8 秒で中断(1 枚約 44 分の見込み) | peak footprint 28.5GB |
| RTX 4070 12GB | Z-Image Turbo 6B(int8) | 8 | 13.2 | VRAM 5,106 MiB |
| RTX 4070 12GB | Flux 1 Chroma HD 8.9B(int8) | 20 | 66.2 | VRAM 6,734 MiB |
| RTX 4070 12GB | Qwen Image 2512 20B(int8) | 30 | 131.8 | VRAM 3,022 MiB、システム RAM 約 18.5GB |
Mac の秒/枚は 2・3 枚目の値(1 枚目は読み込み込み)です。
- 16GB の Mac で実用的だったのは FLUX.2 klein 4Bです。1 枚約 51 秒で、上の Z-Image Turbo(180.3 秒)の約 3.6 倍速く、メモリも 5.49GB で収まりました
- Qwen Image 2512 は 16GB の Mac では実用になりません。1 ステップ 132.8 秒で swap が 17GB まで膨らんだので、4/20 ステップで止めました。同じモデルは RTX 4070(int8、RAM へのオフロード)なら 1 枚 131.8 秒で、システム RAM が 32GB ある PC の強みが出たところです
- FLUX.1 schnell と Qwen Image 2.1 Turbo は動きましたが、MLX のピークが 16.8〜18.0GB で RAM を超え、swap が 2.7〜5.1GB 増えました。16GB の Mac では境目の上にいるモデルです
- モデルも実装も違うので、この表は機材どうしの速度比ではありません。画質も比べていません
M4 Max / M3 Ultra の秒/枚について
M4 Max / M3 Ultra の実機は所有していないので、この記事では秒/枚を載せていません。以前の版では SDXL・Flux.1 dev の目安を載せていましたが、出典を確かめられなかったため外しました。
参考になる公開値としては、Apple が MLX で FLUX-dev(4bit、12B)の 1024×1024 を生成すると M5 が M4 の 3.8 倍以上速いと公表しています(Apple Machine Learning Research)。Mac の画像生成は世代と GPU コア数で大きく変わるので、買う機種の実測値を探してから判断してください。
NVIDIA 同士の目安
NVIDIA 側の SDXL / Flux.1 dev の目安は Stable Diffusion XL / Flux.1 画像生成速度 GPU別ベンチマーク 2026年版 にまとめています。そちらの集約値は RTX 5090 が SDXL 1024×1024・25 ステップで約 2.2 秒、RTX 4090 が約 5.2 秒です。手元で測ったのは RTX 4070 だけです。
Flux.1 dev は 12B パラメータの大型モデルで、重みは FP16 で約 24GB、FP8 で約 12GB です。RTX 4090 / 5090 なら FP8 で余裕を持って載り、12GB の RTX 5070 / 4070 は 4bit 級の量子化が前提になります。上の Z-Image Turbo(6B)でも、12GB に収まらない形では速度が大きく落ちました。
エコシステム:ComfyUI vs Draw Things の構図
これが2026年に最も変化した部分です。
ComfyUI(NVIDIA フル対応 / Mac は限定対応)
ComfyUI は「ノードベースで何でも組める」汎用ワークフロー基盤です。LoRA・ControlNet・IPAdapter・AnimateDiff・最新の動画生成ノードまで、コミュニティ製プラグインが2026年でも一番速く揃います。NVIDIA + CUDA でフル機能が使えますが、Mac の MPS バックエンドではプラグインが動かないケースが残ります。
ComfyUI を本気で使うなら NVIDIA、と割り切るのが2026年の現実です。
Draw Things(Mac 専用、最適化済み)
Draw Things は Mac の App Store で無料配布されているネイティブアプリで、Metal FlashAttention・Core ML アクセラ・オンデマンドの重みロードで Apple Silicon に最適化されています。インストール後すぐ使え、ターミナル作業が一切要らないのが Mac ユーザーには大きな差別化要素です。
Draw Things は ControlNet・LoRA・SDXL・Flux・SD 1.5 にすべて対応しています(ComfyUI との速度差は手元では測っていません)。複雑な多段ワークフロー(例:Lineart ControlNet → IPAdapter → LoRA 3枚重ね → SDXL → 4倍アップスケール → Face Restoration)を組みたい場合は ComfyUI に分がありますが、「プロンプト + LoRA + ControlNet 1枚」レベルなら Draw Things で十分です。
Diffusers(両対応)
Hugging Face の Diffusers ライブラリは PyTorch ベースで両対応ですが、最新モデル(Flux.1、Wan 2.2、HunyuanVideo)の対応は CUDA が先行、Mac の MPS は数ヶ月遅れがちです。研究目的・Python スクリプトでの自動化を最優先するなら CUDA + NVIDIA が安全です。
mflux(Mac MLX 専用、Flux 系から Qwen Image まで)
mflux は Apple MLX 上で Flux.1 などを動かす実装で、手元の Mac mini M4 の計測(上の Z-Image Turbo、FLUX.2 klein、Qwen Image)にも mflux 0.24.0 を使いました。量子化したモデルを mflux-save で保存しておけるので、16GB の Mac でも読み込みで溢れにくくなります。Apple は MLX で FLUX-dev(4bit)の 1024×1024 生成が M5 で M4 の 3.8 倍以上速いと公表しており(Apple Machine Learning Research)、Mac の画像生成は世代で大きく変わります。
対応モデル幅:NVIDIA が一歩先、Mac は急速に追従
最新モデルの対応状況を整理します。
| モデル | NVIDIA RTX | Apple Silicon |
|---|---|---|
| SD 1.5 | ◎(全機能) | ◎(Draw Things / ComfyUI) |
| SDXL | ◎(全機能) | ◎(Draw Things / mflux / ComfyUI) |
| Flux.1 schnell | ◎ | ○(Draw Things / mflux、INT4 量子化) |
| Flux.1 dev | ◎(FP8 / FP16) | ○(mflux、INT4 量子化) |
| LoRA | ◎(任意) | ○(Draw Things 対応、ComfyUI 一部対応) |
| ControlNet | ◎(全種類) | ○(Draw Things 対応、Lineart / Depth / OpenPose 等) |
| IPAdapter | ◎ | △(Draw Things 対応、ComfyUI 不安定) |
| Wan 2.2(動画) | ◎(ComfyUI) | △(実験的、要 96GB 以上) |
| HunyuanVideo(動画) | ◎ | △(要大容量 UM) |
| LTX Video | ◎ | △(一部 MLX 実装あり) |
動画生成(Wan 2.2 / HunyuanVideo / LTX Video)は NVIDIA が大きく先行、Mac は2026年で「動くようになった」段階。本格的に動画生成をやるなら NVIDIA + 24GB 以上の VRAM がほぼ必須です。
メモリ:Mac の Unified Memory が活きる場面
VRAM と Unified Memory の構造的な違いは Unified Memory vs VRAM 記事 に詳しく書きましたが、画像生成での効き方を整理します。
NVIDIA が詰まる場面
- Flux.1 dev FP16(24GB 必要)+ ControlNet 2枚 + LoRA 3枚 → RTX 4090 の24GB がギリギリ、RTX 5070 12GB は不可
- SDXL を2048×2048 で生成 → VRAM 14GB を超える、RTX 5070 / 5080 で詰まる
- 動画生成 Wan 2.2 で長尺 → RTX 4090 24GB でも数秒長尺は厳しい
Mac が有利な場面
- Flux.1 dev FP16 のまま動かしたい → M4 Max 64GB / M3 Ultra 96GB で余裕
- 高解像度(2048×2048〜4096×4096)生成 → Mac のメモリ容量が活きる
- 複数モデル同時ロード(SDXL + Flux + LLM)→ Mac の方が運用が楽
- 動画生成で長尺・大解像度 → M3 Ultra 256GB が現実的な選択肢
「速度では NVIDIA、容量では Mac」という構図は LLM と同じです。RTX 5090 でも32GB が上限、ここを超えるワークロード(FP16 Flux + 長尺動画 + LoRA 多段)は M3 Ultra でしか動きません。
消費電力・騒音・初期投資の現実
ローカル AI 運用で意外と効くのが、電力・音・スペースの3点です。
| 構成 | 最大消費電力 | アイドル | 騒音 | 必要電源 | 初期投資 |
|---|---|---|---|---|---|
| RTX 5090 + ATX フル構成 | 約 700W | 約 90W | 大(フル稼働時) | 1000W ATX 3.1 | 70〜85万円 |
| RTX 4090 中古 + ATX 構成 | 約 550W | 約 80W | 大 | 850W ATX 3.0 | 55〜70万円 |
| RTX 5070 Ti + ATX 構成 | 約 400W | 約 70W | 中 | 750W | 35〜45万円 |
| Mac Studio M3 Ultra 96GB | 約 215W | 約 8W | ほぼ無音 | 内蔵 | 80〜90万円(初版時点。Apple 公式では販売終了。現行 M5 Ultra 96GB は ¥949,800) |
| Mac Studio M4 Max 64GB | 約 145W | 約 7W | ほぼ無音 | 内蔵 | 50〜55万円(初版時点。Apple 公式では販売終了。現行 M5 Max 64GB は ¥599,800) |
| MacBook Pro M4 Max 64GB | 約 140W | 約 8W | ほぼ無音 | 内蔵(ノート) | 60〜65万円 |
電気代は最大消費電力の差(RTX 5090 構成の約 700W に対し Mac Studio M3 Ultra は約 215W)がそのまま効くので、毎日長く回すほど差が開きます。Mac の消費電力とシステム全体の壁の値は手元では測っていないので、この表の電気代の金額は出しません。
手元の RTX 4070 では GPU 単体の電力だけ nvidia-smi で測りました。画像生成中は平均 145〜176W(電力上限 200W)で、1 枚あたりの GPU 電力量は Z-Image Turbo 0.56Wh、Flux 1 Chroma HD 3.2Wh、Qwen Image 2512 20B 5.3Wh でした。CPU やメモリの分は入っていません。
加えて RTX 5090 のフル稼働は 掃除機並の騒音 で、寝室や仕事部屋に置くにはケース選びが厳しい。Mac Studio はほぼ無音、MacBook Pro はフル負荷時にファンが回るが静音性は別格です。
用途別の判断:あなたが買うべき1台
ここまでの軸を踏まえて、ユースケースで結論を整理します。
1. SDXL を高速回したい・ComfyUI ヘビーユーザー → RTX 5090 / RTX 4090
ComfyUI で多段ワークフローを組む、LoRA を10枚以上重ねる、IPAdapter で参照画像を多用する、動画生成も視野、というユーザーは NVIDIA 一択です。RTX 5090 が予算外なら RTX 4090 中古(25〜35万円)が最も現実的で、24GB VRAM は Flux.1 FP8 や SDXL 2048px に十分です。
2. Flux.1 dev / 動画生成・静音・大容量を取りたい → Mac Studio M3 Ultra 96GB
96GB Unified Memory で Flux.1 dev FP16 + ControlNet + LoRA を余裕で同時ロード、Wan 2.2 の実験も射程内。約215Wで静音、デスクスペースも小さい。「速度より容量・静音・運用性」を取るユーザー向け。
3. ノート1台で完結したい → MacBook Pro M4 Max 64GB
「外出先でも画像生成したい」「専用デスクトップを置く場所がない」というケースなら MacBook Pro M4 Max 64GB が現実解です。M4 Max の秒/枚は測っていませんが、無印 M4 は RTX 4070 の約 11 倍かかったので、量産より試作やアイデアスケッチ向きと考えてください。
4. 予算30万円でとりあえず始めたい → RTX 5070 Ti または M4 Max 64GB
予算30万円以下なら、RTX 5070 Ti(17〜20万円)+ Ryzen 7 構成(合計30〜35万円)が SDXL ヘビー運用に向きます。あるいは Mac Studio の 64GB 構成が次のステップです。初版時点では M4 Max 64GB が約50万円でしたが、M4 Max は Apple 公式で販売を終え、現行の M5 Max 64GB は ¥599,800(Apple 公式、2026 年 11 月時点)です。RTX 5070 12GB は Flux.1 では量子化が前提になります。手元の RTX 4070 12GB では、12GB に収まる NF4 にしたときだけ速く、収まらない形では Mac より遅くなりました。
5. ローカル LLM と画像生成を両立したい → M3 Ultra 96GB 以上
70B クラスの LLM を Q4 で常駐させながら、横で画像生成を回したいなら Mac Studio M3 Ultra 96GB / 256GB が現実解です。RTX 5090 32GB ではモデル切り替えのたびに VRAM 入れ替えが発生し、運用が煩雑になります。
「NVIDIA か Mac か」より「ComfyUI を本当に使うか」が分かれ目
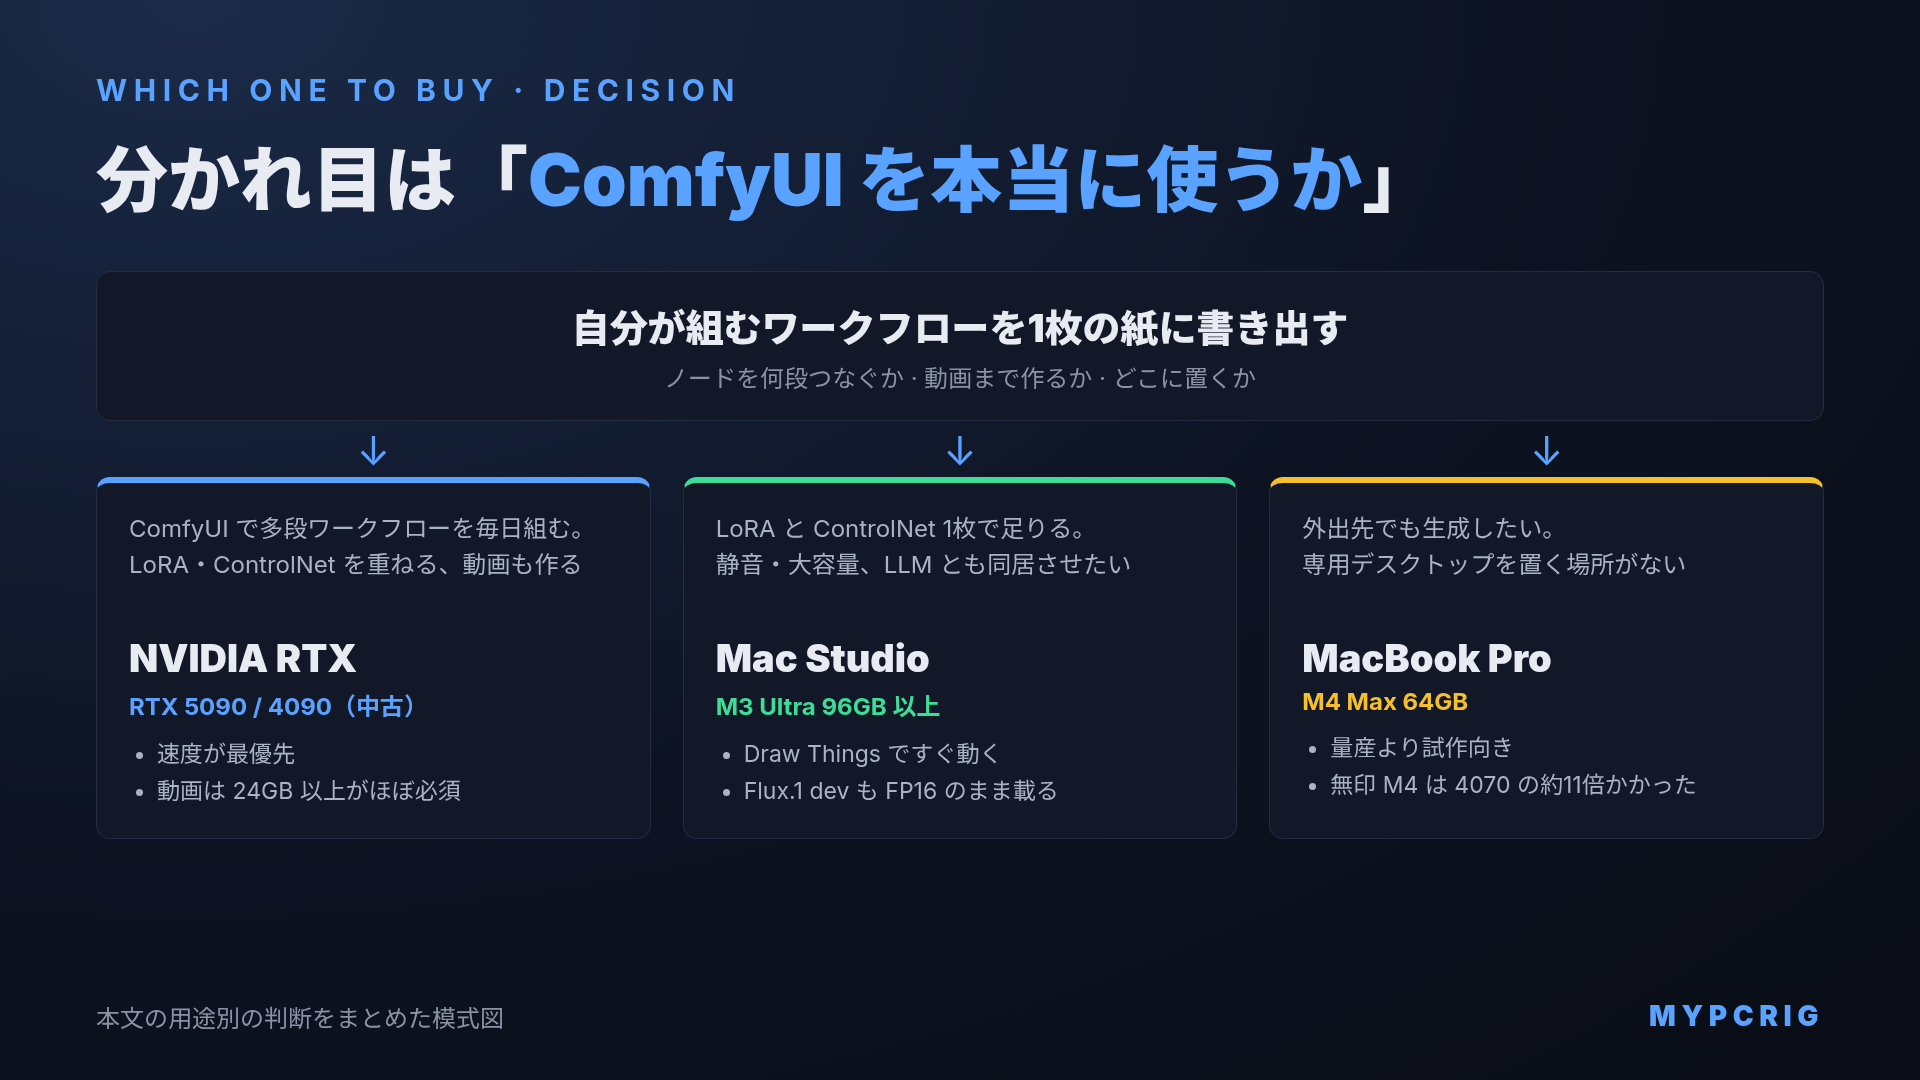
最後に、購入相談で一番ハマる落とし穴を1つ。「NVIDIA か Mac か」の選択は、結局のところ ComfyUI のエコシステムを本気で使うか という問いに帰着します。
ComfyUI で5枚以上のノードを並べて多段ワークフローを毎日組むなら NVIDIA、Draw Things のスライダーと LoRA / ControlNet 1枚で完結するなら Mac、という線引きが現実的です。「とりあえず NVIDIA を買ったが ComfyUI を結局触らず Draw Things 相当の機能しか使わなかった」というケースは意外と多く、その場合 Mac Studio の方が初期投資 + 電気代 + 騒音で総合的に得をします。
逆に「Mac を買ったが ControlNet を複数組み合わせたいケースが頻発して結局 NVIDIA を買い足した」というパターンもあり、買う前に「自分が組むワークフロー」を1枚紙に書き出してから判断するのが安全です。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
記事中で挙げた3つの代表構成へのリンクを置いておきます。
価格の注記(2026 年 8 月実測): Amazon.co.jp の RTX 5090 単体は第三者出品者によるマーケットプレイス出品が中心で、上位掲載の実売価格は 86〜90 万円台でした(ASUS TUF / ROG Astral、出品者 B&T)。PC 専門店やメーカー直販の価格も確認してから判断してください。
- GeForce RTX 5090 を Amazon.co.jp で見る:速度最優先 / ComfyUI フル活用向け
- Mac Studio M3 Ultra 96GB を Apple公式サイトで見る:静音・大容量・Flux.1 dev / 動画生成も視野
- MacBook Pro 16 M4 Max 64GB を Apple 公式ストアで見る:ノート1台で完結したいユーザー向け
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- Stable Diffusion XL / Flux.1 画像生成速度 GPU別ベンチマーク 2026年版:GPU 単体での生成速度の数値ベンチ
- AI画像生成向けPC構成ガイド 2026年版:NVIDIA で画像生成PCを組む場合の構成全体
- Apple Silicon の Unified Memory と NVIDIA VRAM、ローカルLLM では何が違うのか 2026年版:メモリ構造の違いを LLM 視点で深掘り
- MacでFlux・SDXL:M4で画像生成を実測:Draw Things / mflux / ComfyUI の Mac 側セットアップと、Mac mini M4 16GB の実測
- ローカルLLM SSD 容量と何TB必要か 2026年版:画像生成モデルの原本と量子化版で何 GB 使ったか
- ローカル動画生成 GPU別ベンチマーク 2026年版:Wan 2.2 / HunyuanVideo / LTX Video の GPU 別実測。動画まで視野に入れる場合の比較軸
よくある質問
- AI画像生成用に PC を組むなら NVIDIA RTX と Apple Silicon Mac、どちらを選ぶべきですか?
- 速度最優先で ComfyUI をフル活用し LoRA や ControlNet を多段で重ねたいなら RTX 5090 または RTX 4090、静音・低消費電力で Flux.1 dev や動画生成(Wan 2.2 / HunyuanVideo)まで視野に入れたいなら Mac Studio M3 Ultra 96GB 以上、ノート1台で完結したいなら MacBook Pro M4 Max 64GB が現実解です。RTX 4090 中古(25〜35万円)と M4 Max 64GB の Mac(約50〜60万円)は価格帯こそ違いますが、Apple は MLX + Draw Things で「ボタンを押せば動く」、NVIDIA は ComfyUI のエコシステムを全部使えるという別軸の価値があります。
- 画像生成の速度は NVIDIA と Mac でどれくらい違いますか?
- 手元の Mac mini M4 16GB と RTX 4070 12GB で、Z-Image Turbo(6B)の 1024×1024・9 ステップを生成した値では、M4(mflux、4bit)が 1 枚 180.3 秒、4070(diffusers、transformer を NF4)が 16.1 秒で、約 11 倍の差でした。Mac は mflux、4070 は diffusers と実装が違い、量子化の方式も違うので、チップ単体の差そのものではありません。モデルを選べば Mac も速くなり、同じ M4 で FLUX.2 klein 4B(4bit、4 ステップ)は 1 枚約 51 秒でした。M3 Ultra / M4 Max の実機は持っておらず、出典の付いた秒/枚も見つからなかったので、上位の Mac との差は載せていません。
- Flux.1 dev は Apple Silicon (M4 Max / M3 Ultra) でも動きますか?
- 動きます。Flux.1 dev は 12B パラメータで、重みは FP16 で約 24GB、FP8 で約 12GB です。Mac は Unified Memory の容量を活かして 4bit / 8bit の量子化版を mflux や Draw Things で回す形が中心になります。Apple は MLX で FLUX-dev(4bit)の 1024×1024 を生成すると M5 が M4 の 3.8 倍以上速いと公表しています。M3 Ultra / M4 Max での秒/枚は手元では測っていません。12GB の GPU では量子化の選び方が速度を大きく左右し、手元の RTX 4070 では 6B の Z-Image Turbo でも、12GB に収まる NF4 にしないと Mac より遅くなりました。
- ComfyUI は Mac で問題なく使えますか?
- 動きますが、MPS バックエンドではプラグインが動かないケースが残ります。Mac の MPS バックエンドでは一部のノードが動かないこともあるため、ComfyUI を本気で使うなら NVIDIA と割り切るのが 2026 年時点での現実です。多段ワークフロー(ControlNet 複数 + IPAdapter + LoRA 多段 + AnimateDiff など)を毎日組むなら NVIDIA、プロンプト + LoRA + ControlNet 1 枚レベルで完結するなら Mac の Draw Things で十分、というのが穏当な使い分けです。
- Draw Things と ComfyUI は何が違いますか?
- Draw Things は Mac の App Store で無料配布されているネイティブアプリで、Metal FlashAttention や Core ML アクセラ、オンデマンドの重みロードで Apple Silicon に最適化されています。インストール後すぐ使えます。ComfyUI は「ノードベースで何でも組める」汎用ワークフロー基盤で、LoRA・ControlNet・IPAdapter・AnimateDiff・最新の動画生成ノードまで揃いますが、複雑さは Draw Things より高くなります。両者の速度差は手元では測っていません。
- Mac の Unified Memory は AI画像生成で VRAM の代わりになりますか?
- 使えます。Flux.1 dev FP16 のまま動かしたい場合、M4 Max 64GB / M3 Ultra 96GB で余裕を持ってロードできます。高解像度(2048×2048〜4096×4096)生成、複数モデル同時ロード(SDXL + Flux + LLM)、動画生成の長尺・大解像度など、RTX 5090 の 32GB VRAM 上限を超えるワークロードでは Mac の容量が活きます。全体像としては「速度では NVIDIA、容量では Mac」という構図で、LLM と同じ棲み分けになります。
- AI画像生成のために M4 Max と M3 Ultra、どちらの Mac を選ぶべきですか?
- Flux.1 dev や動画生成(Wan 2.2 / HunyuanVideo)まで視野に入れ、静音・大容量を取りたいなら Mac Studio M3 Ultra 96GB が現実解です。96GB Unified Memory で Flux.1 dev FP16 + ControlNet + LoRA を余裕で同時ロードでき、Wan 2.2 の実験も射程内です。ノート 1 台で完結したいなら MacBook Pro M4 Max 64GB です。ただし Mac は NVIDIA より生成が遅く、手元の無印 M4 では RTX 4070 の約 11 倍かかりました。M4 Max は GPU コアが無印 M4 の 3〜4 倍あるので速くなるはずですが、測っていないので、何十枚も回す量産用途なら NVIDIA を勧めます。