ローカルLLM 日本語性能ベンチマーク 2026年版
ローカルLLM の日本語性能はベンチマークでどう評価されているか。Nejumi LLM Leaderboard / ELYZA-tasks-100 / JMT-Bench / JGLUE の 4 大日本語ベンチの違いと、Qwen3 / Llama 4 / Gemma 3 / Swallow / Sarashina2 / PLaMo 2 / ELYZA の公開スコアの読み方を 2026 年版で整理します。
- #ローカルLLM
- #日本語ベンチマーク
- #Nejumi
- #Elyza-tasks-100
- #JMT-Bench
- #JGLUE
- #Qwen3
- #Swallow
- #Llama 4
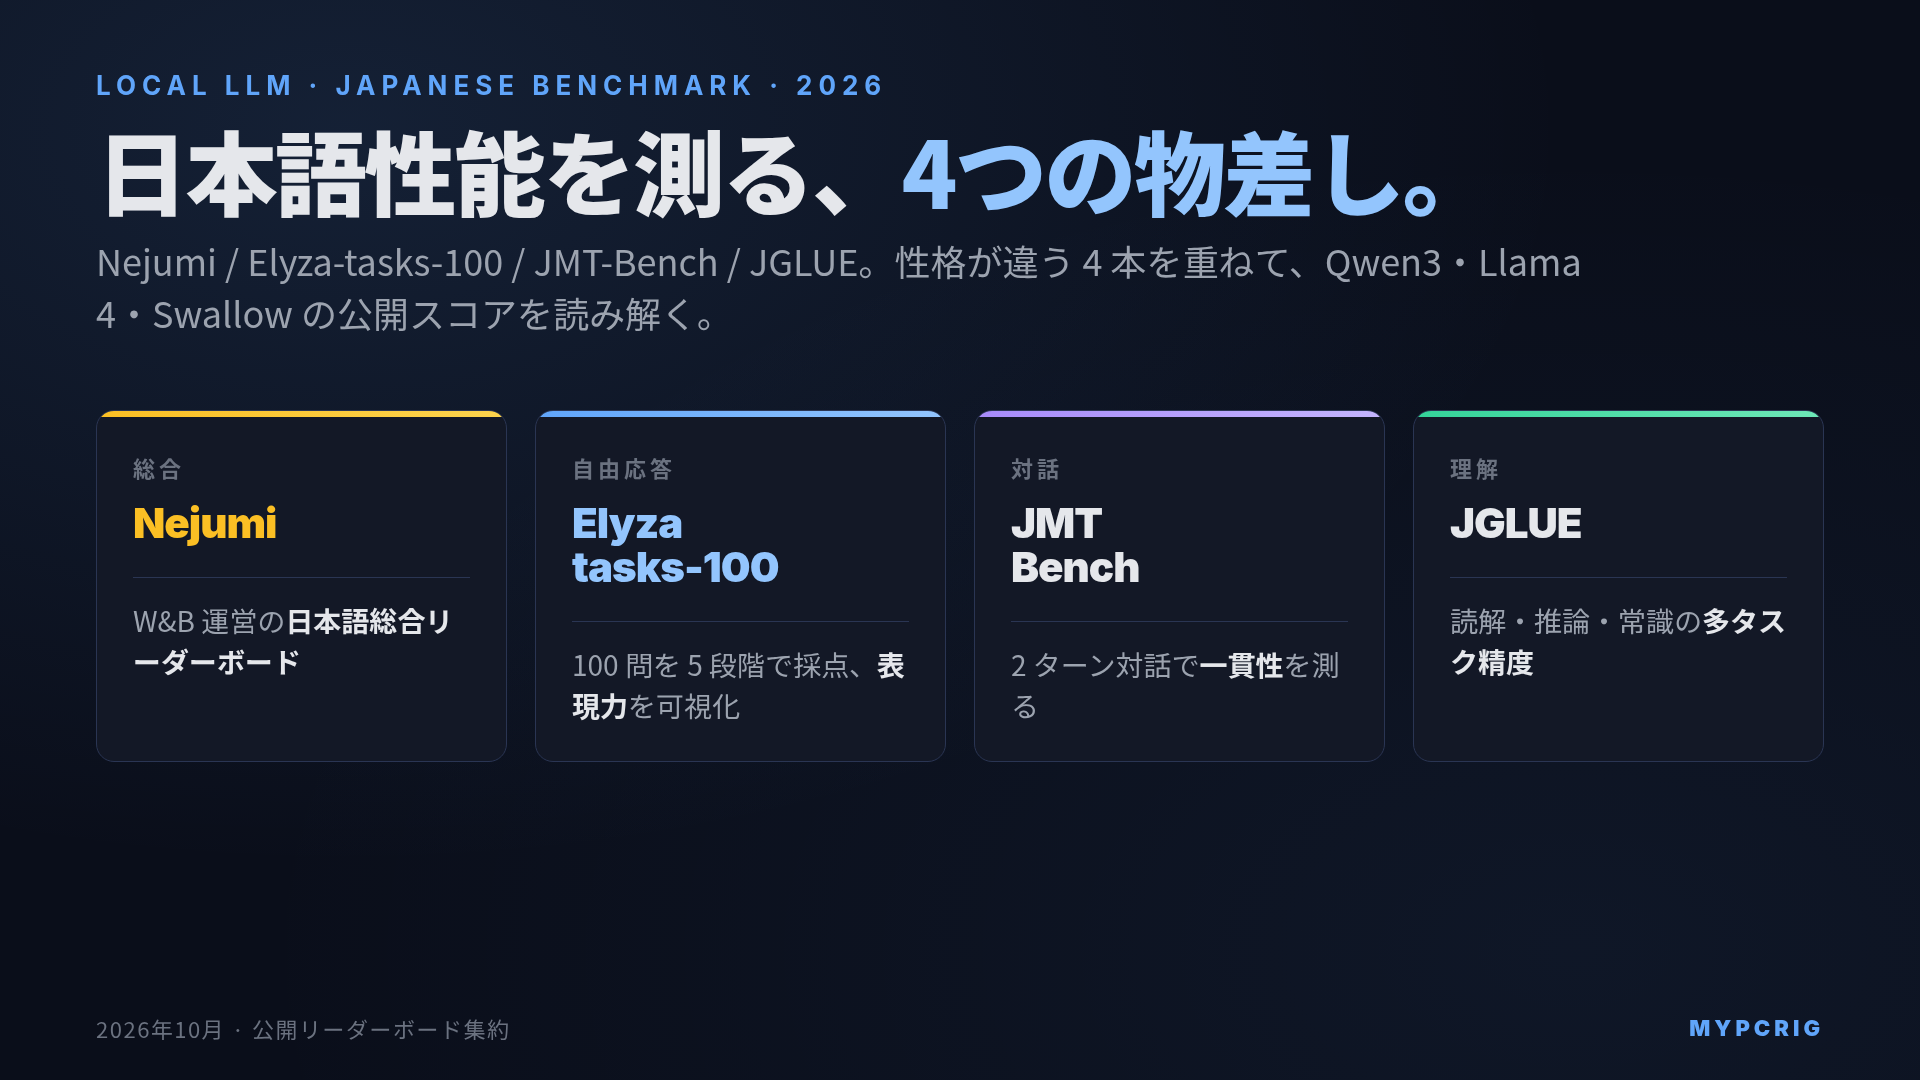
結論:日本語性能は単一のベンチでは決まらず、Nejumi LLM Leaderboard / ELYZA-tasks-100 / JMT-Bench / JGLUE の 4 本の性格を分けて読むのが 2026 年版の現実的な読み方です。ローカルで動くモデルを選ぶときは、まず「指示追従チューニング済み(Instruct)か」「日本語を公式にサポートしているか」を確認し、そのうえで開発元や第三者が公開しているスコア表を見ます。たとえば Llama 4 の公式サポート言語に日本語は含まれず、Sarashina2 70B はベースモデルです。名前の知名度だけで選ぶと、ここでつまずきます。
ローカルで日本語 LLM を選ぶとき、「どのモデルが賢いか」は単一のベンチでは答えが出ません。日本語の自然さを測る自由応答系と、読解・推論を測る精度系では強いモデルの顔ぶれが入れ替わります。本記事は散在する公開情報を 1 枚に整理する集約記事です。ベンチのスコアの出典はすべてリーダーボードとモデルカード(Hugging Face)で、出典リンクを数値の近くに置きます。保有実機で測ったのは、日本語 1 トークンあたりの文字数と、検索側(埋め込み)の日本語データでの精度だけで、「保有実機での実測」の節に分けて載せています。モデルの実在サイズと公開形態は 2026 年 10 月 19 日時点の Hugging Face 上の公開状況で確認しました。
日本語ベンチマークの 4 本柱
日本語モデルの性能を語るときに参照される公開ベンチは大きく 4 つあります。性格がそれぞれ違うので、「何を測っているか」を軸に読み分けると全体像が整理できます。
| ベンチマーク | 運営・作成 | 評価方式 | 強み |
|---|---|---|---|
| Nejumi LLM Leaderboard | Weights & Biases(W&B) | 複数ベンチの集約指標 | 国産モデル追跡の事実上の標準 |
| ELYZA-tasks-100 | ELYZA | 評価観点つき 100 問の自由応答を 5 段階で採点 | 日本語表現力・指示追従の可視化 |
| JMT-Bench | Stability AI(MT-Bench 日本語版) | 2 ターン対話を LLM 審査員で採点 | 対話の深さ・一貫性 |
| JGLUE | ヤフー(現 LINEヤフー)・早稲田大学 | 読解・推論・常識の多タスク精度 | 言語理解の底力 |
Nejumi LLM Leaderboard
Weights & Biases が運営する日本語総合リーダーボードです。複数の下流タスクを横断して集約指標を出すため、「とりあえず最新順位を見たい」ときの入り口になります。最新ランキングと採点設定は公式サイト(https://nejumi.ai/、現行は Nejumi Leaderboard 4)で更新されています。後述の Swallow のモデルカードも、日本語 MT-Bench の問題セットと審査プロンプトに Nejumi が公開しているものを使っています。
ELYZA-tasks-100
ELYZA が公開した 100 問の自由応答タスクです。問題ごとに「何ができていれば何点減点か」という評価観点がアノテーションされていて、5 段階で採点します。データセットと評価観点は Hugging Face Datasets(https://huggingface.co/datasets/elyza/ELYZA-tasks-100)で公開されています。データセットカードによると手動・自動のどちらの採点にも使える設計で、ELYZA 自身のベースライン評価は人手で行われました。外部の比較では GPT-4 系などの LLM を審査員にした自動採点が広く使われています。「日本語として自然か」「指示にきちんと応えているか」を見るのに向いています。
JMT-Bench
MT-Bench の日本語版で、Stability AI が FastChat のフォーク(https://github.com/Stability-AI/FastChat/tree/jp-stable/fastchat/llm_judge)として公開しました。1 問につき 2 ターンの対話を行い、LLM 審査員が採点します。ELYZA-tasks-100 が単発タスクなのに対し、JMT-Bench は「文脈を保ったまま 2 ターン目を返す力」も見ます。jp-stable 版の問題セット(japanese_mt_bench/question.jsonl)は extraction / humanities / reasoning / roleplay / stem / writing の 6 カテゴリ(各 10 問、合計 60 問)で、英語版 MT-Bench にあった coding / math は含まれていません。
JGLUE
ヤフーと早稲田大学の研究者が公開した日本語理解ベンチマークで、JCommonsenseQA(常識推論)・JSQuAD(読解)・JNLI(含意判定)などの複数タスクを束ねたものです。原論文は LREC 2022 で公開されています(https://aclanthology.org/2022.lrec-1.317/)。測るのは「理解の底力」寄りで、生成品質を直接評価する系とは性格が違います。
4 本を 1 枚に重ねる読み方
ベンチが 4 本あると「結局どれを見ればよいのか」で迷いますが、性格が違うベンチが並んでいるだけで、1 本だけでは全体像が出ないという素直な話です。読み分けの指針を 1 枚にまとめます。
| 知りたいこと | 優先して見るベンチ |
|---|---|
| 自由応答の自然さ・敬語・表現力 | ELYZA-tasks-100 |
| 対話を 2 ターン続けたときの一貫性 | JMT-Bench |
| 読解・推論・常識の底力 | JGLUE |
| ざっくり総合でどの位置か | Nejumi LLM Leaderboard |
ELYZA-tasks-100 と JMT-Bench は LLM 審査員で採点されることが多いため、審査員と文体が似たモデルが高得点になりやすいという指摘があります。一方 JGLUE は正解ラベルのある客観採点なので、審査員の影響を受けません。両方の性格を併せて読むのが安全です。
モデル別の概要と公開スコア(2026 年 10 月時点)
本章では、まず各モデルの「実在サイズ・公開形態・日本語の扱い」を確認し、開発元がモデルカードで公開しているスコアがあればそれを引用します。リーダーボードの順位は更新頻度が高いので、本記事では順位を断定しません。最新順位は Nejumi で確認してください。
選ぶ前に確認する 3 点
ベンチのスコアを見る前に、次の 3 点でふるい落としをかけると失敗が減ります。
| 確認項目 | 該当する例 |
|---|---|
| 実在するサイズか | Qwen3 の密モデルは 0.6B / 1.7B / 4B / 8B / 14B / 32B、MoE は 30B-A3B と 235B-A22B。72B は前世代の Qwen2 / Qwen2.5 のサイズ |
| 重みが公開されているか | PLaMo 2 で重みが Hugging Face にあるのは 1B と 8B。31B を指示学習した PLaMo 2.0 Prime は API 提供。Llama-3-ELYZA-JP も重みの公開は 8B のみで、70B はデモ / API |
| 指示追従チューニング済みか | Sarashina2(7B / 13B / 70B / 8x70B)はベースモデル。SB Intuitions の Instruct 版は Sarashina2.2 の 0.5B / 1B / 3B |
出典:Qwen の Hugging Face 組織ページ、pfnet(PLaMo)、ELYZA の Llama-3-ELYZA-JP 公開記事、sarashina2-70b モデルカード(「Sarashina2 has not been tuned to follow an instruction yet.」と明記)。
大型帯(70B 以上・Q4 でも 40GB 超)
- Llama 3.3 Swallow 70B Instruct v0.4:Science Tokyo(旧東京工業大学)と産総研の Swallow チームが、Llama 3.3 70B に日本語の継続事前学習と指示学習をかけたモデルです。モデルカードに日本語タスクと日本語 MT-Bench のスコア表が公開されています(下の表)。
- Qwen3-235B-A22B:Qwen3 世代の最大 MoE(総パラメータ 235B、アクティブ 22B)。モデルカードで 100 以上の言語・方言のサポートを掲げています。Q4 でも 100GB を大きく超えるため、ローカルではメモリを大量に積んだ機材が前提です。
- Llama 4 Maverick / Scout:Meta の MoE で、Maverick は総 400B / アクティブ 17B、Scout は総 109B / アクティブ 17B です。ただしモデルカードの公式サポート言語は 12 言語で、日本語は含まれていません。日本語で使えないわけではありませんが、日本語用途の第一候補にする根拠は弱いです。
- Sarashina2 70B:SB Intuitions が公開した国産モデル(MIT ライセンス)です。前述のとおりベースモデルなので、チャットや RAG の生成器として使うには自前で指示学習をかける必要があります。
Swallow チームが Llama 3.3 Swallow 70B Instruct v0.4 のモデルカードで公開している比較表から、抜粋します。日本語 MT-Bench は審査員 gpt-4o-2024-08-06、0〜1 に正規化した 5 回平均です。JCom.(JCommonsenseQA)と JSQuAD は JGLUE 由来のタスクで、NIILC は日本語の知識を問う QA です。
| モデル | 日本語 MT-Bench 平均 | JCom. | JSQuAD | NIILC |
|---|---|---|---|---|
| Llama 3.3 70B Instruct | 0.737 | 0.941 | 0.893 | 0.570 |
| Llama 3.3 Swallow 70B Instruct v0.4 | 0.772 | 0.981 | 0.907 | 0.662 |
| Qwen2.5-72B-Instruct | 0.835 | 0.970 | 0.738 | 0.582 |
| GPT-4o(gpt-4o-2024-08-06) | 0.848 | 0.982 | 0.889 | 0.709 |
この表から読めるのは 2 点です。日本語の継続事前学習は、元の Llama 3.3 70B Instruct に比べて日本語の知識系(NIILC)と対話(MT-Bench)を押し上げています。一方で対話の採点では Qwen2.5-72B-Instruct のほうが上で、ベンチによって順位が入れ替わります。Qwen3 世代や 2026 年のモデルはこの表に含まれないので、新しい世代の位置は Nejumi で確認してください。
中位帯(24〜48GB VRAM)
- Qwen3-32B:Qwen3 の最大の密モデルで、思考モードと非思考モードを 1 つのモデルで切り替えられます(モデルカード)。Q4 量子化で 20GB 前後になり、VRAM 24GB に載る帯です。
- Qwen3-30B-A3B:総 30B / アクティブ 3B の MoE で、2507 版では Instruct 版(Qwen3-30B-A3B-Instruct-2507)も出ています。アクティブパラメータが小さいため、同じメモリに載る密モデルより生成が速くなりやすい構成です。
- Gemma 3 27B:Google 公開のオープンウェイトで、指示学習版は gemma-3-27b-it です。Q4 なら 24GB VRAM に載ります。
小型帯(8GB 前後)
- Llama-3-ELYZA-JP-8B:ELYZA が Llama 3 8B Instruct に日本語の追加事前学習と指示学習をかけたモデルで、重みが公開されています(モデルカード)。Q4 なら VRAM 8GB に収まります。
- Qwen3-8B:Qwen3 の 8B 密モデル。多言語対応を公式に掲げています。
- Sarashina2.2 Instruct(0.5B / 1B / 3B):SB Intuitions の指示学習済みモデルです。
- rinna nekomata(7B / 14B):Qwen(第 1 世代)を日本語で継続事前学習したモデルで、instruction 版もあります。
小型帯の公開スコアの例として、sarashina2.2-3b-instruct-v0.1 のモデルカードの比較表を抜粋します(評価設定は同カードからリンクされた flexeval のマニフェストを参照)。
| モデル | ELYZA-tasks-100 | 日本語 MT Bench |
|---|---|---|
| Qwen2.5-3B-Instruct | 2.99 | 5.68 |
| gemma-2-2b-jpn-it | 3.02 | 5.19 |
| sarashina2.2-3b-instruct-v0.1 | 3.75 | 6.51 |
上の大型帯の表とは審査員も尺度も違うので、2 つの表の数値を横に比べることはできません。同じ表の中だけで比べます。
なお 2026 年には Qwen3.5 / Qwen3.6、Gemma 4 など次の世代も Hugging Face に公開されています。新世代を含めた日本語性能の比較は「ローカルLLM 日本語性能比較 2026年版」で扱っています。VRAM 帯ごとに「何が載って Q4 で動くか」は「ローカルLLM メモリ容量別 動かせるモデル早見表 2026年版」で整理しているので、ハードウェア計画と合わせて参照してください。
ベンチマーク別の得意不得意
同じモデルでもベンチが変わると順位が入れ替わります。上の Swallow の表でも、JSQuAD では Qwen2.5-72B-Instruct(0.738)が他より低く、MT-Bench では Swallow より高いという逆転が出ています。4 本の性格差を押さえておくと、公開スコアを見たときに「なぜこのモデルがここで強いのか」が読み解けます。
ELYZA-tasks-100 で強いモデルの傾向
自由応答の表現力と指示追従を測るため、指示学習が丁寧なモデルが伸びます。ベースモデルはそもそも指示に答える形で学習されていないので不利です。LLM 審査員で採点する場合は、審査員との文体の近さも有利に働きます。
JMT-Bench で強いモデルの傾向
2 ターン対話の採点なので、1 ターン目の内容を踏まえて 2 ターン目を返す力が問われます。カテゴリ別のスコアを見ると、同じモデルでも writing や humanities は高く、reasoning や stem は低い、といった偏りが出ます。平均値だけでなくカテゴリ別の内訳を見るのがおすすめです。
JGLUE で強いモデルの傾向
多タスク精度の客観採点なので、言語理解の底力が素直に出ます。審査員がいない分、事前学習の質が反映されやすく、日本語の継続事前学習をしたモデルが元のモデルより伸びる傾向があります。上の表では JCom. で Llama 3.3 Swallow 70B Instruct v0.4 が 0.981 と、GPT-4o の 0.982 とほぼ並んでいます。
Nejumi で強いモデルの傾向
複数ベンチの集約指標なので、特定ベンチに偏らない「総合的に強い」モデルが上位に入ります。逆に言えば、自分の用途に効くカテゴリで強いモデルが総合順位では埋もれることもあるので、カテゴリ別の内訳も合わせて見てください。
保有実機での実測:日本語のトークン効率と、検索側の日本語ベンチ
ここまでのスコアはすべて公開値ですが、ローカルで日本語を扱うときに効く数字のうち 2 つは、保有している RTX 4070 12GB と Mac mini M4 16GB で測りました。
日本語 1 トークンあたりの文字数
同じ日本語の文(技術文 413 字と日常文 327 字、この計測のために書いたもの)を各モデルのトークナイザで数えました(2026-11-14、llama.cpp の llama-tokenize --no-bos)。文字/秒は、llama.cpp の tg128(空の文脈から 128 トークン生成)の tok/s に 2 文の平均の文字/トークンを掛けた値です。
| モデル(GGUF) | 文字/トークン(2 文の平均) | M4 文字/秒 | 4070 文字/秒 |
|---|---|---|---|
| Qwen3.6 35B-A3B UD-IQ2_XXS | 1.87 | 72.7 | 262.8 |
| Gemma 4 12B Q4_K_M | 1.78 | 24.6 | 109.6 |
| Gemma 3 12B Q4_K_M | 1.78 | 24.1 | 107.5 |
| Qwen3 8B Q4_K_M | 1.50 | 31.8 | 143.0 |
| Llama 3.2 3B Q4_K_M | 1.35 | 63.3 | 248.6 |
| gpt-oss-20b MXFP4 | 1.28 | 47.3 | 177.6 |
Qwen3.6 は gpt-oss の約 1.46 倍の文字を 1 トークンに詰めます。ベンチのスコアが同じくらいのモデルでも、日本語の出力の速さは tok/s の比より縮むことも広がることもあります。モデル別の詳細は「ローカルLLM 日本語性能比較 2026年版」に載せています。品質はここでは評価していません。
日本語の検索(埋め込み):JQaRA と MIRACL
RAG では、生成モデルの前に「日本語の文書を正しく拾えるか」が効きます。日本語の検索データの JQaRA(test から 100 問、1,000 文書)と MIRACL の日本語 dev(100 問、1,000 文書)で、埋め込みモデル 5 本の nDCG@10 を測りました(2026-11-13、llama.cpp の llama-server --embedding、すべて Q8_0、1 回)。表は RTX 4070 の値で、M4 との差は最大 0.003 でした。
| 埋め込みモデル | JQaRA nDCG@10 | MIRACL ja nDCG@10 |
|---|---|---|
| ruri-v3-310m | 0.890 | 0.850 |
| Qwen3-Embedding-4B | 0.851 | 0.881 |
| embeddinggemma-300m | 0.841 | 0.805 |
| bge-m3 | 0.813 | 0.858 |
| Qwen3-Embedding-0.6B | 0.753 | 0.812 |
2 つのデータで順位が入れ替わり、どちらでも上位だったのは Qwen3-Embedding-4B、どちらでも下位だったのは Qwen3-Embedding-0.6B でした。ruri-v3 は配布 GGUF が無く自前で変換したもので、Hugging Face transformers の参照実装で評価すると JQaRA 0.893 / MIRACL 0.872 と、MIRACL では 0.02 高くなります。bge-reranker-v2-m3 で上位 50 件を並べ替えると、どの埋め込みから始めても JQaRA は 0.848〜0.858、MIRACL は 0.915〜0.916 にそろいました。JQaRA の ruri-v3 のように、並べ替えで下がる場合もあります(0.890 → 0.858)。速度とメモリは「ローカル埋め込みモデル比較」で扱っています。
ベンチマーク採点の落とし穴
公開スコアを読むときに注意すべきバイアスが 3 つあります。
LLM 審査員バイアス
ELYZA-tasks-100 と JMT-Bench を LLM 審査員で採点する場合、審査員と文体や論理展開が似ているモデルが高評価になりやすい性質があります。審査員のモデル名も版によって変わります(上の Swallow の表は gpt-4o-2024-08-06)。読む側は「審査員が誰か」をスコアとセットで確認するのが安全です。
データ汚染
学習データに評価セットが混入してしまう「データ汚染」は、ELYZA-tasks-100 のように問題文が公開されたベンチで常に警戒されます。モデル発表直後にスコアが異常に高い場合、開発元がリークチェックの結果を明記しているかを確認するとよいでしょう。
few-shot 設定の差
JGLUE 系のタスクは zero-shot と few-shot(例示付き)でスコアが変わります。Swallow の表も JCom. は 4-shot、JMMLU は 5-shot と設定を明記しています。順位比較をするときは shot 数を揃えて見るのが鉄則で、設定条件を書かずに「X モデルがトップ」と言い切っている記事は注意して読む必要があります。
用途別の推奨モデル
ベンチの性格と公開状況を踏まえて、用途から逆算した候補をまとめます。
| 用途 | 推奨の第一候補 | 根拠 |
|---|---|---|
| 日本語チャット(24GB VRAM) | Qwen3-32B | Q4 で 24GB に載る密モデル。多言語対応を公式に掲げる |
| 日本語 RAG・固有名詞多め(48GB 以上) | Llama 3.3 Swallow 70B Instruct v0.4 | 日本語の知識系 QA(NIILC)で元モデルを上回る(0.662 対 0.570、モデルカード) |
| コーディング中心(日本語コメント) | Qwen3-Coder-30B-A3B-Instruct | Qwen3 世代のコード特化 Instruct 版。MoE でアクティブ 3B |
| 品質最優先(大容量メモリ機) | Qwen3-235B-A22B | Qwen3 世代の最大モデル。Q4 でも 100GB 超 |
| VRAM 8GB の最低ライン | Llama-3-ELYZA-JP-8B / Qwen3-8B | 日本語チューン済み、または多言語対応の 8B Instruct |
国産の Sarashina2 70B は日本語の事前学習モデルとして有力ですが、ベースモデルなので上の表には入れていません。自社データで指示学習をかける前提なら、出発点の候補になります。
モデル選定の意思決定フローそのものは「ローカルLLM モデルの選び方ガイド 2026年版」に、日本語性能に軸足を置いた比較は「ローカルLLM 日本語性能比較 2026年版」にまとめているので、本記事のベンチ読み方と合わせて参照してください。
評価データのソース
本記事で参照した主な一次情報は次のとおりです。最新スコアは必ず原典で確認してください。
- Nejumi LLM Leaderboard(W&B 公式、現行は Leaderboard 4): https://nejumi.ai/
- ELYZA-tasks-100(Hugging Face Datasets): https://huggingface.co/datasets/elyza/ELYZA-tasks-100
- JGLUE 論文(LREC 2022): https://aclanthology.org/2022.lrec-1.317/
- JMT-Bench(Stability AI の FastChat フォーク): https://github.com/Stability-AI/FastChat/tree/jp-stable/fastchat/llm_judge
- Llama 3.3 Swallow 70B Instruct v0.4 モデルカード(日本語タスク・日本語 MT-Bench の比較表): https://huggingface.co/tokyotech-llm/Llama-3.3-Swallow-70B-Instruct-v0.4
- sarashina2.2-3b-instruct-v0.1 モデルカード(ELYZA-tasks-100・日本語 MT Bench の比較表): https://huggingface.co/sbintuitions/sarashina2.2-3b-instruct-v0.1
- Qwen3-32B モデルカード: https://huggingface.co/Qwen/Qwen3-32B
- Llama 4 Scout モデルカード(サポート言語): https://huggingface.co/meta-llama/Llama-4-Scout-17B-16E-Instruct
本記事内のベンチのスコア(Nejumi・ELYZA-tasks-100・JMT-Bench・JGLUE・モデルカードの表)はこれらのリーダーボードとモデルカードからの引用です。「保有実機での実測」の節の文字/トークンと検索の nDCG@10 だけが、保有実機で測った値です。ハードウェアでの速度(tok/sec)側の仕組みは「メモリ帯域幅がローカルLLMの tok/sec を決める仕組み 2026年版」で別途まとめています。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- 日本語性能を一番信頼できるベンチマークはどれですか?
- 単一のベンチで決めず、Nejumi LLM Leaderboard(総合)・ELYZA-tasks-100(自由応答の表現力)・JMT-Bench(2 ターン対話)・JGLUE(読解と常識推論)の性格の違いを押さえて組み合わせて見るのが安全です。ELYZA-tasks-100 と JMT-Bench は LLM 審査員による採点が使われることが多く、審査員の癖がスコアに乗ります。JGLUE は正解ラベルのある客観採点です。1 本だけだと得意科目のモデルが過大評価されるため、本記事では 4 本の性格の違いを整理したうえで、モデル開発元が公開しているスコア表の読み方をまとめました。
- GPT-4o などのクローズドモデルとローカルで動く日本語モデルの差はどれくらいありますか?
- 公開されている比較の一例として、Swallow チームが Llama 3.3 Swallow 70B Instruct v0.4 のモデルカードで公開している日本語 MT-Bench(0〜1 に正規化、審査員 gpt-4o-2024-08-06)では、GPT-4o(gpt-4o-2024-08-06)が 0.848、Qwen2.5-72B-Instruct が 0.835、Llama 3.3 Swallow 70B Instruct v0.4 が 0.772 です。これは 2024〜2025 年のモデル同士の比較で、同じ審査員と設定のもとでの値です。最新の顔ぶれは Nejumi Leaderboard(https://nejumi.ai/)で確認してください。
- どのモデルを選べば日本語用途で後悔しないですか?
- 用途で分けるのが現実解です。日本語チャットと短文の下書きなら、Q4 量子化で VRAM 24GB に載る Qwen3-32B が候補になります。固有名詞や日本の知識を問う用途には、日本語継続事前学習をした Llama 3.3 Swallow 70B Instruct v0.4 が、モデルカードの日本語 QA(NIILC)で元の Llama 3.3 70B Instruct を上回っています(0.662 対 0.570)。コーディング中心なら Qwen3-Coder-30B-A3B-Instruct、VRAM 8GB なら Llama-3-ELYZA-JP-8B や Qwen3-8B です。Sarashina2 70B は指示追従チューニングがされていないベースモデルなので、そのままチャットや RAG には使えません。