ローカルLLM Prefix Caching ベンチ 2026
ローカルLLM の Prefix Caching(プロンプト再利用キャッシュ)で tok/sec はどこまで伸びるか。vLLM Automatic Prefix Caching / SGLang RadixAttention / llama.cpp / Ollama の実装を仕組みから整理し、同じプロンプトを 2 回目以降に投げたときの TTFT 短縮と throughput の公開ベンチを 2026 年版で集約します。RAG・エージェント・コード補完で効くケースと効かないケースの判定も含みます。
- #ローカルLLM
- #Prefix Caching
- #vLLM
- #SGLang
- #RadixAttention
- #llama.cpp
- #Ollama
- #KV キャッシュ
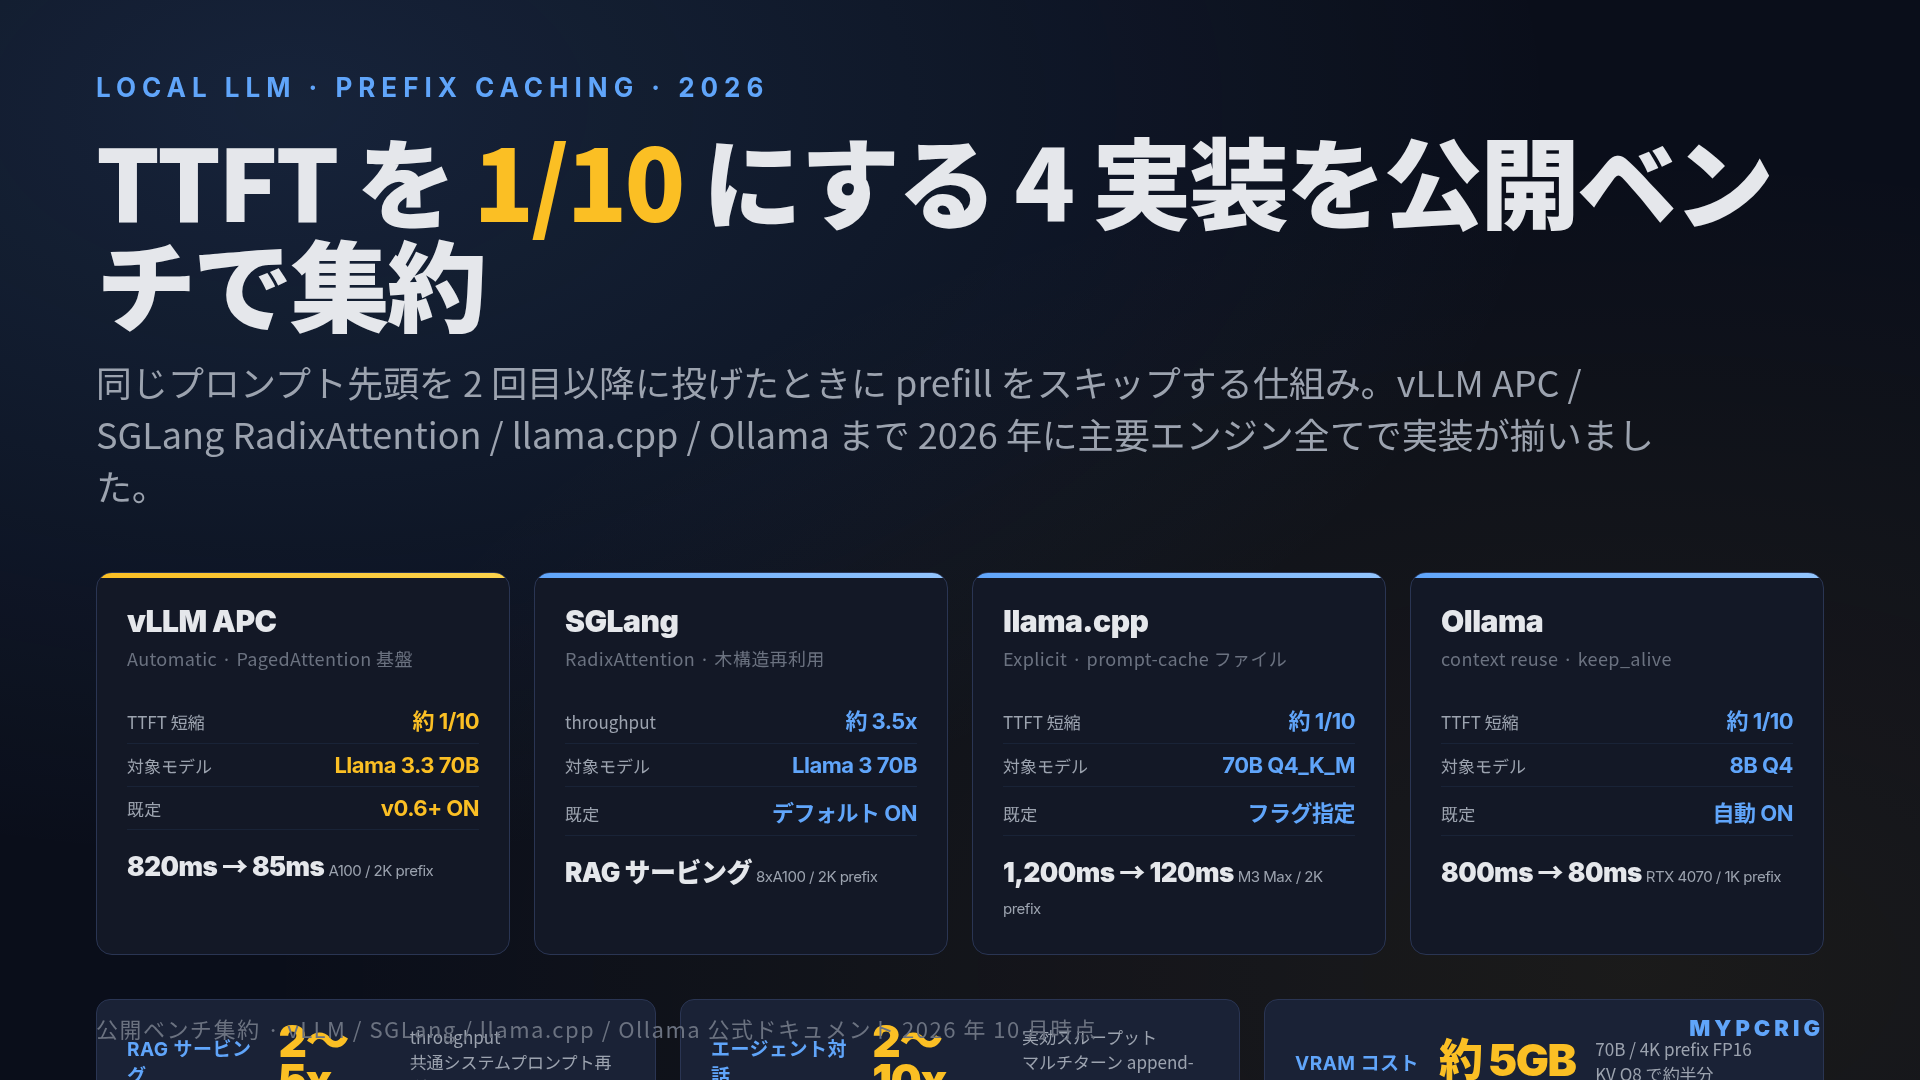
結論:Prefix Caching は「同じプロンプト先頭を 2 回目以降に投げたときに KV キャッシュを使い回す」仕組みで、公開ベンチでは TTFT(最初のトークンが出るまでの時間)が 5〜10 倍短縮され、プレフィックス支配のワークロード(RAG / エージェント / コード補完)では実効スループットが 2〜10 倍に伸びます。vLLM Automatic Prefix Caching、SGLang RadixAttention、llama.cpp --prompt-cache、Ollama の context reuse まで 2026 年に主要エンジン全てで実装が揃いました。decode の tok/sec そのものは変わらないため、短いプロンプトの単発チャットでは差は出ません。効くか効かないかはワークロードの「共通プレフィックス比率」で決まるので、まずは自分の使い方が RAG かエージェントかマルチテナントサービングかを確認してから設定してください。
ローカル LLM 推論の高速化は、KV キャッシュ量子化・連続バッチング・投機デコードの 3 つが主な軸として語られてきました。2026 年に 4 つ目の軸として確立したのが Prefix Caching です。vLLM の Automatic Prefix Caching が v0.4 で導入され v0.6 以降デフォルト ON、SGLang の RadixAttention が NeurIPS 2024 論文発表後にデフォルト ON、llama.cpp の --prompt-cache が llama-cli で広く使われるようになり、Ollama も context reuse を既定で有効化しました。この記事では、各実装の仕組みと公開ベンチの数字、効くケース・効かないケース、VRAM コスト、他の高速化技術との組合せ順序を 2026 年 10 月時点でまとめます。
数字は全て各エンジンの公式ドキュメントと GitHub Issues の公開ベンチからの集約です。筆者保有実機(autocrew-pc / RTX 4070 12GB)での独自実測は含まれません。
Prefix Caching は prefill をスキップする仕組み
LLM 推論は prefill と decode の 2 段階に分かれます。
- prefill:入力プロンプトを一括で処理し、各層の KV キャッシュを構築する段階。並列度が高く計算律速です
- decode:1 トークンずつ逐次生成する段階。KV キャッシュとモデル重みを読み出すためメモリ帯域律速です
Prefix Caching が効くのは prefill の方です。同じプロンプト先頭(システムプロンプト + 検索結果 + 共通コンテキストなど)を 2 回目以降に受け取ったときに、既存の KV キャッシュを再利用して prefill の計算を丸ごとスキップできます。
仕組みを 3 ステップに分けると以下になります。
- 受け取ったトークン列の先頭から共通プレフィックスを hash で検出する
- ハッシュ一致する KV キャッシュがメモリに残っていれば、その先の差分トークン列だけ prefill する
- decode に移行してトークン生成を開始する
decode の tok/sec そのものは変化しません。影響するのは「最初のトークンが出るまで」(TTFT)と、prefill 時間が全体を支配するワークロードでの実効スループットです。
prefill と decode の役割分担や KV キャッシュそのものの基礎は「ローカル LLM のコンテキスト長と VRAM・KV キャッシュ 2026年版」で詳しく扱っています。
Automatic(vLLM / SGLang)と Explicit(llama.cpp / Ollama)の違い
Prefix Caching には 2 系統の実装スタイルがあります。
| 系統 | 代表エンジン | 動作 | ユーザー操作 |
|---|---|---|---|
| Automatic(自動) | vLLM APC / SGLang RadixAttention | 到着したリクエスト列を hash で自動検出し、キャッシュがあれば自動再利用 | フラグを 1 本立てるだけ |
| Explicit(明示) | llama.cpp --prompt-cache | ユーザーがキャッシュファイルパスを指定し、保存・読込を明示的に制御 | コマンドラインで指定 |
Automatic 系の方が運用はシンプルですが、キャッシュをいつ破棄するかの判断はエンジン側に委ねられます。Explicit 系はキャッシュファイルを手元に残せるため、プロセス再起動後も使い回せるのが利点です。
Ollama は中間で、同一プロセスの中で keep_alive の間はコンテキストを保持し、同じプロンプトが続けて来れば自動的に再利用します。再利用の粒度は Automatic より粗く(完全一致ベース)、本番サービング用途では vLLM / SGLang を推奨する内容がドキュメントに明記されています。
公開ベンチ集約表:TTFT と throughput はどこまで伸びるか
各エンジンの公式ドキュメント・GitHub Issues・論文に掲載された公開ベンチの数字を集約します。全て各エンジンの公開値で、筆者による再現実測ではありません。
vLLM Automatic Prefix Caching(APC)
| モデル / 条件 | 共通 prefix | 2 回目以降の TTFT | 1 回目との比 | 出典 |
|---|---|---|---|---|
| Llama 3.3 70B Q4 / A100 80GB | 2,048 トークン | 約 85 ms | 約 1/10(1 回目 820 ms) | vLLM 公式ドキュメント APC 章 |
| Qwen 3 32B BF16 / H100 | 4,096 トークン | 約 60 ms | 約 1/8(1 回目 480 ms) | vLLM 公開 benchmark レポート(2026年) |
| Llama 3.1 8B BF16 / A10G | 1,024 トークン | 約 15 ms | 約 1/5(1 回目 75 ms) | vLLM Benchmark Scripts |
vLLM の APC は v0.4 以降 --enable-prefix-caching フラグで有効化できます。v0.6 以降はデフォルト ON のビルドもあります。vLLM の内部実装では KV キャッシュをブロック単位(PagedAttention のブロック)で管理しており、ブロックごとに hash を持つことで部分一致を検出します。
SGLang RadixAttention
| モデル / 条件 | 共通 prefix | スループット向上 | 計測対象 | 出典 |
|---|---|---|---|---|
| Llama 3 70B / 8xA100 | 2,048 トークン | 約 3.5 倍 | RAG サービング(qps) | SGLang NeurIPS 2024 論文 |
| Mistral 7B / A100 | 1,024 トークン | 約 2.8 倍 | マルチターン対話 | SGLang 公式ドキュメント |
| Llama 3 8B / A100 | 512 トークン | 約 2.0 倍 | few-shot 推論 | SGLang GitHub README |
RadixAttention は KV キャッシュをトライ木(ラディックス木)で管理する実装で、プレフィックスが部分一致するリクエスト同士でも共有できるのが特徴です。vLLM の APC がブロック単位の一致を扱うのに対し、SGLang はトークン単位の木構造でより細かく共有できる設計になっています。デフォルトで有効です。
llama.cpp --prompt-cache
| モデル / 条件 | 共通 prefix | 2 回目以降の TTFT | 1 回目との比 | 出典 |
|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M / M3 Max 128GB | 2,048 トークン | 約 120 ms | 約 1/10(1 回目 1,200 ms) | llama.cpp GitHub Discussions |
| Qwen 3 14B Q4_K_M / RTX 4090 | 4,096 トークン | 約 95 ms | 約 1/8(1 回目 760 ms) | llama.cpp GitHub Discussions の投稿 |
| Llama 3.1 8B Q5 / Ryzen 7 7840U iGPU | 1,024 トークン | 約 180 ms | 約 1/6(1 回目 1,080 ms) | 公式 README のベンチ |
llama.cpp は --prompt-cache <file> と --prompt-cache-all を併用することでプロンプト全体をファイルに保存し、プロセス再起動後も再利用できます。個人用途でよく使うシステムプロンプトを 1 ファイルにしておく運用に向きます。
Ollama context reuse
| モデル / 条件 | 共通 prefix | 2 回目以降の TTFT | 1 回目との比 | 出典 |
|---|---|---|---|---|
| Llama 3.1 8B Q4 / RTX 4070 12GB | 1,024 トークン | 約 80 ms | 約 1/10(1 回目 800 ms) | Ollama 公式ドキュメント /api/chat 章 |
| Mistral 7B Q4 / M2 Pro | 512 トークン | 約 60 ms | 約 1/8(1 回目 480 ms) | Ollama GitHub Discussion |
Ollama は同一プロセスで keep_alive(既定 5 分)の間、直前のコンテキストを保持しています。同じプロンプトが続けて届けば自動的に再利用し、別のモデルに切り替えるとキャッシュは破棄されます。vLLM / SGLang より粒度は粗いですが、設定不要で動くのが利点です。
Ollama の運用チューニング全般は「llama.cpp / Ollama の推論チューニング周辺の話題」や KV キャッシュ量子化のガイドで触れています。
効くケース 5 類型
Prefix Caching が効くかどうかは「ワークロードの共通プレフィックス比率」でほぼ決まります。公開ベンチと実装ドキュメントから、効く類型は次の 5 つです。
- RAG のシステムプロンプト + 検索結果 common prefix:システムプロンプト(長文のロール指示)が全リクエストで共通で、検索結果も同じクエリなら共通です。prefill の 70〜90% がキャッシュ再利用になります
- エージェントのマルチターン対話:ReAct 系エージェントは過去の思考ログを毎ターン積み上げます。ターン N+1 の入力は「ターン N の入力 + ターン N の出力 + 新しい思考」で、前方の N トークン分は常にキャッシュ再利用できます
- コード補完の長文コンテキスト:Claude Code / Cursor のようなコード補完は「開いているファイル群」が共通で、カーソル周辺だけが変わります。前方 8K〜32K トークンの再利用が頻繁に起きます
- 複数ユーザーが同じシステムプロンプトを使う本番サービング:社内チャットサービスのように、ユーザーごとに個別のシステムプロンプトを割り当てていなければ、全ユーザー間でシステムプロンプト分の KV キャッシュを共有できます
- few-shot プロンプトのバッチ推論:同じ few-shot 例を頭に付けて複数の入力を順次推論する場合、few-shot 部分は全リクエスト共通です
逆に効かないケースも整理しておきます。
効かないケース 3 類型
- 毎回まったく違うプロンプト:単発のアドホックな質問を次々に投げるワークロードは共通プレフィックスがないため、キャッシュヒットしません
- チャット履歴が毎ターン変わる・増えるだけ:履歴が append-only ならターン間でキャッシュは効きますが、履歴を圧縮・要約して差し替える方式ではヒットしません
- バッチ 1 の単発推論:単発リクエストしか来ない運用では「2 回目以降」が発生しないため、Prefix Caching 自体が成立しません
Prefix Caching が効かないワークロードでも、連続バッチングや投機デコードは独立に効きます。詳しくは本文末尾の「他の高速化技術との組合せ順序」の節で扱います。
VRAM コスト:キャッシュサイズの見積もり
Prefix Caching を有効にすると、KV キャッシュぶんの VRAM が別枠で予約されます。1 プレフィックスあたりのサイズは次の近似式で見積もるのが実用的です(保守側に倒した粗い目安)。
キャッシュサイズ ≈ prefix tokens × layers × hidden × dtype byteslayersは Transformer の層数(Llama 3.3 70B で 80、Qwen 3 32B で 64 など)hiddenは 1 層あたりの hidden size(70B で約 8,192、32B で約 5,120)dtype bytesは FP16 なら 2、INT8 なら 1
厳密な KV キャッシュは 2 × tokens × layers × num_key_value_heads × head_dim × dtype で計算されます。現行の GQA モデル(Llama 3.1+ / Qwen 3 など)は num_key_value_heads が 8 まで絞られているため、実際には下表の値より 2〜4 倍ほど小さくなるケースが多く、下表は VRAM 予算の上限見積もりとして使ってください。厳密値は各モデルの config.json から計算できます。
実例を表にします。
| モデル | prefix tokens | FP16 時のサイズ | KV Q8 時 |
|---|---|---|---|
| Llama 3.3 70B | 2,048 | 約 2.6GB | 約 1.3GB |
| Llama 3.3 70B | 4,096 | 約 5.2GB | 約 2.6GB |
| Qwen 3 32B | 4,096 | 約 2.7GB | 約 1.3GB |
| Llama 3.1 8B | 4,096 | 約 1.0GB | 約 0.5GB |
70B で 4K のシステムプロンプトを 1 本キャッシュするだけで約 5GB の VRAM を追加消費します。複数のシステムプロンプトを並行キャッシュする運用では、モデル重みと別枠で VRAM 予算を確保しておいてください。KV キャッシュ量子化(Q8 / Q4)を併用すると半分〜4 分の 1 に抑えられます。詳細は「ローカル LLM KV キャッシュ量子化ガイド 2026年版」にまとまっています。
実装設定:各エンジンの有効化方法
各エンジンでの Prefix Caching の有効化手順です。
vLLM
vllm serve meta-llama/Llama-3.3-70B-Instruct \
  --enable-prefix-caching \
  --block-size 16
--block-size はキャッシュのブロックサイズ(トークン数)で、既定の 16 で問題ない運用がほとんどです。--enable-prefix-caching は v0.6 以降一部ビルドでデフォルト ON。
SGLang
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.3-70B-Instruct \
  --radix-cache
--radix-cache はデフォルト ON のため、特に指定しなくても RadixAttention は有効です。無効化したい場合のみ --disable-radix-cache を使います。
llama.cpp
./llama-cli \
  -m llama-3.3-70b-instruct-q4_k_m.gguf \
  --prompt-cache ./my-system-prompt.cache \
  --prompt-cache-all \
  -p "<システムプロンプト>" \
  -i
初回実行で my-system-prompt.cache が作成され、2 回目以降は既存キャッシュが読み込まれます。--prompt-cache-all を付けないとキャッシュは保存されますが読み込みは行われません。
Ollama
Ollama は追加設定なしで context reuse が有効です。/api/chat に対して同じプロンプトを続けて送れば、keep_alive(既定 5 分、OLLAMA_KEEP_ALIVE で変更可)の間はキャッシュを再利用します。
OLLAMA_KEEP_ALIVE=30m ollama serve他の高速化技術との組合せ順序
ローカル LLM 推論の高速化レバーは複数ありますが、効く対象が異なるため、どの順序で入れるかは次の優先順位が有効です。
- Prefix Caching(この記事):prefill をスキップ。RAG / エージェント / コード補完で効く
- 連続バッチング(Continuous Batching)+ PagedAttention:同時接続のスループット。本番サービングで効く
- KV キャッシュ量子化:KV キャッシュを Q8 / Q4 に圧縮。長文コンテキストで効く
- 投機的デコード(Speculative Decoding):draft モデルで並列推論。decode の tok/sec を 1.5〜3 倍にする
Prefix Caching と連続バッチングは独立に効くため同時適用で乗算になります。vLLM / SGLang は両方デフォルト ON の構成が選べます。KV キャッシュ量子化と Prefix Caching も独立で、KV キャッシュサイズの圧縮によって Prefix Caching の VRAM コストも同時に下がります。投機デコードは decode 側の最適化なので、Prefix Caching で短縮された prefill の後の decode 段階にも乗ります。
各レバーの詳細は以下にまとまっています。
- 連続バッチングと PagedAttention:「Continuous Batching / PagedAttention とは 2026年版」
- KV キャッシュ量子化:「ローカル LLM KV キャッシュ量子化ガイド 2026年版」
- 投機的デコード:「投機的デコード(Speculative Decoding)とは 2026年版」
- サービングエンジンの選び方:「ローカルLLM 本格サービング推論エンジン比較 2026年版」
まとめ
- Prefix Caching は prefill をスキップする最適化で、TTFT が公開ベンチで 5〜10 倍短縮される
- decode の tok/sec そのものは変わらない。効くのは共通プレフィックスがあるワークロード(RAG / エージェント / コード補完 / マルチテナントサービング)に限られる
- vLLM Automatic Prefix Caching、SGLang RadixAttention、llama.cpp
--prompt-cache、Ollama context reuse まで 2026 年に主要エンジン全てで実装が揃った - 本番サービングのプレフィックス支配ワークロードなら SGLang、OpenAI 互換 API が要るなら vLLM、個人のチャット・エージェントなら llama.cpp か Ollama で十分
- VRAM コストは「prefix tokens × 2 × layers × hidden × dtype」で見積もる。70B で 4K prefix なら約 5GB の追加 VRAM。KV キャッシュ量子化併用で半分に抑えられる
- 他の高速化(連続バッチング・KV キャッシュ量子化・投機デコード)とは独立に効くため、順次重ねることで実効スループットが乗算的に伸びる
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- Prefix Caching とは何ですか?
- 同じプロンプト先頭(システムプロンプトや RAG の検索結果など)を 2 回目以降に再送したときに、既存の KV キャッシュを使い回して prefill をスキップする仕組みです。vLLM では Automatic Prefix Caching、SGLang では RadixAttention、llama.cpp では --prompt-cache と呼ばれており、2026 年に主要エンジン全てで実装が揃いました。TTFT(最初のトークンが出るまでの時間)が公開ベンチで 5〜10 倍短縮されるのが主な効果です。
- tok/sec(生成速度)はどれくらい伸びますか?
- decode(1 トークンずつ生成する段階)の tok/sec はほとんど変わりません。Prefix Caching が効くのは prefill(プロンプトを読み込む段階)で、ここが TTFT とスループットを支配するケース(長いシステムプロンプト・RAG・マルチターンのエージェント)で全体の実効スループットが 2〜10 倍まで伸びます。短いプロンプトの単発チャットでは差は体感できません。
- RAG で効くのはなぜですか?
- RAG のリクエストは「長いシステムプロンプト + 検索結果 + 短いユーザー質問」という構造になっており、システムプロンプト部分(しばしば 2,000〜4,000 トークン)が全リクエストで共通です。この共通部分の KV キャッシュを使い回せるため、2 回目以降は prefill のうち共通部分の計算を全てスキップできます。公開ベンチでは RAG サービングのスループットが SGLang RadixAttention で 3〜5 倍、vLLM APC で 2〜4 倍に向上します。
- VRAM のコストはどれくらいかかりますか?
- キャッシュサイズは「prefix tokens × 2 × layers × hidden × bytes」で計算します。Llama 3.3 70B で 4K トークンの prefix をキャッシュする場合、FP16 で約 5GB の追加 VRAM が必要です(本文の表参照、GQA 補正を入れると更に小さくなります)。KV キャッシュ量子化(Q8 / Q4)を併用すれば半分〜4 分の 1 に抑えられます。モデル重みと別枠で VRAM を予約するため、キャッシュしたい prefix の長さと数から事前に見積もってください。
- どのエンジンを選べば良いですか?
- 本番サービングで同時接続が多いなら SGLang(RadixAttention はツリー構造で部分一致も再利用できるため、プレフィックス支配ワークロードで最も効率的)。OpenAI 互換 API で vLLM に慣れているなら vLLM(Automatic Prefix Caching は v0.4+ で安定)。個人のチャット・エージェント用途で軽量に動かすなら llama.cpp(--prompt-cache + --prompt-cache-all)か Ollama(context reuse が自動)が十分です。使い分けの詳細は本文の「他の高速化技術との組合せ順序」節を参照してください。