ローカルLLM RAG vs Fine-tuning 2026
ローカルLLM に新しい知識を入れたいとき RAG と Fine-tuning のどちらを選ぶかを 6 つの判断軸で整理し、社内文書Q&A・コード補完・キャラ応答・エージェント用途ごとに最適解と VRAM 目安をまとめます。
- #ローカルLLM
- #RAG
- #Fine-tuning
- #QLoRA
- #AI開発PC
- #VRAM
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
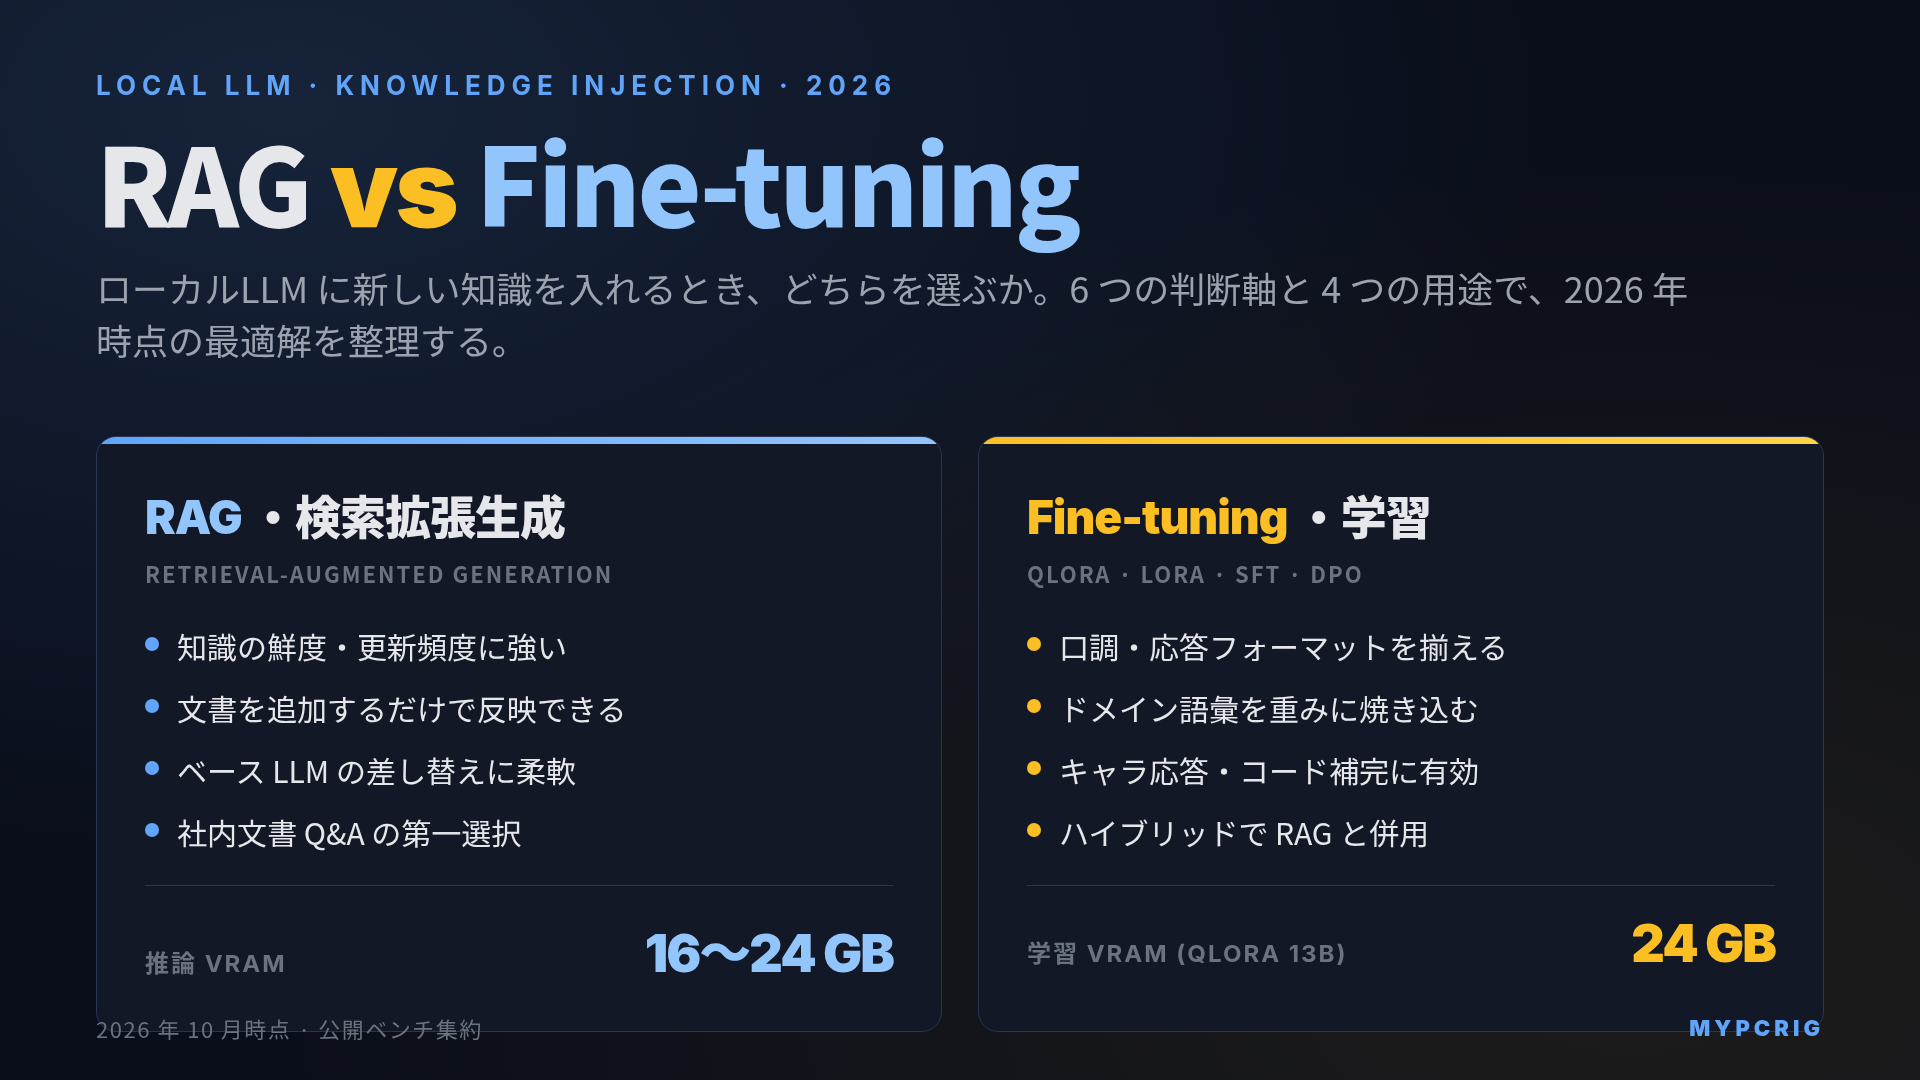
結論:ローカルLLM に新しい知識を入れるときは、まず RAG で足りるかを検討し、口調・出力形式・ドメイン語彙の学習が目的なら Fine-tuning を重ねます。社内文書Q&A は RAG 単独、キャラ応答・口調固定は Fine-tuning 単独、コード補完とエージェント用ツール呼び出しは Fine-tuning + RAG のハイブリッドが 2026 年時点の現実解です。VRAM 目安は RAG 推論が 16GB からで実用は 24GB、QLoRA 7B の学習が 12〜16GB、13B の学習が 20〜24GB、70B は 48GB 以上。本記事は保有実機で学習を回したデータではありません。公開ベンチと論文を集約した判断ガイドです。
RAG と Fine-tuning はどちらも「素のモデルでは答えられない内容を答えさせる」ための手段です。ただし何を学ばせられるかが根本的に違います。両者を混同すると「社内文書を Fine-tuning で詰め込もうとして半年ハマる」「口調を揃えたいだけなのに RAG を組んで迷走する」というミスマッチが起きます。
本稿は保有実機の QLoRA 走行ログや RAG のベンチを提示する記事ではありません。保有実機は autocrew-pc 1 台(RTX 4070 12GB)のみで、QLoRA 70B や 32GB クラスでの長時間学習は実測していません。この記事では公開論文・ベンダー資料・llama.cpp / Transformers / HuggingFace の公式ドキュメントを突き合わせて、判断の軸と VRAM 目安を整理します。数値には出典 URL を付けます。
RAG そのものの仕組みは「RAG (Retrieval-Augmented Generation) とは 2026年版」、学習手法の内部動作は「LoRA / QLoRA / DPO / SFT 学習手法を仕組みから比較 2026年版」で別途扱っています。本稿は両者の「どちらを選ぶか」に焦点を絞ります。
判断フローチャート(結論先出し)
迷ったら上から順にチェックしてください。
- 答えさせたいのはドキュメントに書いてある事実ですか?
- はい → RAG 単独 を第一選択に
- 答えさせたいのは口調・応答フォーマット・ドメイン語彙ですか?
- はい → Fine-tuning 単独(QLoRA + SFT or DPO)
- コード補完や特定ドメインの文法を学ばせたうえで、最新 API リファレンスも参照させたいですか?
- はい → Fine-tuning + RAG のハイブリッド
- ツール呼び出しの JSON 形式は固定で、文脈は毎回変わりますか?
- はい → Fine-tuning(形式学習)+ RAG(文脈供給) のハイブリッド
- 判断に迷う → まず RAG から始める のが安全です。Fine-tuning はデータ整備と学習時間のコストが段違いに大きいため、RAG で CMD/コスト要件を満たせるならそこで止めるのが実務上の最適解です
判断軸マトリクス(6 軸比較)
| 判断軸 | RAG が強い場合 | Fine-tuning が強い場合 |
|---|---|---|
| ① 知識の鮮度 | 文書を追加するだけで反映できる | 再学習が必要で日次更新は非現実的 |
| ② 口調・出力形式・ドメイン語彙 | プロンプトで誘導できる範囲に限る | パラメータ側に内在化できる |
| ③ 機密データ量 | 文書数が増えても検索精度が落ちにくい | 学習データが少ないと過学習 |
| ④ 更新頻度 | 日次・週次更新に向く | 月次〜四半期の再学習が現実的 |
| ⑤ VRAM・時間コスト | 推論 VRAM + 2〜4GB(埋め込み)、構築 1 日 | QLoRA 7B で 12〜16GB + 数時間〜半日、13B で 20〜24GB + 半日〜1 日、70B で 48GB + 数日 |
| ⑥ モデル差し替え容易性 | ベース LLM を差し替えても文書は使い回せる | 学習済みアダプタはベースモデルに紐付く |
RAG の強みは「①の鮮度」「④の更新頻度」「⑥の差し替え容易性」です。文書は資産として残り、ベース LLM が Qwen 3 から Qwen 4 に変わっても埋め込み済みの文書は再利用できます。
Fine-tuning の強みは「②の口調・形式・語彙」です。「このキャラは常体で返す」「出力は必ず特定 JSON スキーマ」「医療用語を正しく展開する」といった、プロンプトの明示だけでは安定しない要件を、重みに焼き込めます。
③の機密データ量は意外にも RAG が優位です。1 万件以上のドキュメントを Fine-tuning で詰め込もうとすると、同じ事実を複数の角度から学習させる必要があり、データ整備工数が爆発します。RAG なら文書をそのままインデックス化できます。LoRA / QLoRA の精度上限は「LoRA / QLoRA / DPO / SFT 学習手法を仕組みから比較 2026年版」の FAQ でも扱っていますが、QLoRA 論文は 65B モデルを単一 48GB GPU で学習でき、16bit full fine-tuning に匹敵する精度を達成したと報告しています(出典: QLoRA paper (Dettmers et al., 2023))。
用途別の最適解(4 類型)
類型1:社内文書Q&A(RAG 単独)
社内 Wiki・議事録・就業規則の Q&A は RAG 単独で組むのが定石です。文書は日々更新されます。質問は多岐にわたります。回答の根拠を本文中の引用で示せます。Fine-tuning で詰め込もうとすると、文書追加のたびに再学習が必要になり運用が破綻します。
- 典型構成: 埋め込みモデル(multilingual-e5-large / bge-m3 / ruri-large)+ ベクトルDB(Chroma / Qdrant)+ LLM(Qwen 2.5 14B / Gemma 2 9B 系)
- 必要 VRAM: 推論用 14B Q4 で約 10GB + 埋め込み 2〜3GB、合計 16GB で下限、24GB で安定
- 推奨ハード: RTX 5070 Ti 16GB / RTX 5080 16GB / Mac mini M4 Pro 24GB 以上
- 構築手順と VRAM 配分の詳細は「ローカルRAG構築向けPC構成ガイド 2026年版」
類型2:キャラ応答・口調固定(Fine-tuning 単独)
キャラクタの応答生成、特定ブランドのトーン&マナーに揃えた顧客対応、常体/敬体の統一などは Fine-tuning 単独が向きます。学ばせたいのは知識よりも「スタイル」側だからです。プロンプトで 「常体で返してください」 と指示しても、長文応答や敬体混在のユーザー入力に対して、途中で敬体に戻る回帰が起きます。SFT で数百〜数千件の正例を学習させるとこの揺れが消えます。
- 典型構成: Qwen 2.5 7B / Llama 3.1 8B 系 + QLoRA + SFT(または SFT 後に DPO)
- 必要 VRAM: QLoRA 7B で約 12〜16GB、13B で約 24GB、推論のみなら 7B Q4 で 8GB
- 推奨ハード: RTX 5070 Ti 16GB / RTX 5080 16GB(7B 学習)、RTX 5090 32GB(13B 学習)
- 学習手法ごとの違いは「LoRA / QLoRA / DPO / SFT 学習手法を仕組みから比較 2026年版」
類型3:コード補完(Fine-tuning + RAG のハイブリッド)
自社フレームワーク向けのコード補完は、言語の文法(Python / TypeScript 等)はベース LLM が学習済みで、追加で必要なのは「自社固有の関数シグネチャ」と「最新 API リファレンス」です。前者は QLoRA で焼き込み、後者は RAG で引く構成が実用的です。
- 典型構成: Qwen 2.5 Coder 14B / DeepSeek Coder V2 Lite + QLoRA(社内コードベースから生成した instruction データ)+ RAG(API docs の埋め込み)
- 必要 VRAM: 14B QLoRA 学習で約 20〜24GB、推論と埋め込み同居で約 16〜24GB
- 推奨ハード: RTX 5090 32GB(学習と推論を同一機で)、推論だけなら RTX 5070 Ti 16GB
- API リファレンスは Markdown の章節ごとに埋め込みます。関数シグネチャは関数単位でチャンク分割すると検索精度が上がります
類型4:エージェント用ツール呼び出し(Fine-tuning + RAG のハイブリッド)
MCP / Function Calling / Tool use を安定させたい場合、「ツール呼び出しの JSON スキーマは固定、ツール一覧と最新説明は毎回変わる」という構造になります。前者は Fine-tuning で、後者は RAG で供給します。
- 典型構成: Qwen 2.5 14B / Llama 3.1 8B + QLoRA(Tool use SFT データ)+ RAG(ツール説明の埋め込み)
- 必要 VRAM: 推論と埋め込み同居で約 16〜24GB、学習時は 20〜24GB
- 推奨ハード: RTX 5080 16GB / RTX 5090 32GB、Mac Studio M4 Max 48GB
- ツール呼び出しに特化した公開モデルとして Salesforce xLAM-7b-fc-r、学習データセットとして Salesforce xlam-function-calling-60k が参考になります
4 類型の対応表を再掲します。
| 用途 | 手法 | VRAM 目安 | 推奨ハード |
|---|---|---|---|
| 社内文書Q&A | RAG 単独 | 16〜24GB | RTX 5070 Ti / 5080 / Mac mini M4 Pro |
| キャラ応答・口調固定 | Fine-tuning 単独 | 7B 学習 12〜16GB / 13B 学習 24GB | RTX 5070 Ti / 5090 |
| コード補完 | Fine-tuning + RAG | 16〜32GB | RTX 5090 / Mac Studio M4 Max |
| エージェント用ツール呼び出し | Fine-tuning + RAG | 16〜24GB | RTX 5080 / 5090 |
VRAM 要件の目安(RAG 推論・Fine-tuning 学習)
RAG と Fine-tuning では「同じ 24GB」でも使い方が違います。整理します。
RAG 推論の VRAM 内訳
| 要素 | VRAM 消費目安 | 補足 |
|---|---|---|
| LLM 本体(14B Q4) | 約 9〜10GB | Qwen 2.5 14B Instruct 相当 |
| 埋め込みモデル(multilingual-e5-large) | 約 2〜3GB | 1024 次元 |
| ベクトルDB(Chroma / Qdrant) | 1GB 未満 | インデックス側は RAM で持つ |
| コンテキスト・KV cache | 1〜2GB | 文脈 8k〜32k で変動 |
| 合計 | 約 13〜16GB | 24GB あれば 32B クラスまで同居可能 |
出典: Qwen 2.5 Technical Report / intfloat/multilingual-e5-large モデルカード。
Fine-tuning(QLoRA)の VRAM 目安
| モデル | 手法 | 必要 VRAM | 典型的な学習時間(1 エポック) |
|---|---|---|---|
| 7B | QLoRA 4bit | 約 12〜16GB | 数時間〜半日 |
| 13B | QLoRA 4bit | 約 20〜24GB | 半日〜1 日 |
| 32B | QLoRA 4bit | 約 32〜40GB | 1〜2 日 |
| 70B | QLoRA 4bit | 約 46〜48GB | 2〜3 日 |
出典: QLoRA paper (Dettmers et al., 2023)、Transformers Trainer QLoRA ガイド。
70B QLoRA は RTX PRO 6000 Blackwell 96GB 1 枚、またはデュアル RTX 5090(合計 64GB、FSDP / DeepSpeed ZeRO 併用)で安定します。Mac Studio M3 Ultra 128GB ユニファイドメモリでも 70B QLoRA は走りますが、同等 VRAM の NVIDIA GPU と比べると学習速度は数倍遅くなるのが一般的です(MLX LoRA のサンプル実装: ml-explore/mlx-examples/lora)。ファインチューニング機の詳細な構成は「ローカルLLM ファインチューニング向けPC構成ガイド 2026年版」を参照してください。
ハイブリッド構成を組むときの実務ポイント
Fine-tuning + RAG を同じマシンで動かすときに起きがちな摩擦を整理します。
- 埋め込みモデルと LLM の VRAM を同時確保する: 推論時に 2 つのモデルをロードするため、合計で 16〜24GB を確保してください。bge-m3 や multilingual-e5-large は VRAM 2〜3GB、ruri-large は 1.3GB で軽量です。日本語ドキュメントなら ruri-large を優先するだけで 1〜2GB 浮きます(出典: cl-nagoya/ruri-large モデルカード)
- 学習と推論を同じ GPU で混ぜない: QLoRA 学習中は VRAM をほぼ使い切ります。推論を同時に走らせたい場合は、GPU を分けるか、学習時間をずらす運用にしてください
- 埋め込みモデルの選定は「ローカルLLM 向け埋め込みモデル比較 2026年版」、Reranker を足すなら「ローカルLLM 向け Reranker モデル比較 2026年版」が参考になります
- ベースモデルの差し替え前提で設計する: Fine-tuning アダプタはベースモデルに紐付きます。ベース LLM を 1 年後に差し替えると、QLoRA アダプタは作り直しです。RAG 側の文書は差し替えても再利用できるので、「変わりやすい部分は RAG、変わりにくい部分は Fine-tuning」の分離が運用コストを下げます
よくある誤解
- 「Fine-tuning なら社内の最新情報も覚えられる」 → 覚えますが、翌週に新しい議事録が増えたらまた再学習が必要です。日次更新がある領域は RAG の守備範囲です
- 「RAG はプロンプトが長くなるからコストが高い」 → ベースの LLM 推論と比べて、関連文書 3〜5 件を差し込むぶんコンテキストが 2〜4k トークン増えます。ローカル運用ではトークン課金が無いため、追加コストは速度ペナルティのみ(10〜30% 遅くなる程度)です
- 「Fine-tuning で正解を暗記させれば RAG は不要」 → 事実を暗記させると、学習データに無い類題で誤答する「ハルシネーション」が増えます。事実の供給は RAG、挙動のチューニングは Fine-tuning、と役割を分けるのが安全です
まとめ
- 迷ったら RAG から始める。知識の鮮度・更新頻度・モデル差し替え容易性で RAG が優位
- 口調・応答フォーマット・ドメイン語彙を揃えたいなら Fine-tuning
- コード補完とエージェント用ツール呼び出しはハイブリッドが実用的
- VRAM 目安は RAG 推論 16〜24GB、QLoRA 7B/13B 学習 12〜24GB、70B QLoRA は 48GB 以上
- 「変わりやすい部分は RAG、変わりにくい部分は Fine-tuning」で分離する
数値の裏取りは、埋め込みモデル・ベクトルDB・LLM の役割分担を扱った「RAG (Retrieval-Augmented Generation) とは 2026年版」と、学習手法 4 種類を仕組みレベルで比較した「LoRA / QLoRA / DPO / SFT 学習手法を仕組みから比較 2026年版」に揃えてあります。手法を決めたら、機材選定は「ローカルRAG構築向けPC構成ガイド 2026年版」「ローカルLLM ファインチューニング向けPC構成ガイド 2026年版」へ進んでください。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
各類型の代表 GPU を 1 枚ずつ挙げます。
- RAG 推論・16GB クラス: GeForce RTX 5070 Ti 16GB を Amazon.co.jp で見る
- Fine-tuning・13B〜32B QLoRA 対応: GeForce RTX 5090 32GB を Amazon.co.jp で見る
- 70B QLoRA 1 枚運用: NVIDIA RTX PRO 6000 Blackwell 96GB を ELSA (国内代理店) の製品ページで見る
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート