Continue.dev × Ollama コード補完 2026
Continue.dev は Cursor 買収後もコミュニティ管理の Apache 2.0 コードベースが残り、Ollama + Qwen3-Coder 30B A3B / Qwen2.5-Coder 1.5B の組合せで無料ローカルコード補完が引き続き動きます。VS Code 拡張の config.yaml 実例(VRAM 12GB / 24GB / 48GB 別)、Autocomplete と Chat/Edit のモデル分離、Cline / Roo Code との使い分け、有料 Copilot と Claude Code Pro 月額との TCO 比較、Cursor 買収を踏まえた代替(Twinny / Tabby)まで整理します。
- #Continue.dev
- #Ollama
- #Qwen3-Coder
- #Qwen2.5-Coder
- #ローカルLLM
- #コード補完
- #config.yaml
- #VS Code
- #JetBrains
- #AI コーディング
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
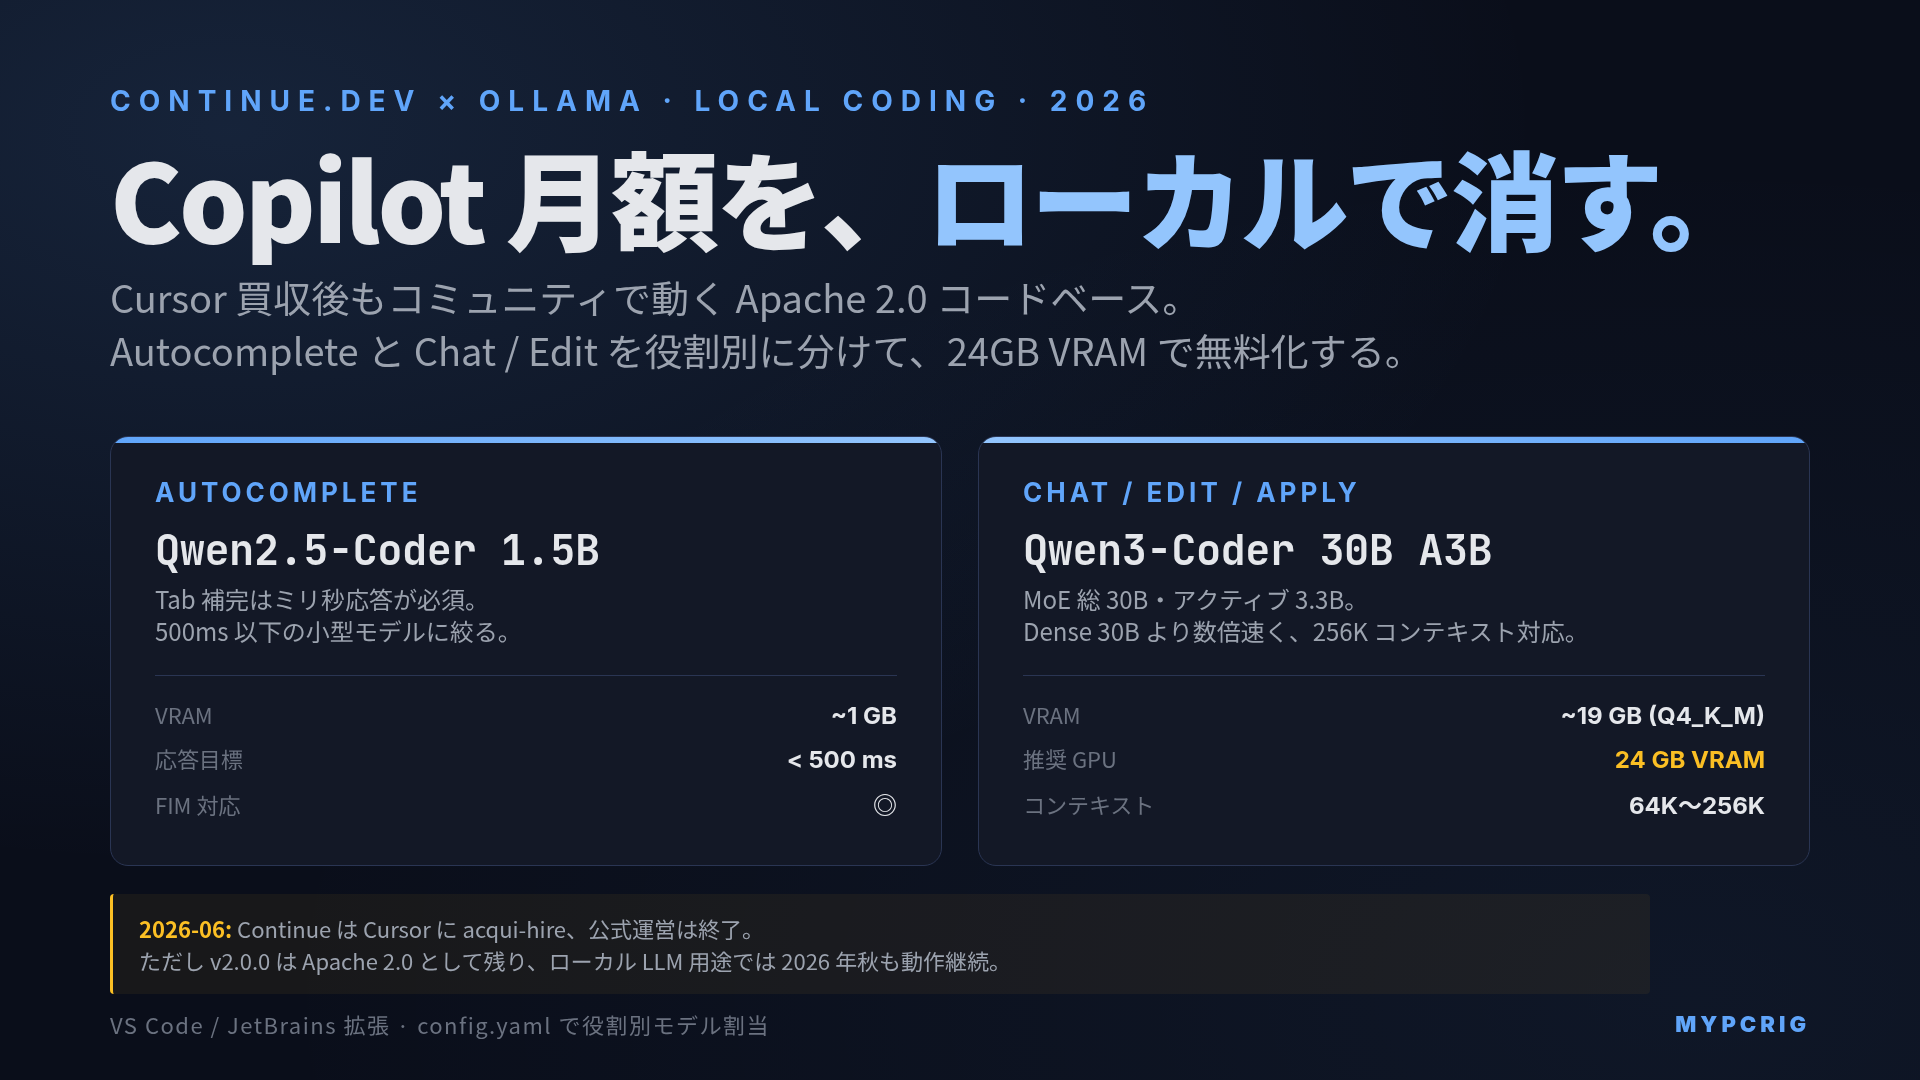
結論:Continue.dev は 2026 年 6 月に Cursor に買収され、公式メンテナンスは終了しました。ただし最終 v2.0.0 リリースが Apache 2.0 でコミュニティ管理として残っており、Ollama + Qwen3-Coder 30B A3B(chat / edit / apply)+ Qwen2.5-Coder 1.5B(autocomplete)の 2 モデル併用で、無料ローカルコード補完環境が引き続き動きます。有料 Copilot($10 / 月)や Claude Code Pro($20 / 月)を節約したい VS Code / JetBrains 派の第一候補として、24GB VRAM のノート / デスクトップなら 1 年で電気代込みで元が取れる TCO 感です。エージェント寄りの用途は Cline を、Tab 補完・チャット・小規模編集寄りの用途は Continue.dev コミュニティ版を選ぶ棲み分けが 2026 年秋時点で妥当です。
「Copilot / Claude Code の月額を節約したい、VS Code のまま無料でローカル AI コード補完を動かしたい」という相談が 2026 年後半に増えました。もっとも自然な選択肢が Continue.dev + Ollama + Qwen3-Coder の組合せでしたが、Continue の開発チームは 2026 年 6 月に Cursor に買収され、公式メンテナンスは終了しています(The New Stack のカバレッジ、daily.dev の要約)。
ただし Continue.dev はコードベースが Apache 2.0 で公開されており、最終 v2.0.0 リリースが VS Code Marketplace と JetBrains Plugins Marketplace に残っています。ローカル LLM 用途では「Cursor 買収前と同じ config.yaml で今も動く」状態です。本記事では、買収後のコミュニティ管理状況を踏まえた上で Continue.dev + Ollama の無料コード補完環境を組む手順を、Cline との使い分け・TCO 比較・代替(Twinny / Tabby)まで含めて解説します。
Continue.dev の 2026 年 9 月時点の状況
まず現状を正しく把握しておきます。
Cursor 買収と v2.0.0 リリース
- 買収発表:2026 年 6 月 18 日、Cursor(Anysphere)が Continue(Continue Dev, Inc.)を acqui-hire。取引条件は非公表
- 公式製品の停止:Continue の standalone 製品は shut down 済み。既存ユーザーのデータエクスポート期限は 2026 年 7 月 15 日
- 最終リリース:v2.0.0(VS Code 拡張 / CLI / JetBrains プラグイン)が最終公式リリース
- コードベース:GitHub の continuedev/continue リポジトリは Apache 2.0 のままアーカイブ状態で残り、read-only。フォーク / コミュニティメンテナンスは可能
つまり 公式マネージド機能は停止したが、ローカル LLM で動かす分にはコードベース・拡張・CLI が今もインストール可能 という状態です。ローカル完結のコード補完に使う場合、買収前と同じ体験がそのまま利用できます。Anthropic や OpenAI の API キーを Continue に紐付ける利用形態も動きますが、Continue Hub(サーバサイド機能)を必要とする一部プレビュー機能は停止した可能性があります。
現時点で Continue.dev を選ぶ理由 / 選ばない理由
選ぶ理由:
- Ollama 対応、VS Code / JetBrains 両対応
- Autocomplete と Chat / Edit / Apply の役割別モデル割当てが
config.yamlで明示的に設定できる - 買収後もコードは Apache 2.0 で残っており、コミュニティフォークによる継続開発の可能性がある
- Cline / Cursor に比べて軽量、Tab 補完 + Chat が中心のシンプルな UX
選ばない理由:
- 公式ロードマップが停止(新機能追加は期待できない)
- 買収前にサーバサイドで動いていた Continue Hub のプレビュー機能は使えない可能性
- 「10 年使うツール」として選ぶには公式運営の継続性リスクがある
- エージェント型(自律ファイル書き換え)が本命なら Cline / Cursor / Claude Code のほうが強い
代替として Twinny(VS Code / JetBrains、Ollama ネイティブ、v1.x で活発更新)、Tabby(自ホスト型サーバー + IDE クライアント、企業向け)、Cline(エージェント寄り)が候補になります。本記事は「Continue.dev のコミュニティ版を今から使う」場合の実務手順を扱いますが、末尾で代替も整理します。
Continue.dev の 3 機能:Autocomplete / Chat / Edit の役割分担
Continue.dev の中核機能は 3 系統に分かれています。それぞれ最適なモデルサイズが違うため、役割別に別モデルを割り当てる のがローカル LLM 運用の勘所です。
| 機能 | 用途 | 応答目標 | 推奨モデルサイズ |
|---|---|---|---|
| Autocomplete | Tab 補完(インライン補完、fill-in-the-middle) | 500ms 以下 | 1.5B〜7B(Qwen2.5-Coder 1.5B / 7B、DeepSeek-Coder 1.3B) |
| Chat | サイドバーで対話、コード提案・説明 | 数秒〜10 秒 | 14B〜32B(Qwen3-Coder 30B A3B、DeepSeek-Coder-V2) |
| Edit / Apply | 選択範囲を書き換え、差分適用 | 数秒〜30 秒 | 14B〜32B(Chat と同じで可) |
| Embed | ワークスペース検索・RAG | バッチ | nomic-embed-text(Ollama library) |
| Rerank | 検索結果の再ランキング | バッチ | bge-reranker-v2-m3(Ollama library) |
Autocomplete は「あなたのタイピングより速く出る」ことが必須なので、応答遅延に非常にシビアです。1.5B〜7B の小型モデルに絞り、fill-in-the-middle(FIM)対応 tokenizer を持つ Qwen2.5-Coder 系や DeepSeek-Coder 系を選びます。Chat / Edit は多少遅くても品質を優先するので、30B クラスの MoE(Qwen3-Coder 30B A3B)や DeepSeek-Coder-V2-Lite 16B(MoE、アクティブ 2.4B)が主力です。
VRAM 別・config.yaml 実例(12GB / 24GB / 48GB)
以下の 3 パターンで、実運用に耐える構成を示します。設定ファイルは Ctrl+Shift+P → Continue: Open Config で ~/.continue/config.yaml を開いて編集します。
VRAM 12GB(RTX 4070 / RTX 3060 12GB / M2 MacBook Air 16GB)
Autocomplete を Qwen2.5-Coder 1.5B、Chat を Qwen2.5-Coder 7B に絞る構成です。
name: local-continue-12gb
version: 1.0.0
schema: v1

models:
  - name: qwen-autocomplete
    provider: ollama
    model: qwen2.5-coder:1.5b-base
    apiBase: http://localhost:11434
    roles:
      - autocomplete
  - name: qwen-chat
    provider: ollama
    model: qwen2.5-coder:7b-instruct
    apiBase: http://localhost:11434
    roles:
      - chat
      - edit
      - apply
  - name: nomic-embed
    provider: ollama
    model: nomic-embed-text
    apiBase: http://localhost:11434
    roles:
      - embed
Qwen2.5-Coder 7B は Q4_K_M で約 4.7GB、Autocomplete の 1.5B は約 1GB、埋め込みモデルは約 300MB。合計 6〜7GB で 12GB VRAM に収まります。コンテキスト(num_ctx)は Chat 側で 32K に設定するのが実用範囲です。
VRAM 24GB(RTX 4090 / RTX 3090 / M4 Pro 24GB)
Chat / Edit を Qwen3-Coder 30B A3B に上げます。この構成が 2026 年秋時点で「ローカル完結・無料・実用速度」の最適点 です。
name: local-continue-24gb
version: 1.0.0
schema: v1

models:
  - name: qwen-autocomplete
    provider: ollama
    model: qwen2.5-coder:1.5b-base
    apiBase: http://localhost:11434
    roles:
      - autocomplete
  - name: qwen3-coder-chat
    provider: ollama
    model: qwen3-coder:30b
    apiBase: http://localhost:11434
    defaultCompletionOptions:
      contextLength: 65536
    roles:
      - chat
      - edit
      - apply
  - name: nomic-embed
    provider: ollama
    model: nomic-embed-text
    apiBase: http://localhost:11434
    roles:
      - embed
Qwen3-Coder 30B A3B は Mixture-of-Experts で総 30B・アクティブ 3.3B の構成です。Q4_K_M で約 19GB、コンテキスト 64K を含めても 24GB VRAM に収まります。アクティブパラメータが 3.3B なので、Dense 30B より生成速度が数倍速く、コード補完の体感が大幅に改善します。ネイティブで 256K コンテキストに対応しているのも強みです。
Qwen3-Coder 30B A3B の性格は ローカルコーディング LLM ベンチマーク比較 2026 年版 で他モデルと並べて評価しています。同帯の DeepSeek-Coder-V2 との比較も参考になります。
VRAM 48GB(RTX 6000 Ada / A6000 / RTX Pro 6000 / M4 Max 48GB)
Chat / Edit を DeepSeek-Coder-V2 系に上げるか、Qwen3-Coder 30B A3B を Q8 で回すかの二択になります。
name: local-continue-48gb
version: 1.0.0
schema: v1

models:
  - name: qwen-autocomplete
    provider: ollama
    model: qwen2.5-coder:7b-base
    apiBase: http://localhost:11434
    roles:
      - autocomplete
  - name: deepseek-coder-v2-chat
    provider: ollama
    model: deepseek-coder-v2:16b-lite-instruct-q8_0
    apiBase: http://localhost:11434
    defaultCompletionOptions:
      contextLength: 131072
    roles:
      - chat
      - edit
      - apply
  - name: nomic-embed
    provider: ollama
    model: nomic-embed-text
    apiBase: http://localhost:11434
    roles:
      - embed
DeepSeek-Coder-V2-Lite 16B は Q8 で約 17GB。Q8 まで上げると精度が Q4_K_M より一段上がります。Autocomplete も 7B に上げて FIM 精度を強化できます。128K コンテキストにも対応します。
Ollama のセットアップ手順(3 分でここまで)
Ollama 本体のインストール後、モデルを事前 pull しておきます。
# Ollama 本体(macOS / Linux)
curl -fsSL https://ollama.com/install.sh | sh

# 24GB VRAM 構成の推奨モデル
ollama pull qwen2.5-coder:1.5b-base
ollama pull qwen3-coder:30b
ollama pull nomic-embed-text

# 動作確認
ollama list
ollama run qwen3-coder:30b "hello"
Ollama はデフォルトで localhost:11434 で待ち受けます。VS Code に Continue.dev 拡張をインストールし、上記 config.yaml を配置すれば動きます。JetBrains 派も同じ設定ファイルが JetBrains Plugins Marketplace の Continue プラグインから使えます。
Ollama vs vLLM:バックエンド選択の判断軸
Continue.dev は OpenAI 互換 API に対応しているため、Ollama 以外に vLLM や TGI(Text Generation Inference)もバックエンドに選べます。
| バックエンド | 強み | 弱み | 向いている用途 |
|---|---|---|---|
| Ollama | セットアップ 3 分、モデル切替えワンコマンド、macOS ネイティブ対応 | 高並列で vLLM に劣る、KV cache 制御が浅い | 個人 1 人利用(本記事の想定) |
| vLLM | 高スループット、PagedAttention、Continuous Batching | Linux 主体、セットアップ手数多め | 複数人開発チーム、共有 GPU サーバー |
| TGI(Hugging Face) | 商用サポート、モデル互換性広い | Docker 前提、モデル起動遅い | 企業内の共有推論サーバー |
個人 1 人が VS Code から Continue.dev で使う想定なら Ollama が最適点です。チームで共有 GPU サーバーに乗せる場合は vLLM が推奨で、Continue.dev 側は provider: openai + apiBase: http://gpu-server:8000/v1 で接続します。
推論サーバーの技術差分は vLLM / SGLang / TensorRT-LLM サービング比較 2026年版 で詳しく整理しています。
Cline / Roo Code との使い分け
「エージェント寄りの Cline」と「補完寄りの Continue.dev」は用途が明確に分かれます。混同すると期待外れになるので、選定軸を整理します。
| 観点 | Cline | Continue.dev |
|---|---|---|
| UX の中心 | サイドバーの対話でファイル生成・複数ファイル書き換え | エディタ内 Tab 補完 + サイドバーで Chat / Edit |
| ファイル書き換え | 自律的に複数ファイルを触る(エージェント) | ユーザーが範囲を選んで Edit / Apply を明示 |
| 得意領域 | 大きい機能追加、リファクタ、テスト生成 | 関数単位の補完、行内の続き、選択範囲の書き換え |
| ローカル LLM 対応 | Ollama ネイティブ、num_ctx チューニング必須 | Ollama ネイティブ、config.yaml で役割分離 |
| VRAM 目安 | 16GB〜、Chat 用大型モデル前提 | 12GB〜、Autocomplete + Chat の 2 モデル |
| 開発状況 | 活発(v3.82 系、2026 年 8 月時点でも更新中) | Cursor 買収で公式停止、コミュニティ運用 |
| ハマりどころ | コンテキストが数ターンで溢れる | Autocomplete の遅延が 500ms を超えると使えない |
| 従量課金依存 | 実質ゼロ(ローカルLLM 使用時) | 実質ゼロ(ローカルLLM 使用時) |
「自律的にファイル群を書き換えてほしい」なら Cline、「エディタで手を動かしながら Tab で補完してほしい・Chat で相談したい」なら Continue.dev、というのが 2026 年秋時点の使い分け方針です。両方入れて使い分ける人も多いです。Cline 側のセットアップ詳細は Cline / Roo Code をローカルLLM (Ollama) で使うセットアップ完全ガイド 2026年版 で、IDE 全体の比較は AI コーディング IDE 徹底比較 2026年版 で扱っています。
有料 Copilot / Claude Code Pro との TCO 比較
「ローカル LLM を回す電気代 + PC 減価償却」と「Copilot / Claude Code Pro の月額」を並べて、1 年運用で元が取れるかを見ます。
| プラン | 月額(税込目安) | 年額 | 補足 |
|---|---|---|---|
| GitHub Copilot Individual | 約 1,500 円 | 約 18,000 円 | Tab 補完 + Chat |
| GitHub Copilot Pro+ | 約 6,000 円 | 約 72,000 円 | 上位機能 |
| Cursor Pro | 約 3,000 円 | 約 36,000 円 | Cursor IDE 前提 |
| Claude Code Pro | 約 3,000 円 | 約 36,000 円 | Anthropic Claude モデル |
| Continue.dev + Ollama(ローカル) | 0 円 | 0 円(電気代別) | 24GB VRAM PC が別途必要 |
24GB VRAM PC を新規で組む場合の初期費用は、RTX 4090 系中古で 15 万円前後、RTX 5090 32GB 新品構成で 35 万円前後、M4 Pro 24GB Mac mini で 25 万円前後です。GitHub Copilot Pro+ 相当なら 3〜4 年で元が取れ、開発マシンを兼ねるなら実質すぐ回収 できます。1 日 8 時間フル稼働で電気代は月 1,500〜2,500 円前後(GPU 電力 200W 想定、東京電力 30 円 / kWh 換算)。
コード補完用途以外にローカル LLM 用途を持てば TCO 上さらに有利になります。用途別の使い分けは Copilot+ vs ローカルLLM 用途別使い分けガイド 2026年版 や クラウド API vs ローカル LLM TCO 比較 2026年版 を参照してください。
Cursor 買収後の代替選択肢:Twinny / Tabby
Continue.dev の公式継続性リスクを踏まえて、代替となる OSS プロジェクトを 2 つ紹介します。
Twinny
- VS Code 向けの Tab 補完 + Chat 拡張(JetBrains 版は無い)
- Ollama ネイティブ、config は拡張機能側の UI で完結
- v3.x 系で活発に更新されている
- 「Continue.dev の後継として個人利用で選ぶ」場合の第一候補(VS Code 派に限る)
Tabby
- 自ホスト型サーバー + IDE クライアントの構成
- 企業内チーム利用向け、複数開発者が 1 台の GPU サーバーを共有する用途
- コード補完 + Chat + RAG(ワークスペース検索)を統合
- モデルは Qwen2.5-Coder / DeepSeek-Coder / StarCoder2 などに対応
個人利用で Continue.dev の代わりを探すなら Twinny、チーム開発で共有 GPU サーバー方式に寄せるなら Tabby、というのが代替の指針です。Continue.dev コミュニティ版で当面問題がなければ本記事の構成を使い続け、公式継続性が気になり始めたら Twinny への移行を検討する形が現実的です。
トラブルシューティング:よくある詰まりどころ
Autocomplete が動かない / 遅い
Autocomplete モデルが 500ms を超えると Continue.dev が補完を出す前にユーザーが次のキーを打ってしまい、体感で「効いていない」状態になります。Qwen2.5-Coder 7B 以上を Autocomplete に割り当てている場合は 1.5B に落とすと解決します。CPU 推論しかできない環境では Autocomplete を諦めて Chat のみ運用する判断もあります。
Chat のレスポンスが黙って止まる
contextLength を大きくしすぎて VRAM から溢れているケースが多いです。Ollama のログで KV cache が溢れているか、モデルの応答が途中で切れているかを確認します。24GB VRAM で Qwen3-Coder 30B A3B なら contextLength: 65536 が実用上限、それより広げると生成が不安定になります。
Continue.dev の設定 UI が真っ白
Cursor 買収後、Continue Hub のサーバサイド機能に依存するプレビュー画面が真っ白になる場合があります。設定は config.yaml を直接編集すれば動くので、UI は諦めてテキストエディタで設定する形で回避できます。
モデル選択が UI に反映されない
VS Code の Continue.dev 拡張は config.yaml を保存すると自動再読込しますが、稀に反映されない場合があります。VS Code コマンドパレットで Continue: Reload Window を実行すると確実に読み直します。
まとめ:Continue.dev × Ollama は 2026 年秋も現役
- Continue.dev は Cursor 買収で公式停止したが、Apache 2.0 コードベースは残る。v2.0.0 拡張はローカル LLM 用途で今も動作
- VRAM 24GB + Qwen3-Coder 30B A3B(chat / edit)+ Qwen2.5-Coder 1.5B(autocomplete) の 2 モデル併用が 2026 年秋の最適点
- 役割別モデル割当て(
config.yamlのroles:配列)が Continue.dev の設計の核。Autocomplete は 500ms 以下、Chat / Edit は品質優先で分ける - Cline はエージェント寄り、Continue.dev は Tab 補完 + Chat 寄り、で棲み分け
- 有料 Copilot / Cursor / Claude Code Pro の年 3〜7 万円 を節約でき、24GB VRAM PC の初期費用は 3〜4 年で回収圏内
- 公式継続性リスクが気になり始めたら Twinny(個人)、Tabby(チーム)が代替候補
Continue.dev の公式運営は終わりましたが、コード補完 + ローカル LLM の組合せとしては 2026 年秋時点でも競争力のある選択肢です。Cursor が Continue の哲学(オープンソース、ローカル LLM ネイティブ)をどこまで受け継ぐかは不透明ですが、少なくとも既存の Continue.dev v2.0.0 は「今も普通に動く無料のコード補完ツール」として当面使い続けられます。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
Continue.dev + Ollama を実用速度で回すには、24GB 以上の VRAM を持つ dGPU または統合メモリ 24GB 以上の Apple Silicon Mac が必要です。本記事で扱った VRAM 構成に沿って主要選択肢の探索リンクを置きます。
24GB VRAM 帯 dGPU(Continue.dev の最適点)
- GeForce RTX 4090 を Amazon.co.jp で見る
- GeForce RTX 3090 を Amazon.co.jp で見る
- GeForce RTX 5090 を Amazon.co.jp で見る(32GB VRAM、24GB 帯より一段上)
Apple Silicon Mac(統合メモリ 24GB 以上)
- Mac mini M4 Pro を Apple.com で見る(Amazon.co.jp は上位構成の新品流通が限定的なため公式リンク。こちらからは紹介料が発生しません)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- Cline / Roo Code をローカルLLM (Ollama) で使うセットアップ完全ガイド 2026年版 — エージェント寄りの隣接記事
- AI コーディング IDE 徹底比較 2026年版 — IDE 選定の上流記事
- ローカルコーディング LLM ベンチマーク比較 2026 年版 — モデル選定の裏付け
- ローカルLLM MCP サーバー完全構築ガイド 2026年版 — MCP 統合で外部ツール接続