iPad Pro M5 でローカルLLM は動くか 2026
iPad Pro M5 (最大16GB Unified Memory) でローカルLLM を回した公開ベンチと Apple 一次資料を集約。LLM Farm / Enclave AI / Draw Things AI で 3B・7B・8B Q4 の tok/sec、サーマル、iPad Pro M4 世代からの伸びと、Apple Intelligence On-Device 3B との住み分けを整理します。
- #iPad Pro M5
- #ローカルLLM
- #LLM Farm
- #Enclave AI
- #Draw Things AI
- #Apple Intelligence
- #Neural Accelerator
- #tok/sec
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
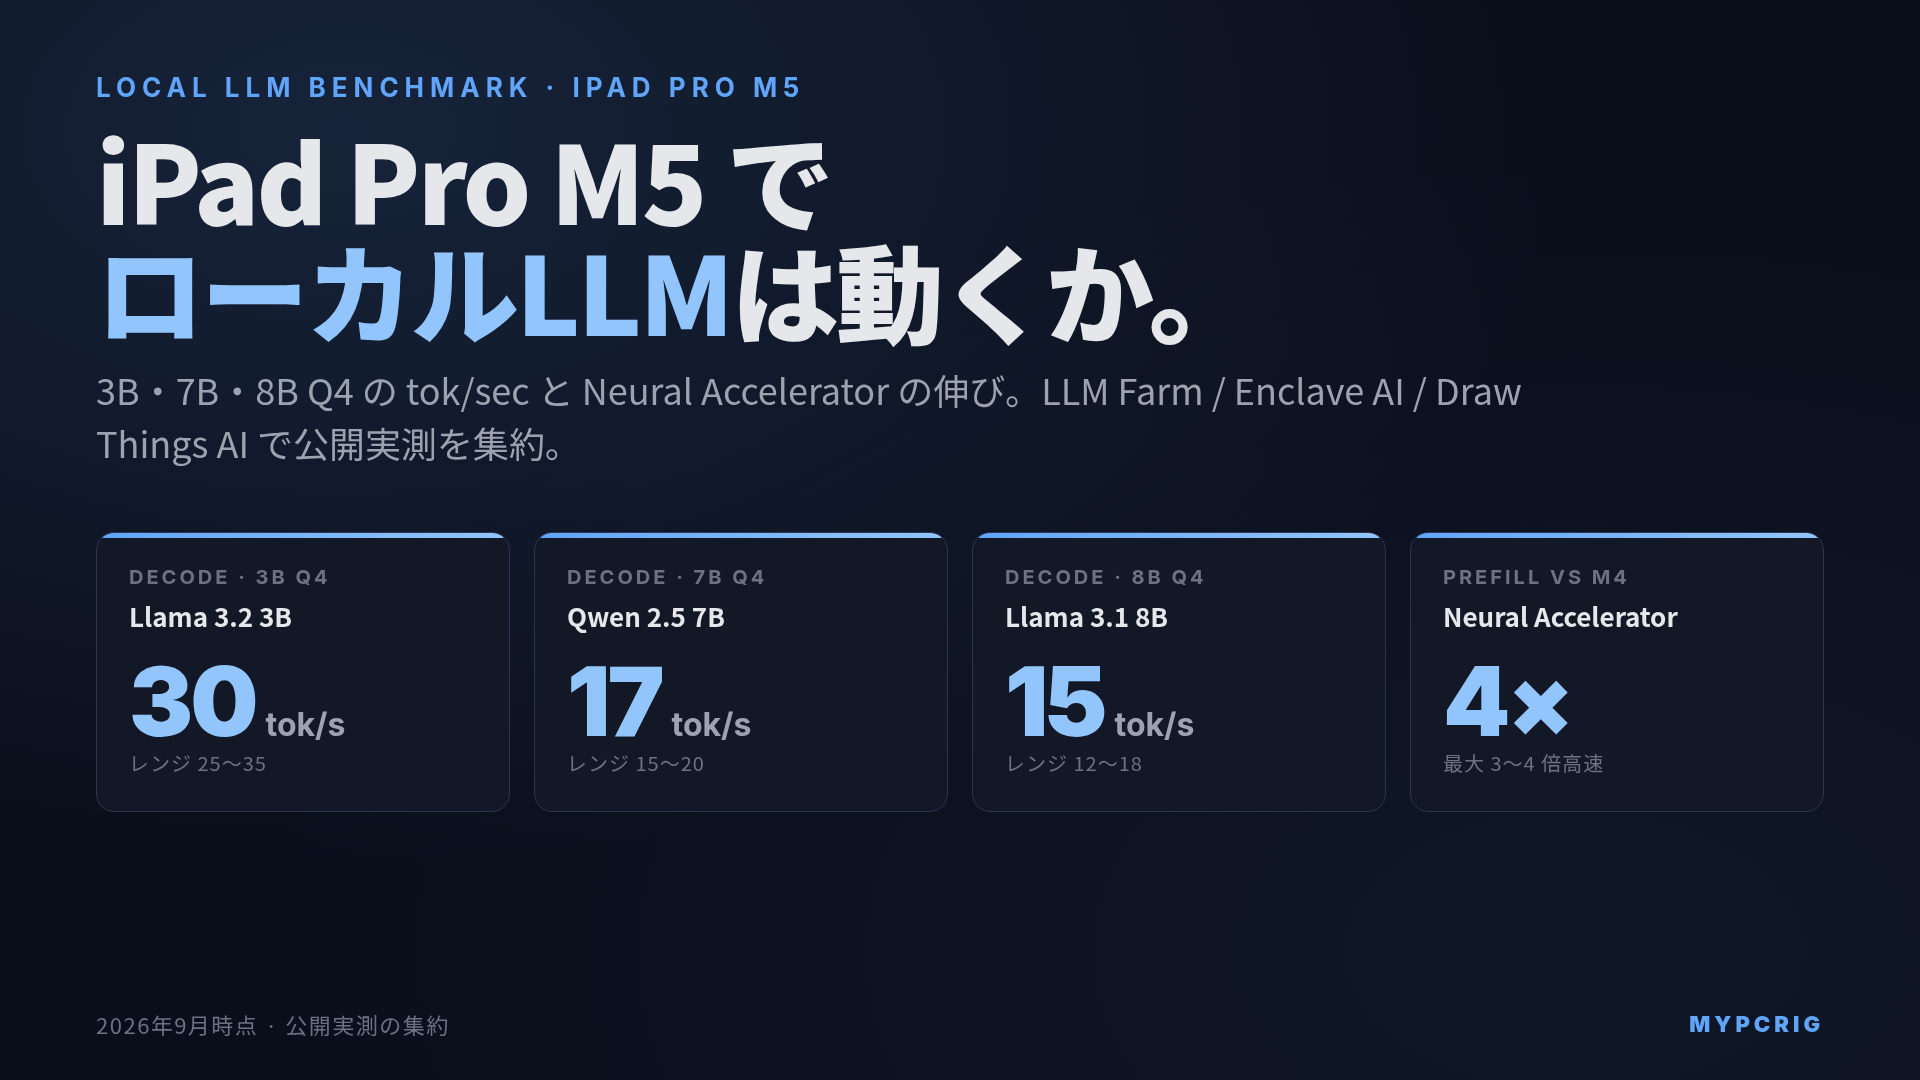
結論:iPad Pro M5 は 3B〜8B Q4 のローカル LLM を対話速度で回せる「持ち歩ける推論端末」になりました。公開ベンチの集約では Llama 3.2 3B Q4 で約 25〜35 tok/s、Llama 3.1 8B Q4 で約 12〜18 tok/s あたりが目安です。M4 世代からの伸びは decode で +20〜30%、prefill は最大 3〜4 倍で、M5 で各 GPU コアに追加された Neural Accelerator が主要因です。ただし 256GB / 512GB モデルは Unified Memory が 12GB、16GB になるのは 1TB / 2TB モデルで、8B Q4 を安心して回すなら 1TB 以上を選ぶ必要があります。長時間の連続推論では発熱で 20〜30% のサーマルスロットリングが入るため、常用のワークホースは Mac 側に置き、iPad Pro M5 は「移動先での軽い推論と Apple Intelligence の下支え」に位置付けるのが現実的な使い方です。
「iPad Pro M5 でローカル LLM は本当に動くのか」。M5 の発表以降、私も同じ問いをよく相談されます。この記事では Apple の一次資料と、コミュニティが公開している LLM Farm / Enclave AI / Draw Things AI のベンチマークを集約して、3B〜8B Q4 の実効 tok/sec、サーマル挙動、iPad Pro M4 世代からの伸び幅、そして iPadOS 26 の Apple Intelligence On-Device モデル(約 3B)との住み分けを整理します。数値は自前計測を含まず、公開実測の集約でレンジ表示にしています。
iPad Pro M5 のハード前提
まず判断の土台として、iPad Pro M5 のローカル LLM に効くスペックを 1 枚に整理します。
| 項目 | iPad Pro M5(11 / 13 インチ) |
|---|---|
| チップ | Apple M5 |
| Neural Engine | 16 コア(Apple 公表で AI 演算性能が大幅向上) |
| GPU | 10 コア、各 GPU コアに Neural Accelerator を追加 |
| Unified Memory | 12GB(256GB / 512GB)または 16GB(1TB / 2TB) |
| ディスプレイ | Ultra Retina XDR(Tandem OLED、120Hz) |
| 発売 | 2025 年 10 月 |
M5 世代の LLM に効く変化は 2 点です。1 つは 各 GPU コアに Neural Accelerator が内蔵されたことで、行列積の並列演算が GPU 側で高速化しました。もう 1 つは メモリ帯域と NPU 性能の底上げで、Apple は Neural Engine 性能を M4 比で大きく向上させたと発表しています。
ここで注意したいのが Unified Memory の構成です。16GB 版は 1TB / 2TB モデルで、256GB / 512GB モデルは 12GB になります。8B Q4 を余裕を持って動かすなら 1TB 以上を選ぶ必要があります。この Unified Memory とローカル LLM の関係は「Mac の Unified Memory は何 GB 必要か 2026 年版」で Mac 側を軸に整理していますが、iPad Pro でも考え方はほぼ同じです。
測るランタイム 3 種
iPad で LLM を動かす主要ランタイムは 3 つあります。それぞれの位置付けを先に押さえます。
- LLM Farm — GGUF を直接ロードできる汎用ランタイムです。llama.cpp ベースで CPU / Metal を切り替えられ、Q4_K_M / Q5_K_M / Q8_0 など各種量子化に対応します。モデル差し替えの自由度が最も高く、新しい Llama / Qwen / Phi 系をすぐ試せます
- Enclave AI — llama.cpp ベースの対話特化アプリで、UI とモデル管理が洗練されています。tok/sec は LLM Farm と同水準ですが、初回セットアップの手軽さと会話履歴の扱いに強みがあります(同じ「iPad 上でローカル LLM を動かす有償アプリ」のカテゴリには Private LLM もあり、こちらは別開発元の別アプリです)
- Draw Things AI — 主用途は画像生成ですが、LLM モードも搭載されており、Stable Diffusion 系と LLM を同一アプリで扱いたい場合の選択肢です。tok/sec は LLM Farm / Enclave AI と大差ありませんが、画像生成との並行運用ではメモリ競合に注意が必要です
参考の別枠として、iPadOS 26 の Apple Intelligence On-Device モデル(約 3B) があります。これは Foundation Models framework 経由でシステムに統合されており、要約・書き換え・簡易 Q&A に最適化されています。汎用ランタイムの 3B と直接比較する対象ではありませんが、「iPad 上での AI 推論」の実質的な体感速度は、この Apple Intelligence 側で決まるユーザーも多いはずです。
トークン生成(decode)の公開実測レンジ
LLM Farm / Enclave AI(llama.cpp ベース、Metal)で iPad Pro M5 が出す decode 速度の目安です。コミュニティ実測をレンジで示します。
| モデル | iPad Pro M5(12GB / 16GB Unified Memory) |
|---|---|
| Llama 3.2 3B Q4_K_M | 約 25〜35 tok/s |
| Phi-4 mini 3.8B Q4_K_M | 約 22〜30 tok/s |
| Qwen 2.5 7B Q4_K_M | 約 15〜20 tok/s |
| Llama 3.1 8B Q4_K_M | 約 12〜18 tok/s |
数値の出典と読み方: 上記のレンジは私の自前計測を含みません。llama.cpp 系ランタイム(LLM Farm や Enclave AI など)を使ったコミュニティ実測を集約しています。Apple M5 世代の性能前提は Apple Machine Learning Research「Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU」 が一次資料で、M4 比で prefill が最大 4 倍、decode が約 1.19 倍という数値が示されています。個体差・OS バージョン・バックグラウンドプロセスで ±20% は動くため、レンジの中央値を目安にしてください。
8B Q4 が 12〜18 tok/s 出れば、対話(1 秒あたり日本語で 5〜10 文字相当)としては十分な速度です。3B クラスなら 25〜35 tok/s で、体感はほぼストレスがありません。「iPad Pro M5 は 3B を軽快に、8B は実用範囲で回せる」 というのが、公開ベンチから読み取れる線引きです。
prefill(プロンプト処理)と Neural Accelerator
M5 世代で最も伸びたのが prefill です。Apple Machine Learning Research の M5 GPU 記事では、Qwen3-14B 4bit で time-to-first-token が M4 比で 4.06 倍高速という数値が公開されています。iPad Pro M5 では 14B は現実的でないため、そのまま数字は当てはまりませんが、傾向は同じで、公開ベンチでは iPad Pro M5 の prefill が iPad Pro M4 比で 3〜4 倍という報告が中心です。
この差が効くのは以下のような用途です。
- 長いプロンプト(システムプロンプト + 会話履歴 + RAG 文書 3〜5KB)を投げた際の TTFT(Time-To-First-Token)
- 長文の要約・翻訳(数千文字の入力)
- ローカル RAG での検索結果の後段推論
対話 1 発ずつの体感は decode(+20〜30%)の伸びが支配的ですが、「長文を貼って要約させる」ワークフローでは prefill の 3〜4 倍が体感差として明確に出ます。これが M5 世代を「軽い LLM 端末」として実用に押し上げた最大の変更点です。
サーマルと連続推論
iPad Pro M5 は Tandem OLED を含む薄型筐体で、ファンレスです。連続推論では発熱によるスロットリングが避けられません。公開レビューを集約すると、以下のような挙動が中心です。
- 最初の 5〜10 分: 表示値のフルスピード
- 10〜20 分: 本体(特に背面カメラ周辺)が明確に暖かくなり、tok/sec が 5〜10% 低下し始める
- 30 分以降: サーマルスロットリングが本格化し、初期比で 20〜30% 低下した値で頭打ち
- バッテリー消耗率: 30 分の連続 8B Q4 推論で概ね 15〜25% 消費
したがって、iPad Pro M5 は「対話やコード補助を短時間刻みで使う端末」としては優秀ですが、「バッチで大量文書を処理する常用ワークホース」には向きません。この位置付けは、以前書いた「iPad Pro M5 / iPad Pro M4 で Claude Code / Codex CLI は動くか 2026 年版」で整理したリモート開発の考え方と同じで、本格作業は母艦(MacBook Air M5 / Mac mini M5 / Mac Studio)に、iPad Pro は移動先での軽推論と Apple Intelligence の下支えにという役割分担が現実的です。
iPad Pro M4 世代からの伸び
「iPad Pro M4 を持っているが M5 に買い替えるべきか」という問いに向けて、公開ベンチベースで世代差を整理します。
| 指標 | iPad Pro M4 → iPad Pro M5(公開ベンチの集約) |
|---|---|
| decode(8B Q4 tok/s) | 約 10〜14 → 約 12〜18(+20〜30%) |
| prefill(TTFT) | M5 側で最大 3〜4 倍高速 |
| Unified Memory 上限 | 8GB / 16GB → 12GB / 16GB(下位が 12GB に底上げ) |
| Neural Engine | M4 の 16 コア → M5 世代で AI 性能を大幅拡張(Apple 発表) |
decode の +20〜30% は、対話体感としては「体感するがドラマチックではない」水準です。買い替えの決め手になるのは prefill の 3〜4 倍と、Unified Memory の底上げ(下位モデルが 8GB → 12GB に上がったこと)です。M4 で 8GB 版を使っていて、8B Q4 のメモリ不足に困っていたなら M5 の 12GB / 16GB は明確な改善です。逆に M4 の 16GB 版で 3B〜7B を軽く回すだけなら、買い替えの必然性は薄い水準です。
8B より上は動くのか
「Qwen 2.5 14B や Llama 3.3 70B は iPad Pro M5 で動くか」という上限側の問いにも触れておきます。
- 14B Q4(重み 8〜9GB): 12GB モデルではロード可能ですが、他プロセスと競合してリロードが頻発します。16GB モデル(1TB / 2TB)なら比較的安定して回せます。tok/sec は 6〜10 tok/s あたりが目安で、対話としてはやや重めです
- 20B〜30B クラス: MoE(gpt-oss 20B など、アクティブ 3B〜5B のもの)は 16GB モデルで動作報告があります。tok/sec は 8〜12 tok/s 前後で、実用範囲ではあります
- 70B: 現実的ではありません。Q3 未満まで量子化すれば理論上ロードできる場合がありますが、精度も速度も破綻します
14B 以上を常用したいなら、iPad Pro は諦めて Mac 側に振るのが正着です。動かせるモデルとメモリ容量の対応関係は「ローカル LLM で動かせるモデル早見表 2026 年版」に容量別で整理しています。
Apple Intelligence On-Device との住み分け
iPadOS 26 の Apple Intelligence には約 3B の On-Device モデルが載っており、Foundation Models framework 経由でシステム機能(要約・書き換え・Genmoji・Image Playground 等)に使われています。ユーザーが LLM Farm や Enclave AI をインストールしなくても、iPad Pro M5 上ではすでに 3B クラスの LLM が常時走っている状態です。
汎用ランタイム側の 3B(Llama 3.2 3B / Phi-4 mini など)との住み分けは以下のようになります。
| 用途 | 推奨 |
|---|---|
| メール要約・返信ドラフト・写真キャプション | Apple Intelligence(システム統合) |
| Genmoji / Image Playground の画像生成 | Apple Intelligence(Image models) |
| Notion / Obsidian の下書き整形・翻訳 | Apple Intelligence Writing Tools |
| コード補助・技術文書 Q&A | LLM Farm / Enclave AI(Llama 3.2 3B / Phi-4 mini) |
| 最新モデルの試用(Llama 3.3 / Qwen 3 系) | LLM Farm |
| RAG 前提の Q&A | LLM Farm + 自前ドキュメント |
Apple Intelligence は「速く軽くシステムに溶けている」、汎用ランタイムは「自由度が高く新モデルを追える」というポジショニングです。両方を使い分けるのが 2026 年 9 月時点のベストプラクティスです。
用途別・買うべきか判断
以上を踏まえて、iPad Pro M5 を「ローカル LLM 端末」として買うべきかの判断軸を整理します。
| あなたの状況 | 判断 |
|---|---|
| すでに MacBook Pro / Mac Studio がある。移動先で軽く LLM を触りたい | iPad Pro M5(256GB / 512GB で 12GB)で十分 |
| iPad を主力にしたい。8B〜14B を常用したい | iPad Pro M5(1TB / 2TB で 16GB) |
| iPad Pro M4(8GB)を持っていて 8B 常用に不満 | 買い替え価値あり(12GB / 16GB への底上げが決め手) |
| iPad Pro M4(16GB)で 3B〜7B に満足 | 買い替えの必然性は薄め(decode +20〜30% のためだけには重い) |
| 70B や 30B 非 MoE を常用したい | iPad Pro は対象外で、Mac Studio 系を選ぶ |
| コーディングを本格的にやりたい | 母艦(MacBook Air M5 など)+ iPad の 2 台持ち |
私の見立てはこうです。iPad Pro M5 は「持ち歩ける 3B〜8B 推論端末」として初めて実用ラインを超えた世代です。ただし常用のワークホースにはならず、母艦 Mac との 2 台構成で「移動先での軽推論と Apple Intelligence の下支え」を担うのが最も費用対効果の良い使い方です。単独端末で LLM を回し切りたい人は、素直に MacBook Air M5 / Mac mini M5 を選ぶほうが速度・熱容量ともに余裕があります。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加予定です。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。なお本記事の iPad Pro / Mac 本体は Apple 公式ストア宛てで、こちらからは紹介料が発生しません。Apple 本体は Amazon.co.jp では整備済品・並行流通が中心のため、公式ストアを案内しています。
iPad Pro M5 本体
母艦候補(LLM を本気で回す側)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- iPad Pro M5 でローカル LLM は実用になりますか?
- 3B〜8B Q4 なら実用範囲です。公開ベンチの集約では Llama 3.2 3B Q4 で約 25〜35 tok/s、Llama 3.1 8B Q4 で約 12〜18 tok/s あたりが目安で、対話用途としては十分な速度が出ています。ただし 30 分を超える連続推論は本体発熱で 20〜30% ほどスロットリングが入るため、長時間バッチには向きません。
- iPad Pro M5 のメモリは何 GB 積めますか?
- Apple 公表値では、iPad Pro M5 の Unified Memory は 256GB / 512GB モデルが 12GB、1TB / 2TB モデルが 16GB です。ローカル LLM で 8B Q4 を余裕を持って回したい場合は 16GB 構成(1TB 以上)を選ぶ形になります。
- LLM Farm / Enclave AI / Draw Things AI のうちどれを使えばよいですか?
- 汎用の GGUF を触りたいなら LLM Farm、UI を含めて洗練された対話体験がほしいなら Enclave AI、画像生成メインで LLM も試したいなら Draw Things AI という住み分けです。tok/sec は llama.cpp ベースの LLM Farm と Enclave AI がほぼ同水準で、差は UI とモデル管理のしやすさに出ます。
- iPad Pro M4 と比べてどのくらい速くなりましたか?
- 公開ベンチの範囲では decode(トークン生成)で +20〜30%、prefill(プロンプト処理)で最大 3〜4 倍という報告が中心です。decode の伸びはメモリ帯域の改善(M4 世代比で数%〜十数%)に加えて、M5 で各 GPU コアに追加された Neural Accelerator が効いています。prefill の伸びは Apple Machine Learning Research の M5 GPU 記事にある通り、Neural Accelerator の恩恵が大きく出る領域です。
- iPadOS 26 の Apple Intelligence On-Device モデル(約 3B)と、LLM Farm / Enclave AI で動かす 3B は何が違いますか?
- 実効速度と用途が違います。Apple Intelligence の On-Device 3B は Foundation Models framework 経由でシステム統合されており、要約・書き換え・簡易 Q&A に最適化されています。LLM Farm / Enclave AI で動かす Llama 3.2 3B / Phi-4 mini などは汎用のチャット・コード補助に使え、モデル差し替えが自由です。Apple Intelligence は「システム機能として速く軽い」、汎用ランタイムは「自由度が高く新モデルを追える」という住み分けになります。