LLM Prefill / Decode の違い 2026年版
prefill と decode は LLM 推論の 2 フェーズ。prefill は入力プロンプト全体を読んで最初のトークンを出す compute 律速の処理で、TTFT を決めます。decode は 1 トークンずつ生成する帯域律速の処理で、tok/sec を決めます。長文・エージェント用途で効くのはどちらかを、Mac と NVIDIA GPU の非対称性から解説します。
- #prefill
- #decode
- #TTFT
- #ローカルLLM
- #推論フェーズ
- #Apple Silicon
- #NVIDIA GPU
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
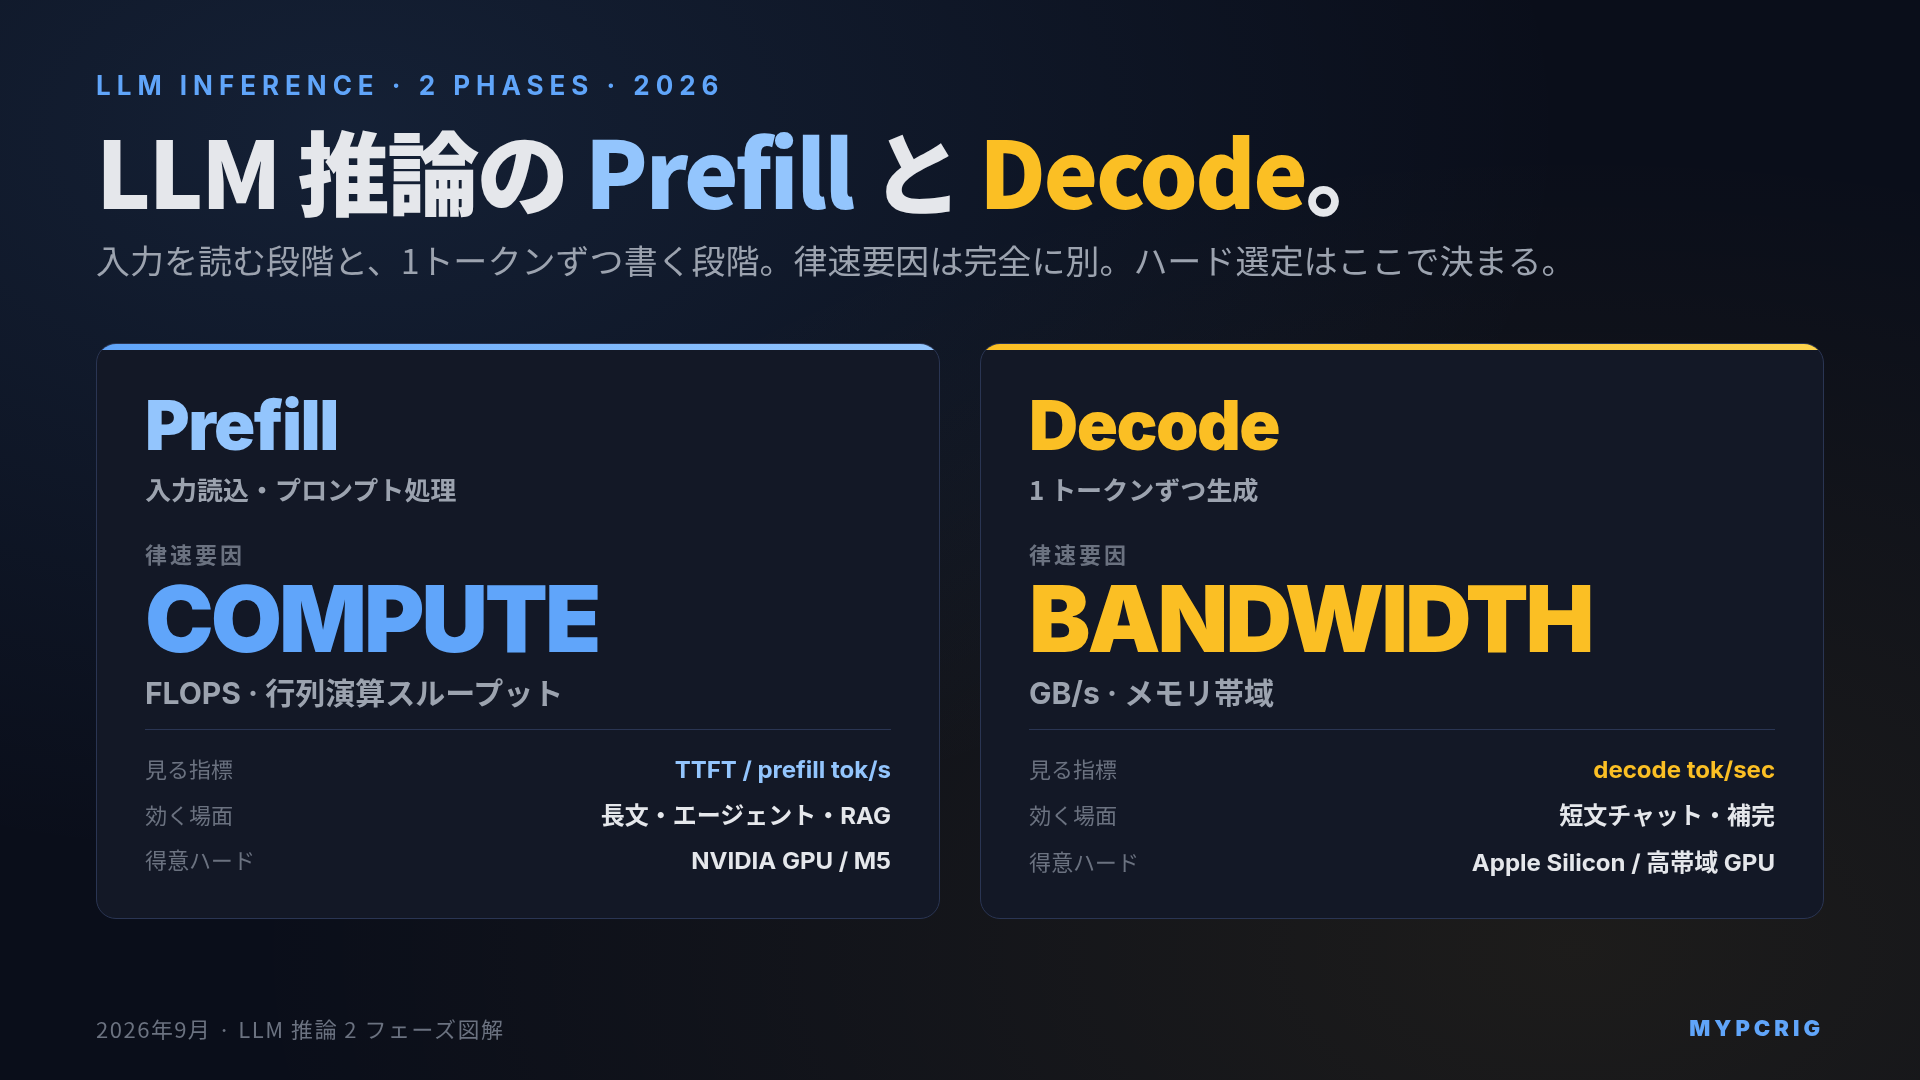
結論:LLM 推論は「prefill(入力を読む)」と「decode(1 トークンずつ生成する)」の 2 フェーズに分かれます。prefill は compute(FLOPS)律速で TTFT を決め、decode はメモリ帯域律速で tok/sec を決めます。CUDA コアを大量に積む NVIDIA GPU は prefill が速く、unified memory 帯域の高い Apple Silicon は decode で健闘する、という非対称性はこの律速の違いから来ています。短文チャットなら decode だけ見れば十分ですが、エージェント・RAG・長文要約のように入力が数万トークンに膨らむ用途では、prefill が体感時間の 8 割を占めます。tok/sec だけでハードを選ぶと長文用途で見誤ります。
ローカル LLM のベンチマークを追っていると、同じマシンでも「短文チャットは速いのに、エージェントを走らせると急に遅くなる」「Mac は decode の tok/sec が速いのに、長文を投げると待たされる」といった非対称な挙動に必ずぶつかります。原因は LLM 推論が 性質の異なる 2 つのフェーズの連続 だからです。フェーズごとに律速要因が違い、得意なハードも変わります。
本記事では、prefill と decode がそれぞれ何をしていて、なぜ律速要因が違うのか、その違いがハード選定にどう跳ね返るのかを、概念解説として整理します。GPU 別の実測値そのものは「ローカルLLM prefill(プロンプト処理)速度 GPU別ベンチマーク 2026年版」に集約しているので、数値を追いたい方はそちらへどうぞ。
2 フェーズを一枚に整理する
まず全体像を 2×2 の表で押さえます。以降の章はすべてこの表の各セルを掘り下げる形で進みます。
| 観点 | prefill(プロンプト処理) | decode(生成) |
|---|---|---|
| 何をしているか | 入力プロンプト全体を並列に読み込み、KV キャッシュを構築、最初のトークンを出す | 1 トークンずつ逐次生成し、モデル全重みを毎回読み出す |
| 律速要因 | compute(FLOPS)・行列演算スループット | メモリ帯域(GB/s) |
| 決める指標 | prefill tok/s、TTFT(Time To First Token, 秒) | decode tok/sec |
| 体感で効く場面 | 長文入力・エージェント・RAG・要約 | 短文チャット・コード補完 |
| 得意なハード | CUDA コア多い NVIDIA GPU、専用行列演算ユニット搭載機 | 帯域高い GPU、Apple Silicon(unified memory) |
| 弱点のハード | Apple Silicon(M4 以前)、低 TDP モジュール、CPU 推論 | 低帯域 GPU、DDR4 CPU 推論、VRAM 溢れで PCIe オフロード発生時 |
3 行だけ覚えて帰るなら、「入力が長ければ prefill が支配、入力が短ければ decode が支配」「prefill は演算量、decode は帯域」「エージェント・RAG なら prefill、チャットだけなら decode」 の 3 点です。
prefill:入力を並列に読む compute 律速の処理
prefill は、LLM に投入された入力プロンプト(システムプロンプト + ユーザーメッセージ + 履歴 + ツール出力 + RAG チャンクなど全部)を 並列に一気に処理して 最初のトークンを出すまでの段階です。ここで KV キャッシュが構築されます。
並列処理なので、演算器(CUDA コア、GPU のシェーダユニット、専用行列演算ユニット)をフルに使い切ります。つまり compute(FLOPS)律速 です。入力トークン数を N とすると、prefill にかかる時間は概ね N に線形(実際には Attention の計算コストがあるため若干の余剰)で伸びます。
見るべき指標は 2 つです。
- prefill tok/s:1 秒あたり何トークンの入力を消化できるか。数千〜1 万 tok/s のオーダー
- TTFT(Time To First Token):入力を送ってから最初のトークンが返るまでの秒数。ローカル実行では TTFT ≒ prefill 時間
短文チャット(〜2K トークン)では prefill は一瞬で終わるため、TTFT はほぼゼロと見なせます。ところが入力が 8K・32K・128K と伸びると、prefill 時間が一気に体感を支配します。RTX 5090 で 8B モデルを 32K トークン入力に対して走らせたとき TTFT が数秒、Strix Halo(Ryzen AI MAX+ 395)で数十秒、Mac Studio M4 Max でその中間、という差が出るのはこのフェーズです。
decode:1 トークンずつ書き出す帯域律速の処理
prefill で最初のトークンが出た後は、以降のトークンを 1 つずつ生成する decode フェーズ に入ります。ここは並列化ができません。生成した 1 トークンを次のステップの入力に足して、また 1 トークン生成、という逐次処理です。
このとき何が起きているかというと、1 トークン生成するたびに モデルの全重みをメモリから読み出す 必要があります。8B Q4 モデル(実ファイル約 5GB)なら 1 トークンごとに 5GB 分の読み出しが発生し、これが 1 秒に何回できるかがそのまま tok/sec の上限を決めます。
つまり decode は メモリ帯域律速 です。CUDA コア数や演算スループットはほとんど関係ありません。極端な例では、演算器を積んでいなくても帯域さえ広ければ decode は速く、逆に演算器が潤沢でも帯域が細いと decode は詰まります。詳しい仕組みと帯域別の tok/sec 一覧は「メモリ帯域幅(GB/s)がローカルLLMの tok/sec を決める仕組み 2026年版」で扱っています。
なぜ NVIDIA と Apple の得意フェーズが逆になるのか
prefill と decode の律速要因が違うことは、ハード選定に直接跳ね返ります。代表的な機材の帯域と compute を並べてみます。
| GPU / SoC | メモリ帯域 | 演算スループット(傾向) | 得意フェーズ |
|---|---|---|---|
| RTX 5090(32GB GDDR7) | 1,792 GB/s | 極めて高い(CUDA コア 21,760) | prefill・decode ともに強い |
| RTX 4090(24GB GDDR6X) | 1,008 GB/s | 高い(CUDA コア 16,384) | prefill・decode ともに強い |
| Mac Studio M3 Ultra | 819 GB/s | 中程度(GPU コア 80、行列演算ユニット無し) | decode 側で健闘、prefill は相対弱 |
| MacBook Pro M4 Max(40 コア GPU) | 546 GB/s | 中程度(M4 世代、行列演算ユニット無し) | decode で健闘、長文 prefill で失速 |
| Ryzen AI MAX+ 395(Strix Halo) | 256 GB/s | 中程度(Radeon 8060S、40 CU) | 大容量が主戦場、prefill は弱め |
| CPU 推論(DDR5-6000 2ch) | 実効 約 90 GB/s | AVX-512 の有無で分岐 | どちらも厳しい、長文 prefill は非現実的 |
RTX 5090 が prefill 優位 の理由は、CUDA コアを大量に積むことで並列行列演算のスループットが桁違いに高いからです。8K・32K の入力を並列にぶん回せるので、TTFT が短くなります。
Apple Silicon が decode で健闘 する理由は、unified memory の帯域が広い(M3 Ultra で 819 GB/s、M4 Max で 546 GB/s)ためです。decode は帯域律速なので、この帯域がそのまま生かせます。ただし M4 世代までは GPU コアに専用の行列演算ユニット(Tensor Core 相当)が無く、prefill の compute スループットでは NVIDIA に大きく差をつけられます。8K を超える入力で急に遅くなる Mac の挙動はこの構造から来ています。
Strix Halo は帯域 256 GB/s で、大容量(96GB VRAM 割当)で 70B・120B クラスを単体ロードできる独自性がある一方、compute も帯域も RTX 5090 に対して大きく下です。長文 prefill での失速は Strix Halo でも顕著で、詳しくは「Strix Halo の長文 prefill ボトルネック検証 2026年版」で数値ベースで整理しています。
M5 Neural Accelerator が塞ぎに来た「Apple の prefill 弱点」
Apple は 2025 年 10 月に発表した M5 世代で、GPU の各コアに Neural Accelerator(行列演算ユニット) を搭載しました。これは Apple Silicon にとっての大きな設計変更で、狙いは明確に prefill の高速化です。
Apple 公式の Machine Learning Research が公開した MLX ベースの測定では、1.7B から 30B(MoE)までのモデル群で M5 の TTFT が M4 比で概ね 3.3〜4 倍高速 という結果が出ています(出典: Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU / Apple Machine Learning Research)。
一方 decode(tok/sec)の改善は 19〜27% 程度(M5 実測 1.19〜1.27 倍)に留まります。この非対称は、prefill が compute 律速・decode が帯域律速という本記事の構造そのままで、追加された Neural Accelerator が compute 側を強化した効果が prefill にだけ大きく出るためです。M5 世代の unified memory 帯域は M4 世代と大きくは変わっておらず、decode 側のスケールは帯域の伸び幅と一致します。
「Mac は長文で遅い」という従来の弱点は M5 世代で相当に埋まる見込みですが、これが実測でどこまで NVIDIA に迫るかはユーザー側の検証を待つ段階です。
用途別に「どちらを見るか」を決める
数値の見方を用途別に整理します。ここが本記事で持ち帰ってほしい実務判断の部分です。
| 用途 | 実効入力トークン数 | 主に効くフェーズ | 見るべき指標 |
|---|---|---|---|
| 短文チャット(1 往復完結) | 〜1K | decode 支配 | decode tok/sec |
| コード補完(VS Code Continue / Cline 補完) | 〜4K | decode 支配 | decode tok/sec、初回ロード時間 |
| 長文要約(記事 / 議事録) | 8K〜32K | prefill 支配 | prefill tok/s、TTFT |
| RAG(検索チャンク注入) | 8K〜32K | prefill 支配 | prefill tok/s、TTFT |
| コーディングエージェント(Aider / Claude Code 相当) | 16K〜64K | prefill 支配 | prefill tok/s、TTFT |
| ドキュメント全体投入(128K コンテキスト) | 64K〜128K | prefill 完全支配 | prefill tok/s、TTFT、KV キャッシュ VRAM |
「decode tok/sec だけで選んで痛い目を見る」典型が、エージェント運用です。 RTX 5090 と Mac Studio M4 Max では decode tok/sec の差は 2〜3 倍程度に収まるケースが多いのですが、16K〜64K の入力を毎ターン投げるエージェント運用では TTFT の差が 5〜10 倍まで開きます。「なぜ Mac は普段は速いのに、エージェント常用だと体感がしんどいのか」の答えはここにあります。
RAG も同様の構造で、検索チャンクの毎回注入によって入力が 8K〜32K で安定して大きくなり、prefill 側のスループットが実利用の可否を決めます。長文コンテキストと KV キャッシュ VRAM 消費の関係は「ローカルLLM のコンテキスト長と VRAM / KV キャッシュ 2026年版」で掘り下げています。
prefill を速くする 3 つのレバー
ハードを買い替えずに prefill を速くする現実的なレバーは 3 つあります。
1. Flash Attention 2 / 3 の有効化
Attention の計算を IO 最適化することで、prefill のスループットが 2〜4 倍に伸び、VRAM 消費も減ります。llama.cpp / vLLM / Transformers いずれもオプションで有効化できます。仕組みと有効化条件は「Flash Attention 2 / 3 の違いと使い方 2026年版」で扱っています。
2. KV キャッシュ量子化(Q8 / Q4)
prefill 後に構築される KV キャッシュは、長文で VRAM を圧迫する主因です。量子化すれば同じ VRAM でより長い入力を処理でき、TTFT の急激な悪化点を後ろへずらせます。
3. 入力自体の削減
システムプロンプトの短縮、RAG チャンクサイズの見直し、不要な履歴の切り捨てが根本的に効きます。「入力を 32K から 16K に半減できれば TTFT は概ね半減する」というのが線形性の当然の帰結で、ハード投資の前にまず削れるところがあるはずです。
サービング側の並列処理(複数リクエストの同時捌き)で prefill のスループットを効率化する話は、continuous batching / paged attention の領域で、詳細は「Continuous Batching と PagedAttention 2026年版」を参照してください。
まとめ:2 フェーズを分けて計測することがスタート地点
LLM 推論を 1 つの数字(decode tok/sec)で語る時代は、コンテキスト長がまだ 2K〜4K に収まっていた頃までの話です。エージェントと長文コンテキストが常態化した 2026 年の実務では、prefill と decode を 別々に計測する ことが判断のスタート地点になります。
覚えておくべきことは 3 つです。
- prefill は compute 律速:入力を並列に読み込む段階。NVIDIA GPU と M5 世代 Apple Silicon が有利
- decode は帯域律速:1 トークンずつ生成する段階。unified memory 帯域の高い Apple Silicon が健闘
- 用途で見る指標を変える:チャットなら decode tok/sec、エージェント・RAG・長文要約なら prefill tok/s と TTFT
数字を追いかけるフェーズに入る方は、本サイトの prefill GPU 別ベンチマーク と Strix Halo prefill ボトルネック検証 を続けて読むのが最短ルートです。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- prefill とは何ですか?
- prefill は、LLM が入力プロンプト全体を読み込んで最初のトークンを出すまでの処理を指します。入力トークン群を並列に処理して KV キャッシュを構築する段階で、行列演算のスループット(FLOPS)が律速要因になります。入力が長いほど時間が伸び、体感の遅さは主にここで決まります。「prompt processing」「prefill phase」とも呼ばれます。
- prefill と decode の違いは何ですか?
- prefill は入力を並列に読み込む compute(FLOPS)律速の処理、decode はその後の 1 トークンずつの生成でメモリ帯域律速の処理です。同じマシンでも入力が長ければ prefill が体感を支配し、入力が短ければ decode が支配します。CUDA コアを大量に積む NVIDIA GPU は prefill 側で有利、unified memory 帯域の高い Apple Silicon は decode 側で健闘するという非対称性の原因はこの律速の違いです。
- TTFT と prefill 速度は同じ意味ですか?
- ほぼ同じ意味で扱って構いません。TTFT(Time To First Token)は「入力を送ってから最初のトークンが返るまでの秒数」で、厳密には prefill 処理時間に少しの overhead(トークナイズ・キューイング・ネットワーク等)が乗った値です。ローカル実行では overhead が小さいため TTFT ≒ prefill 時間として扱えます。API 経由では通信遅延が加わります。
- エージェント用途で見るべきは prefill と decode のどちらですか?
- prefill 側の指標(prefill tok/s と TTFT)を優先してください。エージェントは長いシステムプロンプトとツール出力・履歴を毎ターン読み込むため、実効入力が 16K トークンを超える状態が常態化します。この帯域では decode より prefill が体感時間を支配し、prefill が遅いマシンでは 1 ターンごとに数十秒の沈黙が積み重なります。RAG も同様で、検索チャンクの毎回注入で入力が 8K〜32K に安定して膨らみます。
- プレフィル(IT 用語)は他分野でも使われますか?
- 「prefill」は 2 つの主な文脈で使われます。1 つ目は LLM 推論での用法で、入力プロンプトを読み込んで KV キャッシュを構築し最初のトークンを出す処理を指します。本記事で扱っているのはこちらです。2 つ目は Web / UI 分野の「プレフィル入力(prefilled form)」で、フォーム欄に初期値を埋めておく UX 手法を指します。同じ「事前に埋める」ニュアンスからの派生ですが、対象がモデル内部の KV キャッシュか、ユーザー画面のフォームかで意味が分かれます。
- LLM の 2 フェーズを一言で説明できますか?
- prefill が「入力を読む段階」、decode が「出力を書く段階」です。prefill は入力全体を並列に処理して最初のトークンを出すまでで、compute 律速。decode はその後の 1 トークンずつの逐次生成で、モデル重みを毎回読み出すためメモリ帯域律速。この 2 フェーズを別々に計測しないと、長文用途とチャット用途でハード選定を誤ります。
- prefill を速くするには何が効きますか?
- 実務では 3 つあります。第一に Flash Attention 2 / 3 を有効化することで、Attention 計算のスループットが 2〜4 倍に伸び、VRAM 消費も減ります。第二に KV キャッシュ量子化(Q8 / Q4)で、長文コンテキストの限界を伸ばせます。第三に入力自体の削減で、システムプロンプトの短縮・RAG チャンクサイズの見直し・不要な履歴の切り捨てが根本的に効きます。GPU 選定を変えずに 1.5〜3 倍の余裕を確保できる場合があります。