Ryzen 8700G APU でローカルLLM 2026
Ryzen 7 8700G / 8600G の Radeon 780M iGPU で 3B・7B・14B ローカルLLM が何 tok/sec 動くかを公開ベンチで集約。CPU-only 推論・iGPU 推論・DDR5 帯域の効き方を、Strix Halo(Ryzen AI MAX+ 395)・Snapdragon X2 Elite・Mac mini M4 との比較で 2 万円台 APU の実用ラインを判定します。
- #Ryzen 8700G
- #Ryzen 8600G
- #Radeon 780M
- #ローカルLLM
- #APU
- #iGPU
- #DDR5
- #Vulkan
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
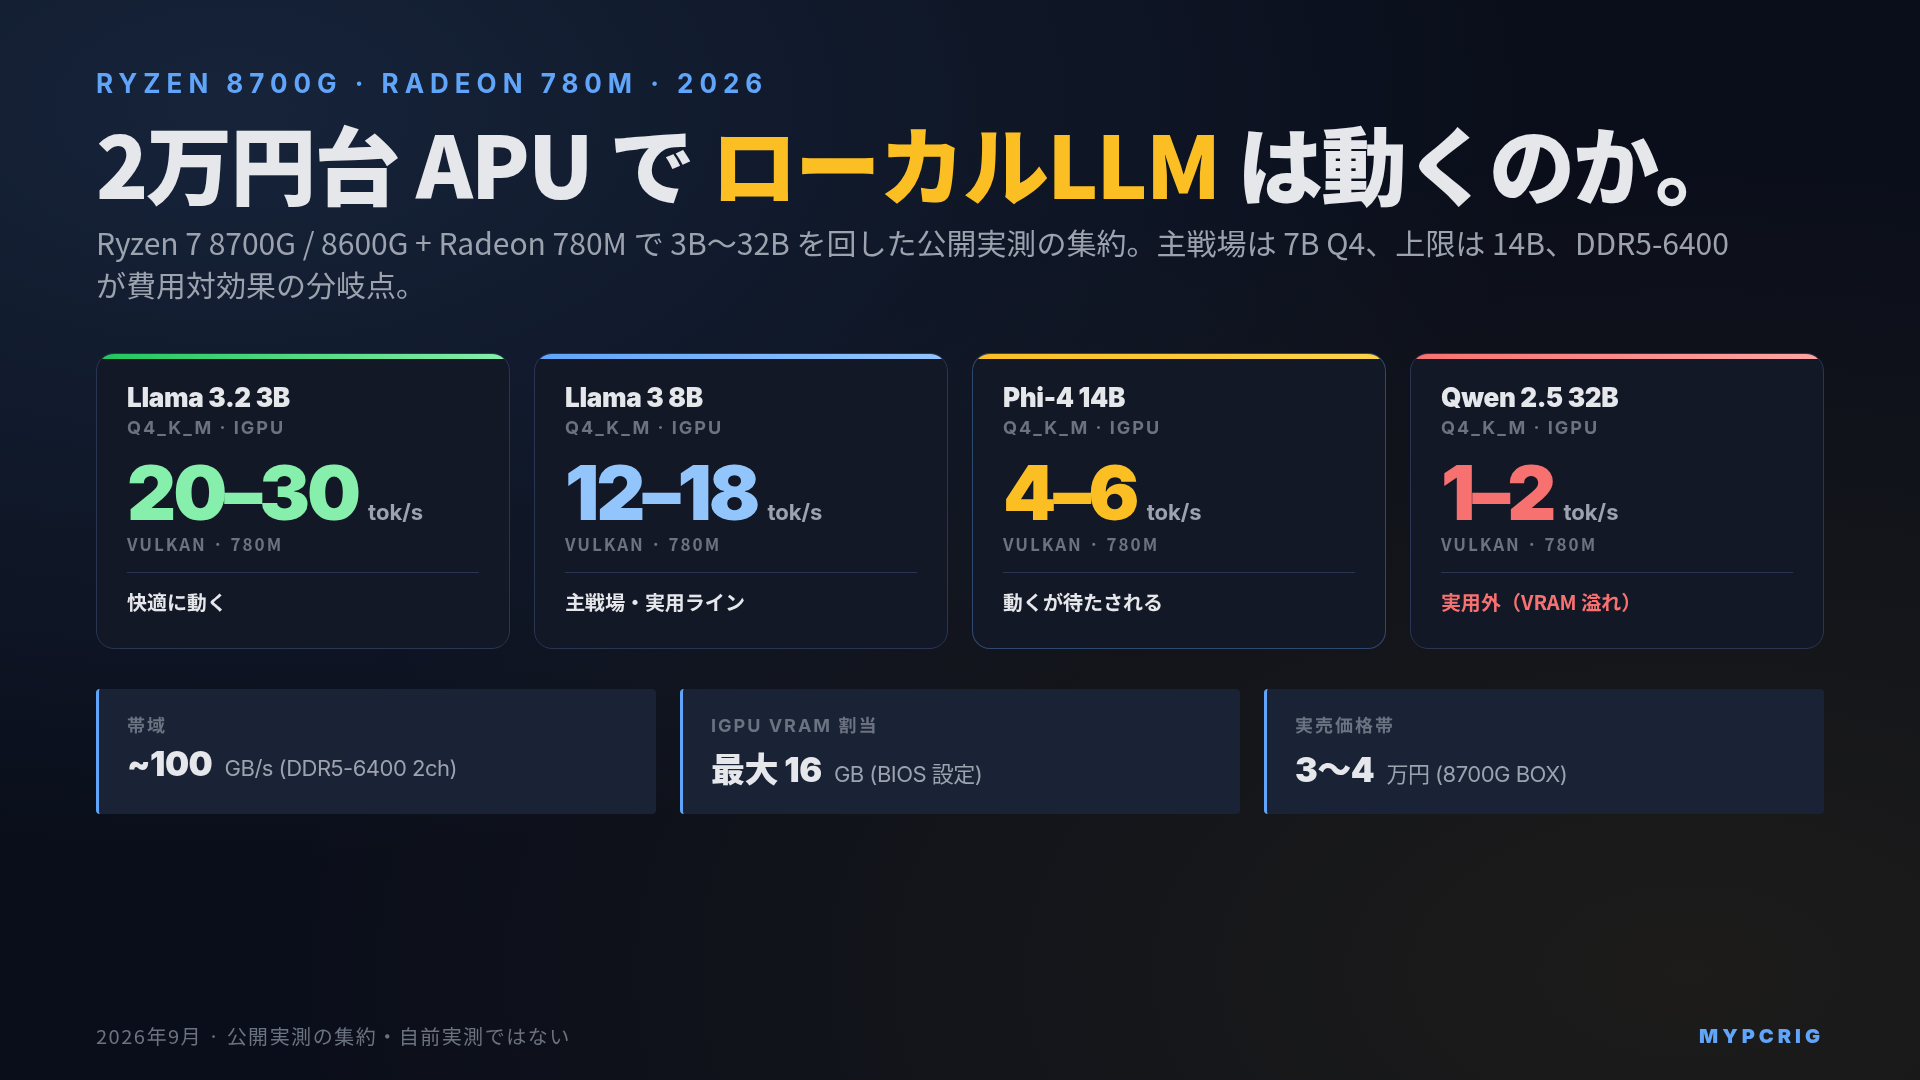
結論:Ryzen 7 8700G(Radeon 780M)は 3B〜7B ローカルLLM の入門機として成立します。Vulkan iGPU 推論で 7B Q4 が概ね 12〜18 tok/sec、3B Q4 が 20〜30 tok/sec、CPU-only(AVX-512)でも 7B Q4 で 8〜13 tok/sec の報告があります。14B Q4 は 4〜6 tok/sec で「動くが待たされる」、32B Q4 は 1〜2 tok/sec で実用外。tok/sec は DDR5 の実効帯域で線形にスケールするため、DDR5-6400 / 8000 の EXPO 品が費用対効果で最大です。Strix Halo(30〜40 万円で 70B 単体ロード)とは別カテゴリの入門用途機、と割り切ると 2〜4 万円台の APU で得られる価値は明確です。
「Strix Halo(Ryzen AI MAX+ 395)は買えないけど、iGPU でどこまで動くのか」という相談が 2026 年後半に増えています。デスクトップ AM5 APU である Ryzen 7 8700G / 8600G は 2〜4 万円台で入手でき、Radeon 780M(12 CU、RDNA 3)を積んだ最も安価な iGPU ローカルLLM 環境です。
本記事は 公開実測の集約 で、iris-lab の自前実測ではありません。自前実測環境は RTX 4070 12GB のみで、Ryzen 8700G / Radeon 780M は保有していないため、コミュニティ実測と公式ベンチを横断集約したデータをもとに構成します。出典は llama.cpp GitHub Discussions、Ollama Benchmarks (ai-ollama.github.io)、個人ブログの計測記事、Notebookcheck の 780M 分析です。数値は世代・量子化・バックエンドで動くので「傾向値」として読んでください。
ハードウェア前提:Radeon 780M と DDR5 帯域
Ryzen 8000G シリーズの LLM 推論性能を語る前に、ハードウェア仕様を 1 枚に集約します。
| 項目 | Ryzen 7 8700G | Ryzen 5 8600G | Ryzen 5 8500G |
|---|---|---|---|
| CPU | Zen 4、8C/16T | Zen 4、6C/12T | Zen 4 + Zen 4c、6C/12T |
| L3 キャッシュ | 16MB | 16MB | 16MB |
| iGPU | Radeon 780M、12 CU、RDNA 3 | Radeon 760M、8 CU、RDNA 3 | Radeon 740M、4 CU、RDNA 3 |
| NPU | Ryzen AI(XDNA、16 TOPS) | Ryzen AI(XDNA、16 TOPS) | 無し |
| メモリ規格 | DDR5-5200 公式、EXPO で DDR5-8000 動作報告あり | 同上 | 同上 |
| iGPU VRAM 割当 | BIOS で最大 16GB | 最大 16GB | 最大 8GB |
| TDP | 65W | 65W | 65W |
| 実売(2026 年 9 月) | 3〜4 万円台 | 2〜3 万円台 | 2 万円前後 |
LLM 推論はメモリ帯域律速のワークロードなので、ここで効くのはメモリ実効帯域です。DDR5 の実効帯域を並べます。
| メモリ構成 | 理論帯域 | 実効帯域(AIDA64 傾向値) |
|---|---|---|
| DDR5-4800 2ch | 76.8 GB/s | 60〜70 GB/s |
| DDR5-6000 2ch | 96.0 GB/s | 85〜90 GB/s |
| DDR5-6400 2ch | 102.4 GB/s | 95〜100 GB/s |
| DDR5-7200 2ch | 115.2 GB/s | 105〜110 GB/s |
| DDR5-8000 2ch(EXPO) | 128.0 GB/s | 115〜120 GB/s |
比較のために大容量機の帯域も並べます。8700G が「どのポジションにあるか」を体感するための表です。
| GPU / SoC | 帯域 | 利用可能メモリ |
|---|---|---|
| RTX 5090(32GB GDDR7) | 1,792 GB/s | 32GB |
| RTX 4060(8GB GDDR6) | 272 GB/s | 8GB |
| Ryzen AI MAX+ 395(Strix Halo) | 256 GB/s | 最大 96GB を VRAM 割当 |
| Snapdragon X2 Elite(LPDDR5X-8448) | 約 152 GB/s | 最大 64GB Unified |
| Mac mini M4(24GB LPDDR5X) | 120 GB/s | 24GB Unified |
| Ryzen 8700G + DDR5-6400 2ch | 約 100 GB/s(実効) | VRAM 最大 16GB 割当 |
8700G は帯域では Mac mini M4 に近く、RTX 4060 単体の 1/3 弱、Strix Halo の 4 割弱です。「動く容量帯(7B〜14B)は狭いが、帯域は Mac mini M4 級」 という位置付けが正しい理解になります。
7B Q4 が iGPU 推論の主戦場
公開実測の中心的なレンジをまとめます。数値は llama.cpp / Ollama / LM Studio の Vulkan バックエンド経由での実測が中心で、モデルと環境ごとに 10〜30% の分散があります。
| モデル | 精度 | Radeon 780M iGPU (Vulkan) | CPU-only (Zen 4 AVX-512) | 備考 |
|---|---|---|---|---|
| Llama 3.2 3B | Q4_K_M | 20〜30 tok/sec | 15〜22 tok/sec | 3B は帯域が飽和しにくく iGPU 有利 |
| Qwen 2.5 3B | Q4_K_M | 22〜30 tok/sec | 16〜23 tok/sec | 上とほぼ同傾向 |
| Mistral 7B / Llama 3 8B | Q4_K_M | 12〜18 tok/sec | 8〜13 tok/sec | iGPU で 1.3〜1.5 倍伸びる報告が多い |
| Qwen 2.5 7B | Q5_K_M | 8〜12 tok/sec | 6〜10 tok/sec | Q5 は帯域負荷が Q4 の 1.25 倍 |
| Phi-4 14B | Q4_K_M | 4〜6 tok/sec | 3〜5 tok/sec | 「動くが待たされる」ライン |
| Qwen 2.5 32B | Q4_K_M | 1〜2 tok/sec | 0.8〜1.5 tok/sec | VRAM 割当不足で PCIe オフロード発生、実用外 |
出典は llama.cpp GitHub Discussions(Performance of llama.cpp with Vulkan (#10879)、Optimize my llama.cpp (#21112))、Ollama Benchmarks (ai-ollama.github.io)、Vulkan Offload の実測 blog (zenvanriel.com) など複数ソースの集約です。
主戦場は 7B Q4 です。3B は快適に動きすぎて「わざわざローカルで回す用途」が絞れず、14B は待たされて実用性が急落し、32B は VRAM 溢れで動く価値が無くなります。7B Q4_K_M が Vulkan で 12〜18 tok/sec 出ることが 8700G の実用ラインを決めています。
iGPU と CPU-only、どちらが速いのか
Vulkan iGPU 推論のスループットは、モデルサイズが大きいほど CPU-only を上回りやすい傾向があります。ただし条件によっては CPU が iGPU を追い抜くケースも報告されています。原因は unified memory の構造で、iGPU と CPU が同じ DDR5 チャネルを共有しているため、CPU と iGPU が並行で帯域を奪い合うと iGPU の恩恵が消えることがあるためです。
Vulkan バックエンドのスループットは、llama.cpp のネイティブ CUDA 実装に対して概ね 85〜90% 程度、と GitHub Discussion では報告されています。iGPU 側の演算器が CUDA コアより少ないので、帯域より compute が効く場面(prefill、長文入力)では CPU-only との差がさらに縮みます。
運用上の落とし所 としては、7B 級では Vulkan を有効化して 1.3〜1.5 倍のスループットを取りに行くのが妥当で、3B 級では CPU-only でも 20 tok/sec 出るので好みで選んで問題ありません。ROCm は Radeon 780M(gfx1103)が正式サポート外で、非公式パッチと ONNX Runtime 経由の運用に留まるため、Vulkan を第一選択にするのが現実解です。
CPU-only ローカルLLM の詳細(Zen 5 世代の Ryzen 9950X3D / Threadripper 9970X との差、AVX-512 の効き方)は「ローカルLLM CPU-only 推論ベンチマーク 2026年版」で扱っています。
DDR5 帯域で tok/sec がスケールする構造
APU の iGPU 推論はメモリ帯域律速なので、DDR5 のクロックが直接 tok/sec に効きます。同じ 8700G でも DDR5-4800 と DDR5-8000 では 7B Q4 の decode tok/sec が概ね 1.5 倍前後変わります。
| DDR5 構成 | 7B Q4 tok/sec 目安(Vulkan iGPU) | 相対(DDR5-4800 = 1.0) |
|---|---|---|
| DDR5-4800 2ch | 9〜12 tok/sec | 1.00 |
| DDR5-6000 2ch | 12〜15 tok/sec | 1.30 |
| DDR5-6400 2ch | 13〜17 tok/sec | 1.42 |
| DDR5-7200 2ch | 14〜18 tok/sec | 1.53 |
| DDR5-8000 2ch(EXPO) | 15〜20 tok/sec | 1.67 |
費用対効果の分岐点は DDR5-6400 です。DDR5-4800 → 6400 で 1.4 倍伸びるのに対し、6400 → 8000 の伸び幅は 1.15 倍前後で、価格差(DDR5-8000 EXPO 品は 6400 品の 1.5〜2 倍)に見合わない場合が多くなります。DDR5-6400 EXPO 品を選び、余った予算を SSD / 電源側へ回すのが実務的です。
DDR5 世代別の tok/sec スケール検証は「DDR5-6000 vs 7200 vs 8000 ローカルLLM ベンチ 2026年版」でクロック別に整理しています。
上位ラインとの棲み分け:Strix Halo / Snapdragon X2 / Mac mini M4
「8700G より上を狙うならどこか」を判断するために、周辺帯の代替機と横並びで見ます。
| 機材 | 実効帯域 | 使えるモデル上限 | 実売価格帯 | 位置付け |
|---|---|---|---|---|
| Ryzen 7 8700G + DDR5-6400 | 約 100 GB/s | 14B Q4 まで(実用は 7B Q4) | 本体 8〜12 万円 | 入門・7B 主戦場 |
| Snapdragon X2 Elite ノート | 約 152 GB/s | 14B Q4 まで | ノート本体 18〜25 万円 | モバイル・Copilot+ 連携 |
| Mac mini M4 24GB | 120 GB/s | 14B Q4 まで | 15 万円前後 | 静音・完成品 |
| Ryzen AI MAX+ 395(Strix Halo) | 256 GB/s | 70B / 120B 単体ロード | 30〜40 万円 | 大容量・省電力 |
| RTX 5060 Ti 16GB + AM5 CPU | 448 GB/s(GDDR7) | 14B Q4〜32B Q4 | 20〜25 万円 | 速度と汎用性のバランス |
8700G が最も費用対効果で勝つのは 7B Q4 まで です。14B Q4 の常用が想定に入るなら Mac mini M4 か Snapdragon X2 Elite、コード補完の低レイテンシを取るなら RTX 5060 Ti 16GB + AM5 CPU、70B クラスまで手を伸ばすなら Strix Halo、と 1 段階ずつ用途と予算のはしごが上がります。
Strix Halo の実測は「Ryzen AI MAX+ 395(Strix Halo)ローカルLLM 推論ベンチマーク 2026年版」に集約しています。Copilot+ PC / NPU 側の視点は「NPU ローカルLLM 比較 2026年版」で扱っています。
エージェント常用は厳しい:prefill の壁
decode tok/sec で見ると 8700G は 7B で十分に実用ですが、コーディングエージェント用途では別の指標が壁になります。prefill(プロンプト処理) です。
エージェントは毎ターン、システムプロンプト + ツール出力 + ファイル履歴 + RAG チャンクを合算した長いプロンプトを投げ直します。実効入力は 16K〜64K トークンに膨らみ、この帯域では decode より prefill が体感時間を支配します。780M の iGPU は演算スループットが低いため、16K 入力の TTFT(Time To First Token)が数十秒〜1 分オーダーになる公算が高く、エージェント常用では 1 ターンごとの沈黙が積み重なって作業速度が体感で半減します。
8700G の実用領域 をまとめると次の通りです。
- コード補完(実効入力 4K 以下、7B Q4):Vulkan iGPU で decode 12〜18 tok/sec、実用範囲
- 短文チャット(1〜2K 入力):3B / 7B とも快適、Mac mini M4 と体感差は小さい
- 長文要約(8K〜32K 入力):prefill 待ちが厳しい、単発なら忍耐可
- RAG(8K〜32K 入力、検索チャンク注入):同上、常用は避ける
- コーディングエージェント(16K〜64K 入力):非推奨、Strix Halo / dGPU に逃げる
- 32B / 70B 常用:不可、Strix Halo か dGPU
prefill と decode の律速要因の違いは「LLM Prefill / Decode の違い 2026年版」で解説しています。エージェント用途で必要な PC スペックは「ローカルLLM 最低スペック 2026年版」も併読すると解像度が上がります。
Zen 5 APU の見通し
デスクトップ AM5 APU の次世代(Kraken Point / Strix Point デスクトップ版、通称 Ryzen 9000G)の発売時期については、2026 年 9 月現在で AMD からの正式発表は出ていません。噂ベースの海外メディア記事はいくつか出ていますが、購入判断の根拠にできる裏取りが取れる状況ではないのが実情です。
現時点で iGPU ローカルLLM をすぐ始めたい なら、以下の 2 択が現実解です。
- Ryzen 7 8700G + DDR5-6400 32GB EXPO:3〜4 万円で入手、7B Q4 主戦場、AM5 継続なので Zen 5 APU が来たら差し替え可能
- Ryzen 5 8600G + DDR5-6400 32GB EXPO:2〜3 万円、780M より 8CU の 760M で 7B が 85〜90% スループット。予算差を DDR5 / SSD に回す方が体感が伸びる
Ryzen 5 8500G は 4 CU の Radeon 740M で iGPU 経由の恩恵が小さく、Ryzen AI 推論用途では 8600G が費用対効果で優位です。8500G を選ぶなら、予算差で dGPU(中古の RTX 3060 12GB 等)を検討したほうが実用体感が上がります。
まとめ:入門機として明確に成立する 2〜4 万円 APU
Ryzen 8700G / 8600G は、7B Q4 ローカルLLM の入門ハード として位置付けが明確です。Strix Halo の下位版でも、Mac mini M4 の代替でもなく、「2〜4 万円で組めて 7B が 12〜18 tok/sec 動く」という独自ポジションです。
3 点だけ持ち帰ってください。
- 主戦場は 7B Q4、3B は簡単すぎ、14B は待たされる、32B は実用外
- DDR5-6400 EXPO を選ぶ、これ以上のクロックは費用対効果で分岐点を越える
- エージェント常用は非推奨、コード補完・チャット・軽い RAG までなら十分
「2〜4 万円で LLM を回して感触を掴む」フェーズに最も向くのが 8700G です。本格運用に踏み込む段階で Strix Halo か dGPU に乗り換える、というはしごの下段としては合理的な選択肢になります。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
CPU 本体(AM5 APU)
メモリ(DDR5-6400 EXPO 32GB)
マザーボード(AM5、DDR5-6400 対応)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- Ryzen 8700G でローカルLLMは実用的に動きますか?
- 3B〜7B クラスなら実用ラインです。公開実測の集約では、Radeon 780M iGPU + Vulkan バックエンドで 7B Q4_K_M が概ね 12〜18 tok/sec、Llama 3.2 3B なら 20〜30 tok/sec レンジ、CPU-only(AVX-512 有効)でも 7B Q4 が 8〜13 tok/sec の報告があります。14B Q4 になると DDR5 帯域が支配的になり 4〜6 tok/sec で「動くが待たされる」ライン、Q4 32B は 1〜2 tok/sec で実用外です。2〜4 万円台の APU で 7B までを回すという割り切りなら十分成立します。
- iGPU(Radeon 780M)を使うと CPU-only より速くなりますか?
- モデルサイズと Vulkan / ROCm の状況で分岐します。7B Q4 前後では Vulkan バックエンド経由で 1.3〜1.5 倍程度 iGPU が有利という報告が多い一方、条件によっては CPU が iGPU を上回る計測もあります(unified memory 帯域を CPU と iGPU が奪い合う構造のため)。Vulkan は llama.cpp のネイティブ実装に対して 85〜90% 程度のスループット、と GitHub Discussion では報告されています。ROCm は 780M(gfx1103)が正式サポート外で、非公式パッチや ONNX Runtime 経由の運用に留まります。
- DDR5 のクロックは tok/sec にどれくらい効きますか?
- iGPU 推論・CPU 推論いずれもメモリ帯域律速なので、DDR5 の実効帯域がそのまま decode 上限に効きます。DDR5-4800 2ch の実効帯域は約 60〜70 GB/s、DDR5-6000 2ch で約 85〜90 GB/s、DDR5-6400 2ch で約 95〜100 GB/s、DDR5-8000 2ch まで詰めると約 120 GB/s 前後です。Ryzen 8000G シリーズは AGESA 更新で DDR5-8000 EXPO も動かせるようになっており、8B Q4 で 1.3〜1.5 倍程度のスケールが期待できます。仕組みは「[メモリ帯域幅(GB/s)がローカルLLMの tok/sec を決める仕組み 2026年版](/blog/memory-bandwidth-local-llm-tok-sec-2026/)」で解説しています。
- Ryzen 8700G と Strix Halo(Ryzen AI MAX+ 395)はどう違いますか?
- 帯域と VRAM 割当が桁違いです。Strix Halo は LPDDR5X-8000 256-bit 幅で実効 256 GB/s、iGPU に最大 96GB を VRAM として割り当てられ、70B / 120B クラスを単体でロードできます。8700G は DDR5-6400 2ch で実効 100 GB/s 前後、iGPU VRAM 割当は BIOS で最大 16GB(実質 8〜12GB 運用)が現実線で、14B Q4 が上限です。用途で切り分けると、Strix Halo は 30〜40 万円で 70B までを本格運用する機、8700G は 2〜4 万円台で 7B までを回す入門機、と別カテゴリと理解するのが正確です。
- Ryzen 8600G / 8500G でも同じことができますか?
- 8600G(Radeon 760M、8 CU)はほぼ同じ挙動で、7B Q4 で 780M 比 85〜90% 程度のスループットが目安です。8500G(Radeon 740M、4 CU)は iGPU 経由の恩恵が小さく、CPU-only 運用に近い動きになります。予算配分としては 8600G + DDR5-6400 に浮いた分を投じたほうが体感が伸びるケースが多く、Ryzen AI 推論用途では 8500G より 8600G が費用対効果で優位です。
- Ryzen 9000G(Zen 5 APU)は待つべきですか?
- 現時点(2026 年 9 月)で AMD からデスクトップ AM5 APU の新世代(Kraken Point / Strix Point デスクトップ版)に関する正式な発売日発表は出ていません。噂ベースの記事は複数出ていますが、購入判断の根拠にできる裏取り情報は無いのが実情です。すぐ動かしたい方は 8700G / 8600G で組み、Zen 5 APU が来たときに APU だけ差し替える(AM5 継続前提)運用が現実的です。未発売品への購入 CTA は本記事では貼っていません。
- コーディングエージェント用途で 8700G は使えますか?
- 厳しいラインです。エージェントは実効入力が 16K トークン超に膨らむため、prefill(プロンプト処理)が支配的になります。8700G は iGPU の演算スループットが低く、780M で 16K 入力の TTFT は数十秒〜1 分オーダーになる可能性が高いです。コード補完(実効入力 4K 以下)の 7B 用途なら decode tok/sec で判断できるので実用範囲、エージェント常用は Strix Halo 以上または dGPU(RTX 5060 Ti 16GB クラス以上)に逃げるのが妥当です。prefill と decode の違いは「[LLM Prefill / Decode の違い 2026年版](/blog/prefill-decode-llm-inference-explained-2026/)」を参照してください。