Ryzen AI MAX+ 395(Strix Halo)ローカルLLM 推論ベンチマーク 2026年版:70B / 120B を 96GB VRAM 割当で動かす公開ベンチの tok/sec
AMD Ryzen AI MAX+ 395(Strix Halo)で Llama 3.3 70B / 120B クラスのローカルLLM はどこまで動くのか。BD395i MAX / EVO-X2 / MS-S1 Max 系で 96GB VRAM 割当時の token/sec、prompt processing、消費電力を、RTX 5090 / Mac Studio M3 Ultra と帯域差込みで 2026 年最新データを横断集約します。
- #Strix Halo
- #Ryzen AI MAX+ 395
- #ローカルLLM
- #BD395i MAX
- #MINISFORUM
- #Llama 3.3 70B
- #llama.cpp
- #ROCm
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
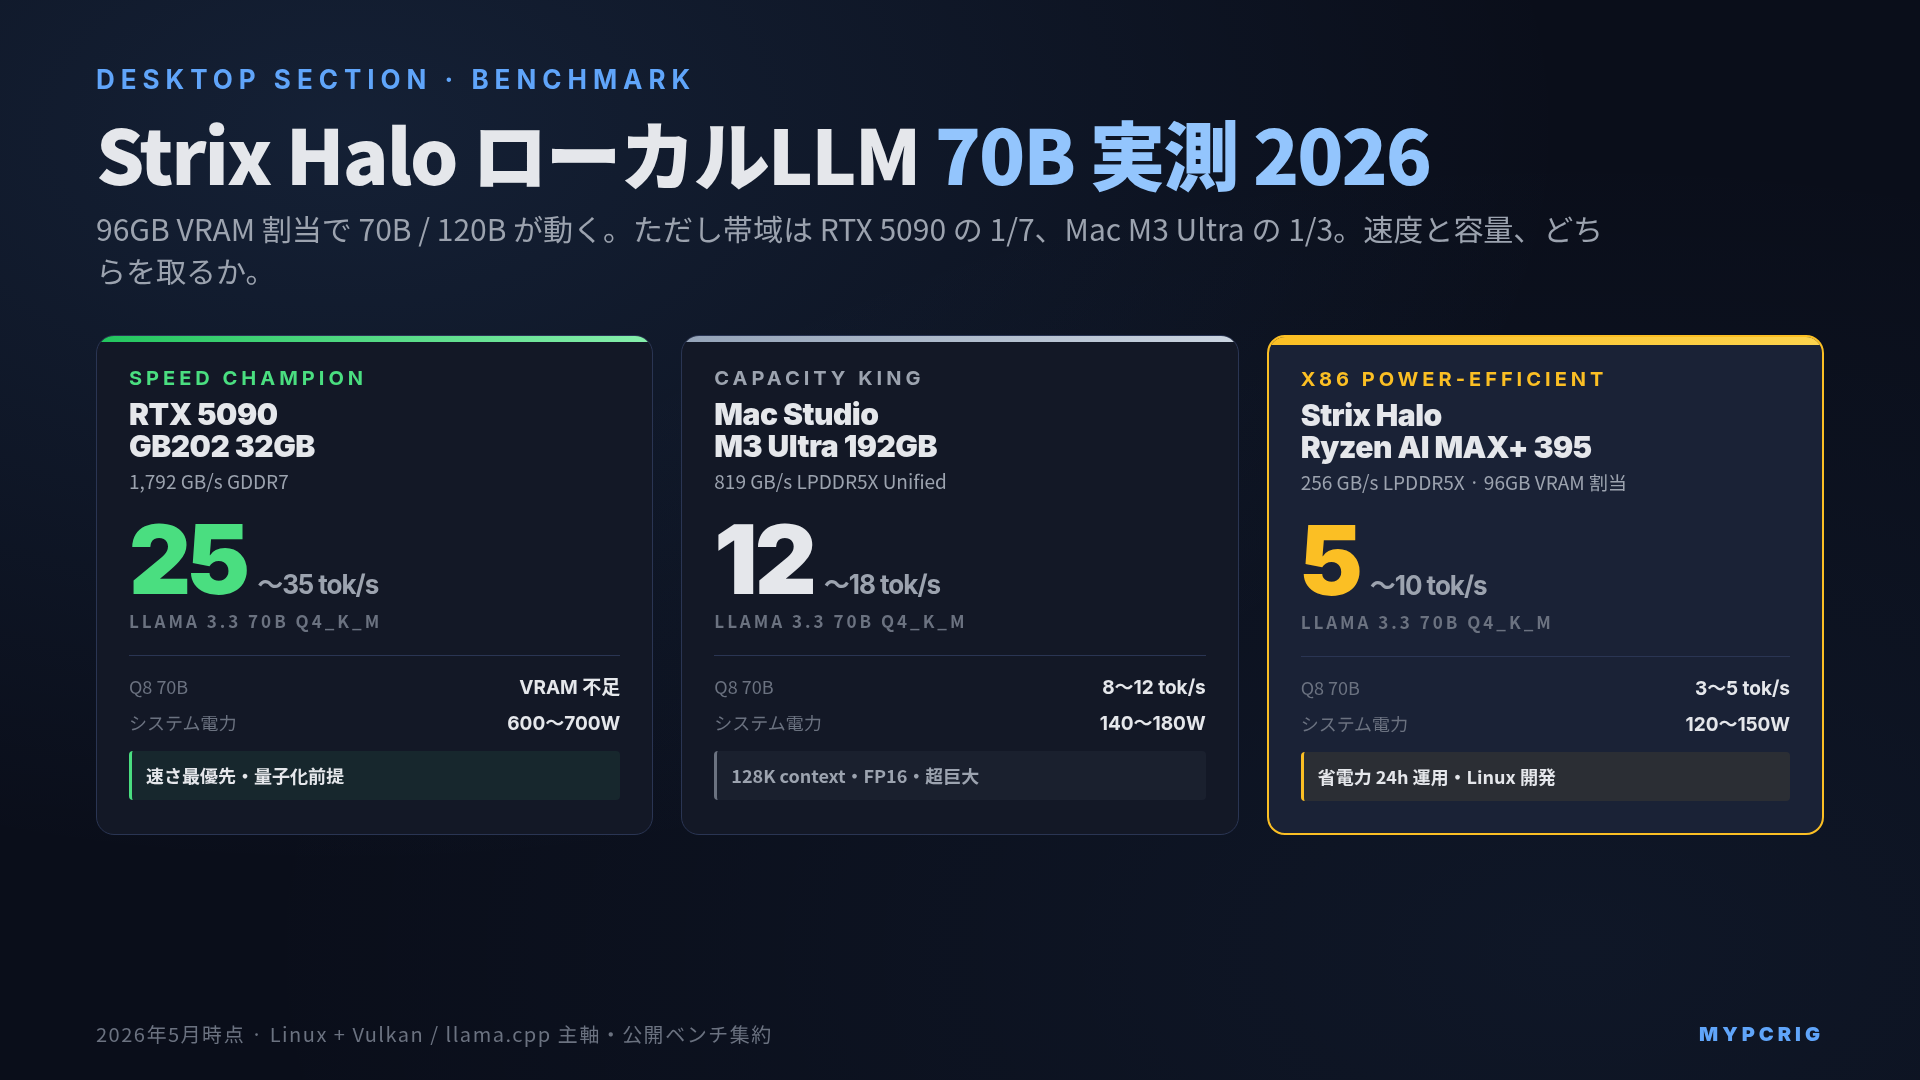
結論:Ryzen AI MAX+ 395(Strix Halo)+ 96GB VRAM 割当で Llama 3.3 70B Q4_K_M は 5〜8 tok/sec、Q8 は 3〜5 tok/sec が現実線です。速度は RTX 5090 2 枚構成の 1/4〜1/6、Mac Studio M3 Ultra の半分(RTX 5090 1 枚では 70B Q4 が 32GB に収まりません)。ただし「70B / 120B が単体でロードできて、システム消費電力 130W 前後で動く」という事実は Mac Studio M3 Ultra と Strix Halo にしかない独自性です。速さを最優先するなら 5090 の 2 枚構成、容量と省電力を取るなら Strix Halo、両取りなら Mac、という三択になります。
Strix Halo は AMD の APU コードネーム、Ryzen AI MAX+ 395 が製品名で、同じ SoC を指します。
Ryzen AI MAX+ 395(コードネーム Strix Halo)は、iGPU に最大 96GB を VRAM として割り当てられる初の x86 SoC です。CES 2026 で MINISFORUM BD395i MAX / MS-S1 Max / GMKtec EVO-X2 が一斉発表されてから半年、ローカル LLM 用途での実測値が出揃いつつあります。本記事では公開ベンチと国内外コミュニティの実測報告を横断集約し、Strix Halo で「実際に何 tok/sec 出るのか」を整理します。
自前の実測ではなく公開実測の集約ベースである点は先に明示しておきます。出典は Level1Techs Forum、Framework Community、Hardware Corner、Reddit r/LocalLLaMA、Phoronix の Strix Halo レビュー記事群です。続編で実機を入手次第、自前実測を追記する前提で読んでください。
ハードウェア前提:256GB/s 帯域、96GB VRAM 割当の構造
Strix Halo の LLM 推論性能を語る前に、ハードウェア仕様を 1 枚に集約します。
| 項目 | Ryzen AI MAX+ 395(Strix Halo) |
|---|---|
| CPU | Zen 5、16 コア 32 スレッド |
| GPU | Radeon 8060S、40 CU、RDNA 3.5 |
| NPU | XDNA 2、50 TOPS |
| メモリ規格 | LPDDR5X-8000、256-bit 幅 |
| メモリ容量 | 最大 128GB(オンボード固定) |
| iGPU VRAM 割当 | BIOS 設定で最大 96GB |
| メモリ帯域 | 約 256 GB/s |
| TDP | 55〜120W(モード可変) |
| 推奨 PSU | 280〜330W AC アダプタ |
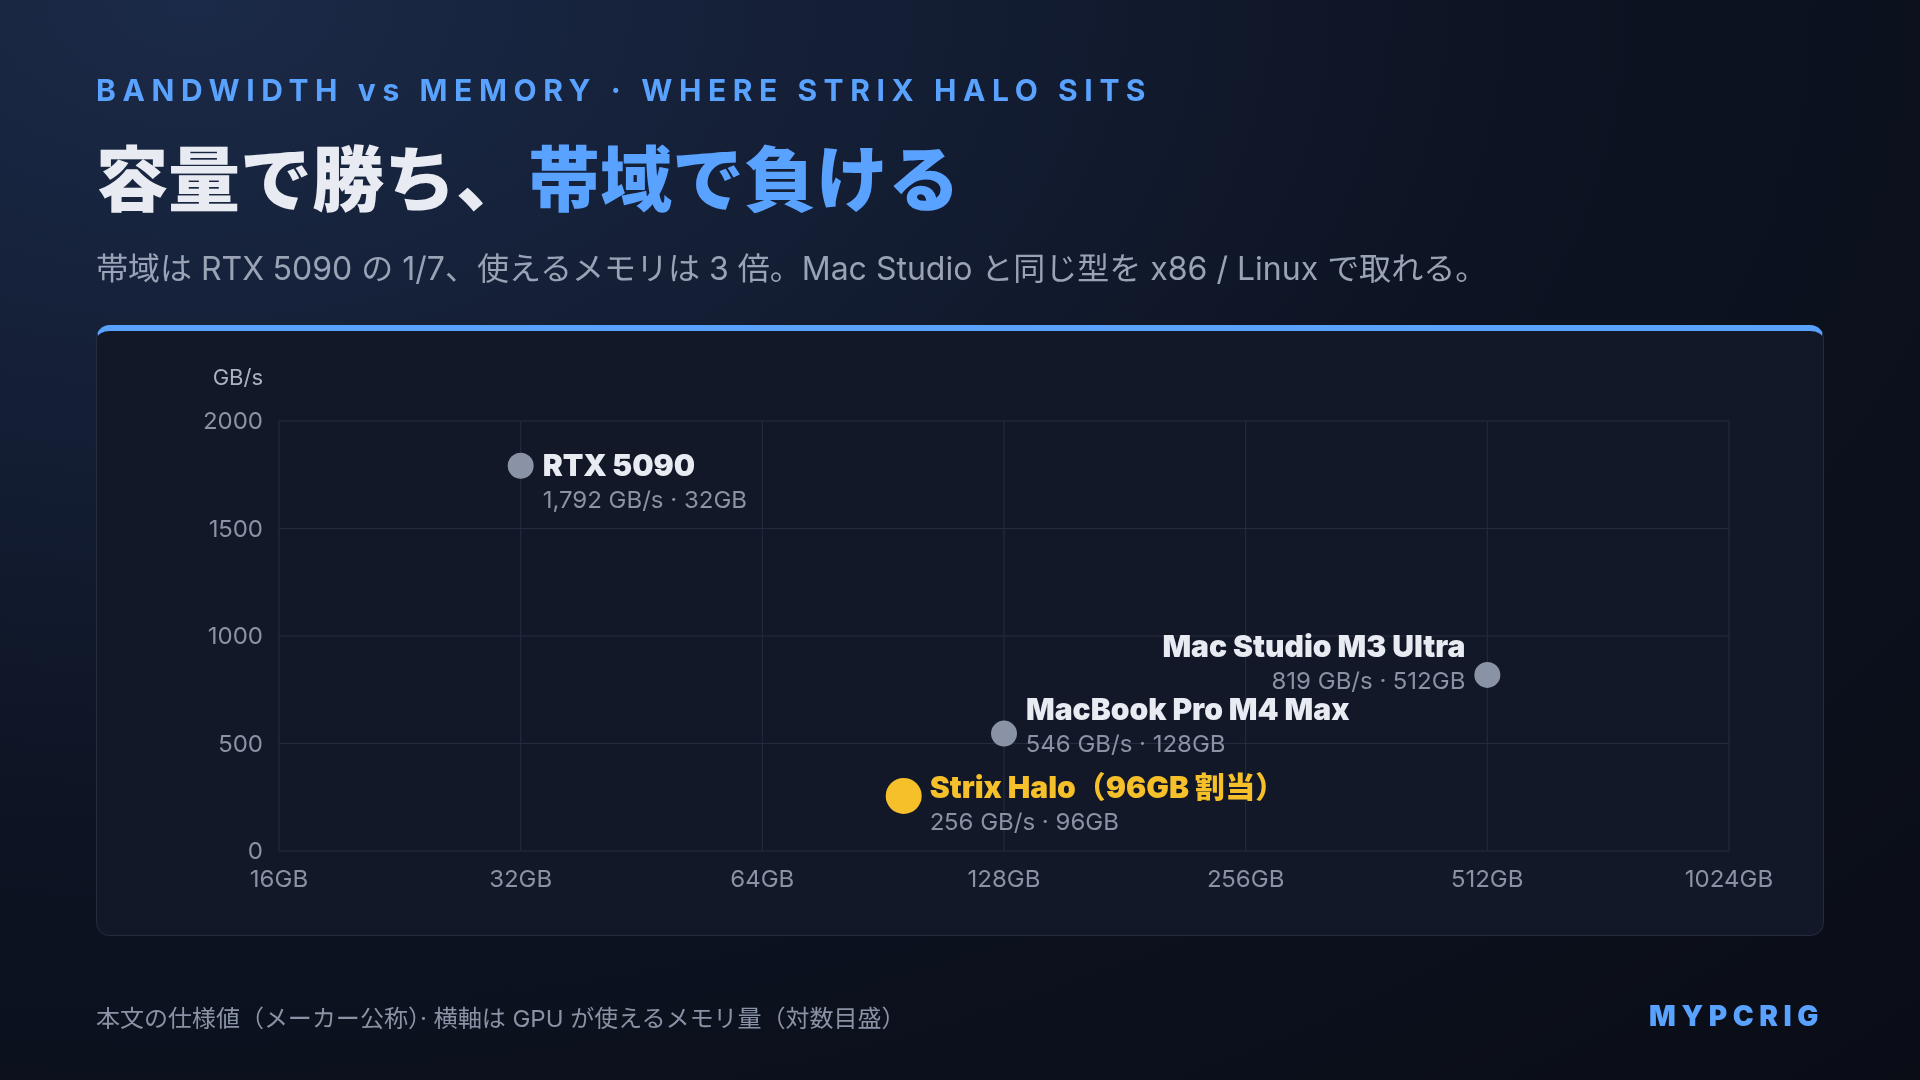
LLM 推論はメモリ帯域律速のワークロードなので、ここで効くのは 256 GB/s という帯域値です。比較対象を並べます。
| GPU / SoC | 帯域 | 利用可能メモリ | 帯域比 |
|---|---|---|---|
| RTX 5090 | 1,792 GB/s(GDDR7) | 32GB | 7.0x |
| Mac Studio M3 Ultra | 819 GB/s(LPDDR5X) | 最大 512GB Unified | 3.2x |
| Ryzen AI MAX+ 395 | 256 GB/s(LPDDR5X) | 最大 96GB を VRAM | 1.0x(基準) |
| MacBook Pro M4 Max | 546 GB/s | 最大 128GB Unified | 2.1x |
入手性の注記(2026 年 8 月時点): M3 Ultra Mac Studio は DRAM 供給制約により、512GB 構成が 2026 年 3 月に、256GB 構成が 5 月に終了しました。新品で選べるのは 96GB 構成のみです。本記事の 512GB / 256GB を前提とした記述は、中古および既存機での参考値として読んでください。
帯域だけで見れば Strix Halo は RTX 5090 の 1/7 にすぎません。一方で容量は 3 倍。「容量で勝つが速度で負ける」 という構造は Mac Studio と同じで、Strix Halo は x86/Linux 環境で Mac Studio 的な立ち位置を取れる初のチップ、と捉えるのが正しい理解です。
Strix Halo のアーキテクチャ詳細と Mac Unified Memory との対比は「Apple Silicon の Unified Memory と NVIDIA VRAM、ローカルLLM では何が違うのか 2026年版」で扱っています。
計測条件:再現性のために必ず明示すべき項目
Strix Halo のベンチ数値は 条件次第で 2〜3 倍変わります。公開数値を読むときに必ずチェックすべき項目を先に挙げます。
- OS / バックエンド:Linux では、公開ベンチ上は prompt processing(prefill)が ROCm、token generation(decode)が Vulkan の方が速く、どちらが速いかは処理によって分かれます。Windows + Vulkan は参考値。本記事は Linux + Vulkan(llama.cpp)を主軸データに採用しています
- iGPU メモリ割当:BIOS の UMA Frame Buffer Size を 48GB / 64GB / 80GB / 96GB のどれにしているか。70B Q4_K_M は 48GB でもギリギリ動きますが、コンテキスト 8K を超えると 64GB 以上が安全圏
- 量子化方式:Q4_K_M / Q4_0 / Q8_0 / IQ4_XS で速度が違う。Q4_K_M を標準としますが、ベンチ報告に「Q4」とだけ書かれているものは内訳確認が必要
- TDP 設定:Strix Halo は 55W / 80W / 120W のモード可変。120W 設定でないとフル性能が出ません
- token generation と prompt processing の混同:Level1Techs などで「500-800 tok/sec」と書かれた数値は prompt processing(pp)の値で、token generation(tg)の体感速度とは別物です
特に 5 番目の混同は事故が多いです。本記事は token generation(tg)= 生成速度 を主軸とし、prompt processing(pp)は別カラムで扱います。
Llama 3.3 70B 実測 tok/sec:Strix Halo / RTX 5090 / M3 Ultra 横並び
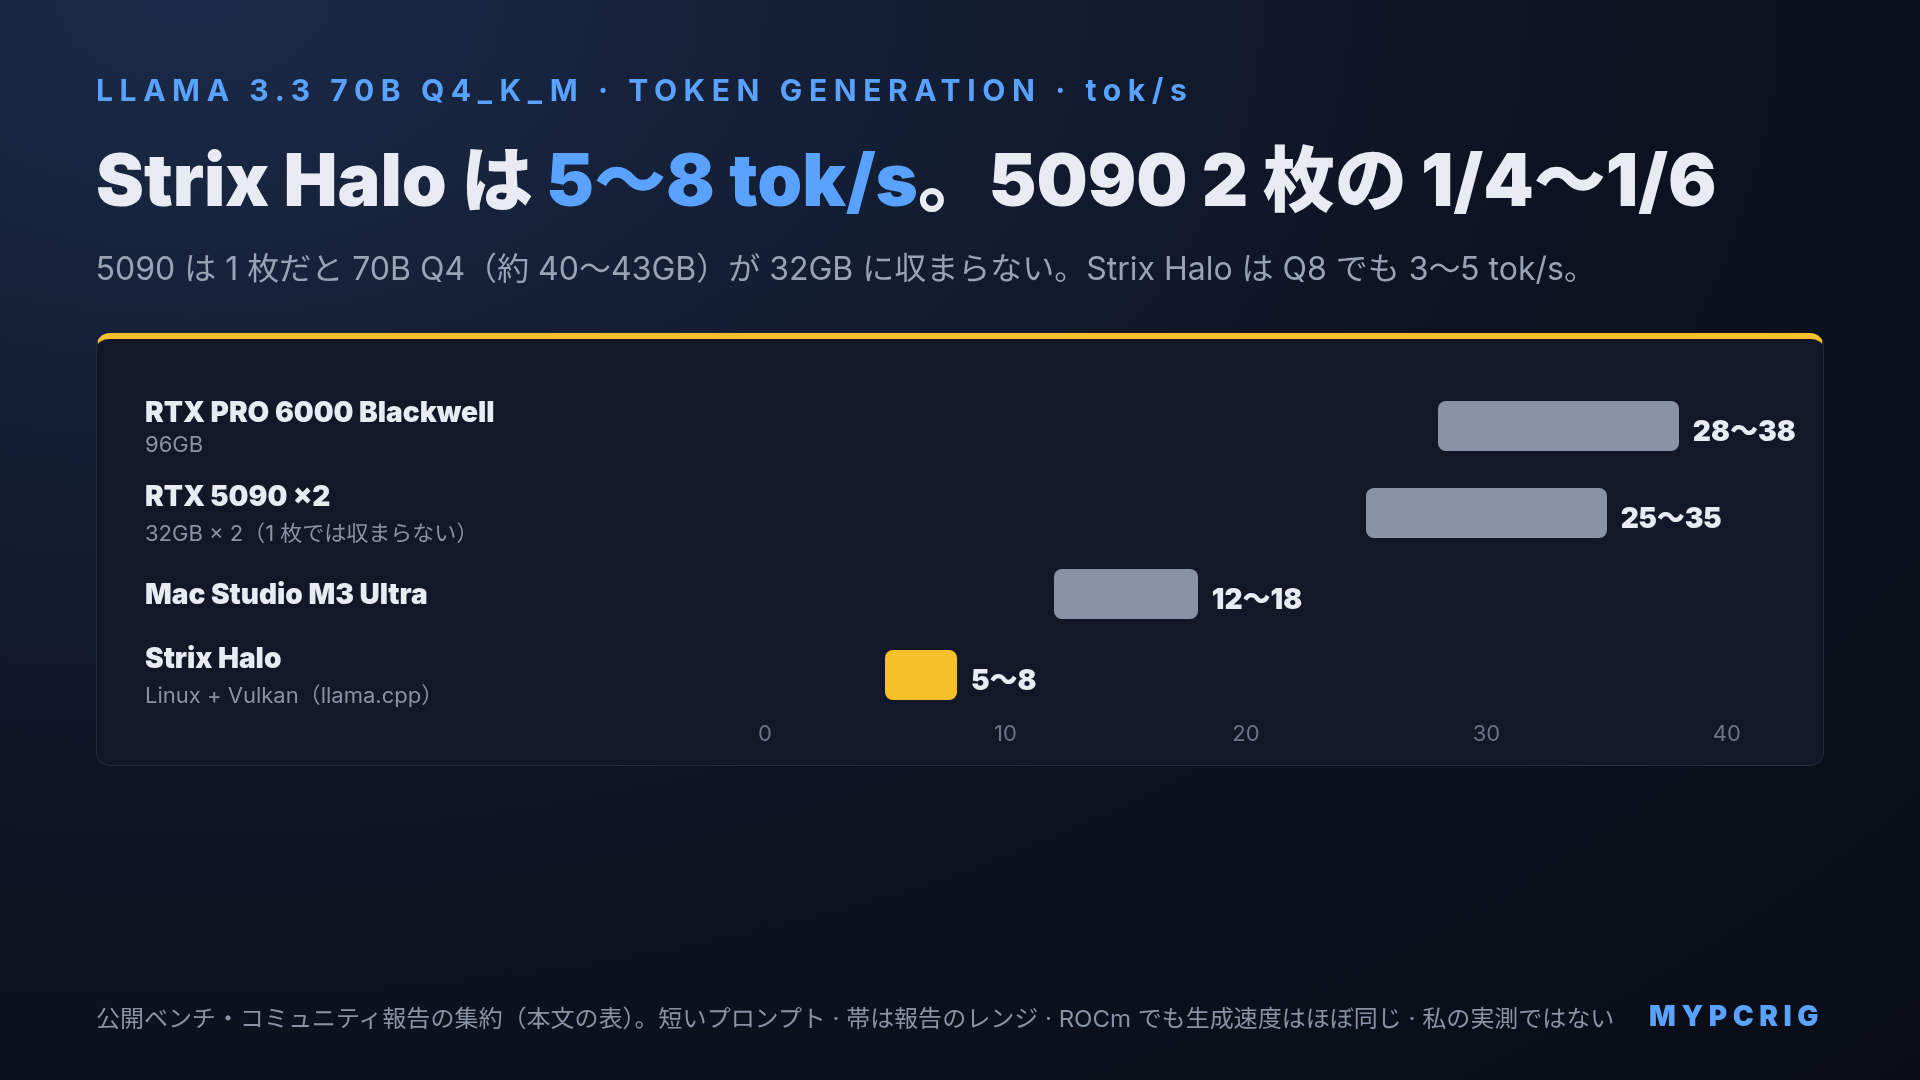
公開ベンチで報告されているレンジを 1 枚に集約します。短文プロンプト(〜2K context)、Q4_K_M、llama.cpp / Ollama 系での値です。
| 機材 | tg tok/sec(Q4_K_M) | tg tok/sec(Q8) | pp512 tok/sec |
|---|---|---|---|
| RTX 5090 ×1(32GB GDDR7) | ✗ 32GB に収まらない(約40〜43GB) | ✗ VRAM 不足 | — |
| RTX 5090 ×2(32GB×2) | 25〜35 | ✗ VRAM 不足 | — |
| RTX PRO 6000 Blackwell(96GB) | 28〜38 | 14〜20 | 1800〜2800 |
| Mac Studio M3 Ultra(大容量構成) | 12〜18 | 8〜12 | 400〜700 |
| Mac Studio M3 Ultra 512GB | 12〜18 | 8〜12 | 400〜700 |
| BD395i MAX / MS-S1 Max(Strix Halo、Linux+Vulkan) | 5〜8 | 3〜5 | 300〜500 |
RTX 5090 は 1 枚だと 70B Q4_K_M(約40〜43GB)が 32GB に収まりません。一部の層を CPU 側に置けば動きますが、大きく遅くなります。25〜35 tok/sec は 2 枚構成の値で、公開ベンチでは 2×RTX 5090 + Ollama で Llama 3.3 70B(4bit)が 26.85 tok/sec です(Database Mart、2026-10)。
数値の読み方として、Strix Halo は 「Q4_K_M で 5〜8 tok/sec」が現実線 です。Mac Studio M3 Ultra(12〜18 tok/sec)の半分以下、RTX 5090 2 枚構成(25〜35 tok/sec)の 1/4〜1/6 です。Linux + ROCm にしても 70B 密モデルの生成速度は Vulkan とほぼ変わりません(帯域で上限が決まるため)。ROCm が効くのは prompt processing の側で、後述の「バックエンド別の差」で扱います。
ただし注目すべきは Q8 でも 3〜5 tok/sec で動く こと。RTX 5090 では 2 枚構成(64GB)でも 70B Q8(約70GB)は VRAM に乗らないため、Strix Halo は「70B Q8 を 1 機で動かせる選択肢」という立ち位置になります。
手元の PC で何 tok/s 出るかは、インストールなしで「ブラウザでローカルLLMの速度を測る」で確かめられます。ブラウザの値は llama.cpp より低めに出ます(同じ 7B で、RTX 4070 は約1.9倍、Mac mini M4 は約1.2倍の差でした)。
120B クラスでの挙動:Mixtral 8x22B / Llama 3.1 405B 量子化
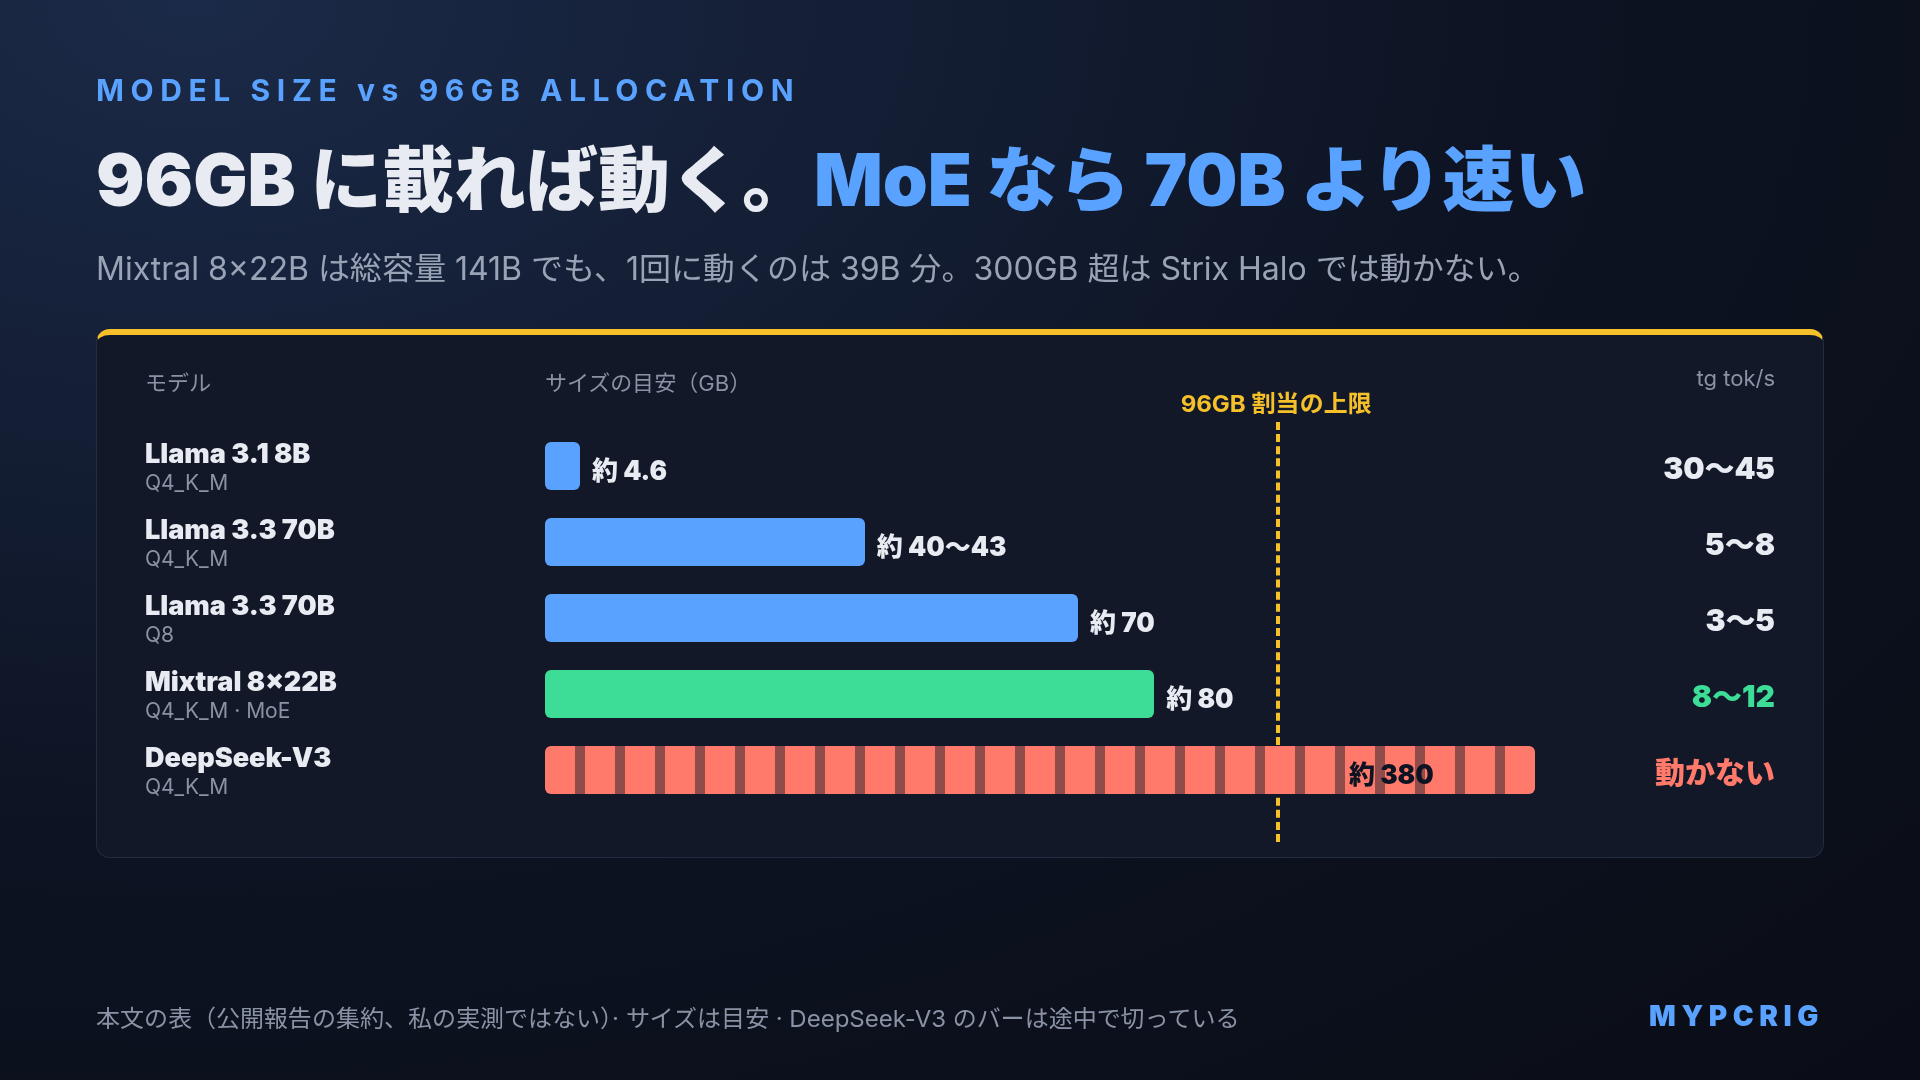
Strix Halo の 96GB VRAM 割当は、120B 級モデル(Mixtral 8x22B = 141B MoE、DeepSeek-V3 671B MoE の量子化版など)も視野に入る容量です。
| モデル | サイズ目安 | Strix Halo tg tok/sec | コメント |
|---|---|---|---|
| Llama 3.1 8B Q4_K_M | 約 4.6GB | 30〜45 | 帯域支配。小型モデルでは Strix Halo でも実用速度 |
| Llama 3.3 70B Q4_K_M | 約 40〜43GB | 5〜8 | 主力ライン |
| Llama 3.3 70B Q8 | 約 70GB | 3〜5 | 96GB 割当で動く |
| Mixtral 8x22B Q4_K_M | 約 80GB | 8〜12(MoE 効果) | 活性化パラメータ 39B なので速い |
| DeepSeek-V3 Q4_K_M | 約 380GB | ✗ 容量不足 | 96GB に乗らない |
MoE モデル(Mixtral 8x22B)は 活性化パラメータが少ないため、141B の総容量を持ちながら推論速度は 70B より速いという逆転が起きます。Strix Halo で 8〜12 tok/sec 出るのは MoE 構造のおかげです。
DeepSeek-V3 / Llama 3.1 405B のような 300GB 超のモデルは 96GB に収まらないため、Strix Halo では動きません。ここは Mac Studio M3 Ultra 512GB だけが対応できる領域です。
消費電力:「120W で 70B が動く」は本当か
Strix Halo の魅力は速度ではなく 省電力性 です。実測値で確認します。
| 機材 | アイドル | 70B 推論中(システム) | dGPU 単体時 |
|---|---|---|---|
| RTX 5090 + Ryzen 9 9950X3D | 80〜100W | 600〜700W | 575W(GPU TGP) |
| Mac Studio M3 Ultra | 20〜30W | 140〜180W | - |
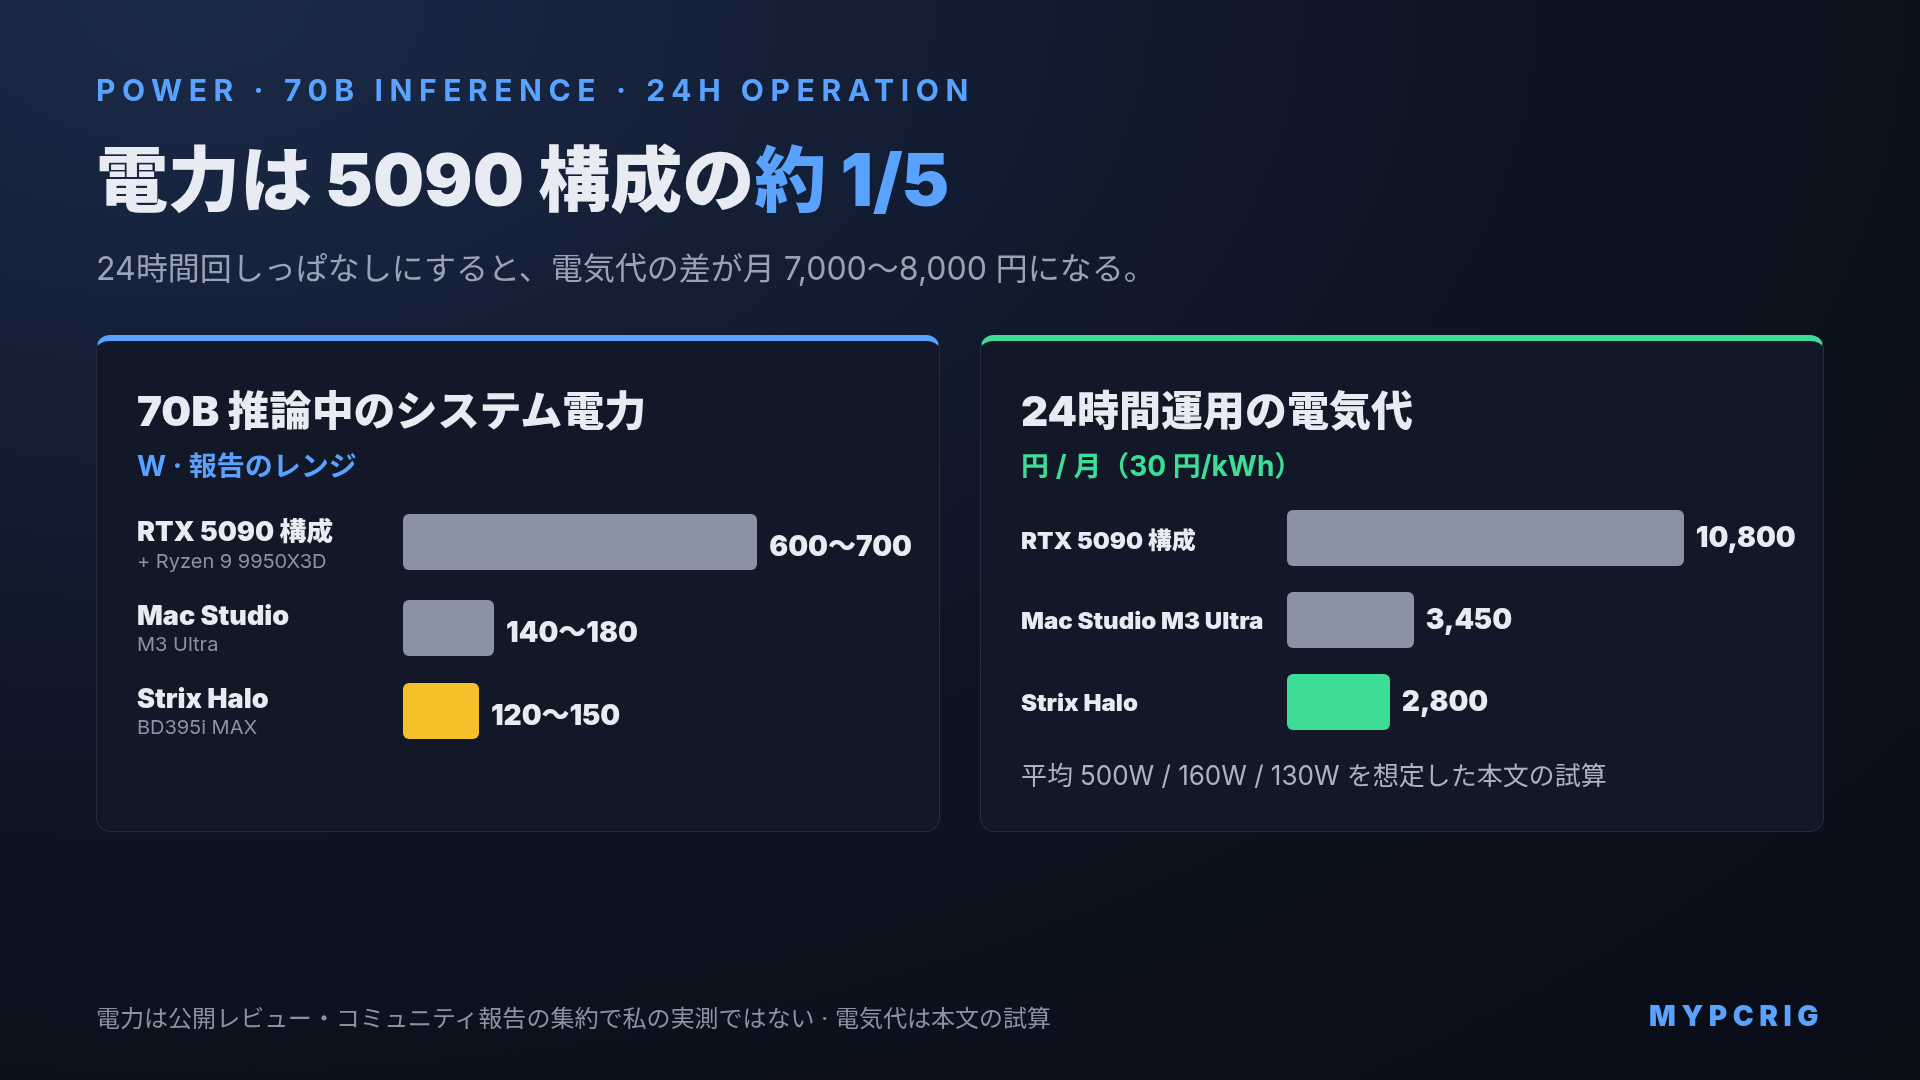
| BD395i MAX(Strix Halo) | 15〜25W | 120〜150W | - |
Strix Halo は 70B 推論を行いながらシステム全体で 120〜150W。RTX 5090 構成(600〜700W)の約 1/5 です。Mac Studio M3 Ultra と同水準で、ファンレスに近い静音性が実現できます。
「24 時間 LLM を回しっぱなしにする」ような用途では、電気代の差が露骨に効きます。日本の電力料金(30 円 /kWh 換算)で 1 日 24 時間運用した場合:
- RTX 5090 構成(平均 500W 想定):360 円 / 日 = 10,800 円 / 月
- Strix Halo 構成(平均 130W 想定):93 円 / 日 = 2,800 円 / 月
- Mac Studio M3 Ultra(平均 160W 想定):115 円 / 日 = 3,450 円 / 月
GPU 価格差以外に 月 7,000〜8,000 円の電気代差 が発生します。3 年で 25 万円。Strix Halo / Mac の TCO 優位性はここに集約されます。
バックエンド別の差:ROCm / Vulkan / Windows
同じ Strix Halo でも、バックエンドで tok/sec が大きく変わります。
| 構成 | tg tok/sec(70B Q4_K_M) | 補足 |
|---|---|---|
| Linux + ROCm | 5〜8 前後(Vulkan とほぼ同じ) | 生成は Vulkan と同等か下回る。長い入力の prefill は Vulkan より速い。セットアップ難度高 |
| Linux + Vulkan(llama.cpp 標準) | 5〜8 | 安定動作、セットアップ容易、本記事の主軸 |
| Windows + Vulkan | 4〜6 | ドライバ次第で不安定、推奨しない |
| Windows + DirectML | 3〜5 | 最も遅い、選ぶ理由なし |
ROCm は AMD 公式の CUDA 相当 API ですが、Strix Halo(RDNA 3.5 iGPU)への正式対応は 2026 年 Q1 にようやく整い始めたところで、セットアップで詰まる事例が多数報告されています。「動くまでに半日〜1 日かかる」のが現実 です。
Vulkan バックエンドは llama.cpp 標準で、Ubuntu 24.04 + Mesa ドライバの組み合わせで素直に動きます。Strix Halo を「とりあえず動かす」なら Linux + Vulkan が最短ルートです。
どちらが速いかは処理で分かれます。公開ベンチでは、長い入力の prompt processing(pp16384)は ROCm(HIP)が Vulkan より 41〜48% 速く、token generation(tg128)は Vulkan が 5〜19% 速いという結果です(nabe2030/hip-vs-vulkan-evo-x2、2026 年 4 月、ROCm 7.2.2、26B〜122B の 6 モデル)。長いプロンプトを流し込む RAG や要約なら ROCm、短い指示で長く生成するチャットやコーディングなら Vulkan、という使い分けになります。詳しくは「Strix Halo Vulkan vs ROCm llama.cpp ベンチマーク 2026 年版」で扱っています。
モデルロード時間とコンテキスト長の影響
実用時に効く 2 つの数値も押さえておきます。
モデルロード時間(70B Q4_K_M、約 40GB)
- RTX 5090:SSD → VRAM 約 5〜8 秒(PCIe Gen5 x16 経由)
- Mac Studio M3 Ultra:SSD → Unified Memory 約 4〜7 秒
- Strix Halo:SSD → 共有メモリ 約 6〜10 秒
Strix Halo は NVIDIA と違って PCIe コピーが存在しない(CPU と GPU で同じメモリプール)ため、ロード後の応答開始は素直です。
コンテキスト長と速度低下
短文プロンプト基準のベンチ値から、長文ではどの程度落ちるか:
| コンテキスト | 速度の目安(対 4K 比) |
|---|---|
| 4K | 100%(基準) |
| 32K | 50〜60% |
| 128K | 25〜35%(VRAM 割当 80GB+ が前提) |
Strix Halo は帯域が狭いぶん、KV キャッシュが膨らむ長文で速度が落ちやすい傾向があります。128K コンテキストで本気で運用するなら、現状は Mac Studio M3 Ultra のほうが向いています。
「動く」と「速い」は別の話:用途別の現実解
数値が出揃ったところで、用途別の判断軸を整理します。
| 用途 | 現実解 |
|---|---|
| 70B Q4 を最速で回したい | RTX 5090 ×2(公開ベンチで 25〜35 tok/sec) |
| 70B Q8 を 1 機で動かしたい | RTX PRO 6000 / Mac Studio M3 Ultra / Strix Halo |
| 70B / 120B を省電力で 24h 回したい | Strix Halo(120W、3,000 円 / 月) |
| 128K 巨大コンテキスト | Mac Studio M3 Ultra の大容量構成 |
| 300GB 超のモデル(DeepSeek-V3) | Mac Studio M3 Ultra 512GB |
| 法人 API 代替・並列リクエスト | RTX PRO 6000 + vLLM |
Strix Halo の独自ポジションは 「70B / 120B が動く + システム 130W で済む + x86/Linux 開発環境」 の 3 点セットです。Mac Studio で Linux ネイティブ環境が必要な開発者にとって、Strix Halo は初めて選べる x86 の選択肢になります。
Strix Halo を買うべきでないケース
逆に Strix Halo を選ぶべきでない用途も明確です。
- 推論速度を最優先:5〜8 tok/sec が体感で遅いなら RTX 5090 の 2 枚構成にする(70B Q4 は 1 枚の 32GB に収まらない)。ChatGPT 並みの応答(20〜30 tok/sec)を求めるなら帯域差は埋まらない
- 学習・ファインチューニング:ROCm の学習ワークフローはまだ未成熟。学習を視野に入れるなら RTX 5090 / PRO 6000 + CUDA
- 頻繁な GPU 換装:Strix Halo は iGPU 固定。BD395i MAX なら PCIe x16 スロットで外付け GPU 追加は可能ですが、ハイブリッド構成の最適化は手間
- 128K context のフル運用:帯域不足で速度が大幅低下。Mac Studio M3 Ultra のほうが安定
これらに当てはまるなら、Strix Halo より素直に RTX 5090 か Mac Studio を選んだほうが幸せです。
まとめ:Strix Halo は「Linux で 70B が動く 130W 機」
Strix Halo の本質を 1 行で言うなら 「Linux ネイティブで 70B が動く 130W のミニPC SoC」 です。RTX 5090 のスピードも、Mac Studio M3 Ultra の超巨大モデル対応もありませんが、その代わり省電力・静音・x86 開発環境という独自軸を持ちます。
実機の入手性も 2026 年 5 月時点で MS-S1 Max / EVO-X2 が出揃いました(BD395i MAX は 2026 年 11 月時点でも MINISFORUM の公式ストアに掲載がなく未発売です)。価格はその後値上がりし、2026 年 11 月時点の日本公式ストアで 128GB 構成が GMKtec EVO-X2 ¥566,999〜、MS-S1 Max ¥691,999 です。Mac Studio M3 Ultra(初版時点の目安で 80〜95 万円。2026 年 8 月に M5 Max / M5 Ultra へ切り替わって Apple 公式では販売終了し、現行の M5 Ultra は ¥949,800〜、Apple 公式、2026 年 11 月時点)より安く 96GB VRAM 級のローカル LLM 環境が組める点は残りますが、以前のような半額以下の差ではなくなりました。
ミニPC として Strix Halo を含めた全体像は「ミニPC / SFF(小型)PC 選び方ガイド 2026年版:Strix Halo / Ryzen AI MAX+ 395 でローカルLLM が動く時代」で扱っています。NVIDIA / Mac 側の Llama 3.3 70B ベンチ詳細は「Llama 3.3 70B GPU別トークン/秒 2026年版(5090 / PRO 6000 / Mac)」と「Mac Studio M3 Ultra vs RTX 5090 ローカルLLM ベンチマーク 2026年版」を併読すると、3 軸(NVIDIA / Mac / Strix Halo)の立体像が揃います。
AMD 側の LLM 用 GPU として単体カードの Radeon AI PRO R9700 32GB はローカルLLMで買いか 2026年版 も併読すると、「Strix Halo(帯域は狭いが 96GB VRAM)」と「R9700(32GB だが専用 GPU 帯域)」の使い分けが立体的に見えます。機種選定の粒度で読みたい方は Strix Halo ミニPC 比較 2026 と Strix Halo は完成品ミニPCと自作ITX、どちらで組むか 2026年版 を続けて読むと、EVO-X2 / MS-S1 Max / BD395i MAX / GTR9 Pro / AI BOX-A395 の実装差まで揃います。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
Ryzen AI MAX+ 395(Strix Halo)搭載ミニPC / 比較対象
- Ryzen AI MAX+ 395 搭載ミニPC(128GB)を Amazon.co.jp で探す
- MINISFORUM MS-S1 MAX(Ryzen AI Max+ 395 / 128GB)を Amazon.co.jp で見る
価格の注記(2026 年 8 月実測): Amazon.co.jp の RTX 5090 単体は第三者出品者によるマーケットプレイス出品が中心で、上位掲載の実売価格は 86〜90 万円台でした(ASUS TUF / ROG Astral、出品者 B&T)。PC 専門店やメーカー直販の価格も確認してから判断してください。
BD395i MAX ベアボード基板、AOOSTAR AI BOX-A395、Beelink GTR9 Pro、Framework Desktop など個別型番は現状 Amazon.co.jp で単独ページが安定していないため、Ryzen AI MAX+ 395 搭載機の汎用検索に集約しています。Framework Desktop は公式サイト(frame.work/jp/ja/desktop)でも直販されます。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- ミニPC / SFF(小型)PC 選び方ガイド 2026年版:Strix Halo / Ryzen AI MAX+ 395 でローカルLLM が動く時代
- Llama 3.3 70B GPU別トークン/秒 2026年版(5090 / PRO 6000 / Mac)
- Apple Silicon の Unified Memory と NVIDIA VRAM、ローカルLLM では何が違うのか 2026年版
- Ryzen AI MAX+ 395(Strix Halo)vs Mac Studio M4 Max 直接比較 2026年版
- AMD Unified Memory とは:Strix Halo の仕組み 2026年版
よくある質問
- strix llm とは?Strix Halo の正体と Ryzen AI MAX+ 395 との関係は?
- Strix Halo は AMD の APU コードネームで、製品名は Ryzen AI MAX+ 395、同じ SoC を指す呼称違いです。Zen 5 CPU 16 コアと Radeon 8060S iGPU(RDNA 3.5、40 CU)、LPDDR5X-8000 を 256-bit 幅で組み合わせ、BIOS 設定で iGPU に最大 96GB を VRAM として割り当てられる初の x86 SoC です。これにより Llama 3.3 70B / 120B クラスを単体でロードして動かせるようになりました。
- Ryzen AI MAX+ 395 のユニファイドメモリは Mac と何が違いますか?
- ハード面はどちらも CPU と GPU が同じメモリプールを共有する構造で、Strix Halo は 128GB LPDDR5X-8000 を UMA/GTT で iGPU に最大 96GB 割当、帯域 256GB/s です。Mac Studio M3 Ultra は 512GB まで Unified で、帯域 819GB/s と約 3.2 倍。ソフト面では Mac が MLX / Metal / Xcode 統合、Strix Halo が ROCm / Vulkan / x86 Linux ネイティブという違いがあり、x86 Linux の開発環境を保ったまま 70B〜120B を単体ロードできるのは Strix Halo だけです。
- ユニファイドメモリ 128GB でローカルLLM は何ができる?
- 128GB ユニファイド構成の Strix Halo で iGPU に 96GB を VRAM 割当した場合、Llama 3.3 70B Q4_K_M が 5〜8 tok/sec、Q8 で 3〜5 tok/sec、Mixtral 8x22B(141B MoE)の量子化版も 8〜12 tok/sec で単体ロードできます。しかもシステム消費電力 130W 前後。70B〜120B クラスを 1 機で、x86 Linux ネイティブで、130W の省電力で動かせる組み合わせは他にありません。DeepSeek-V3(約 380GB)のような 300GB 超モデルは 96GB に収まらないため動きません。
- ai max 395+ vs mac studio、ローカルLLM ならどちらが速い?
- 生成速度は Mac Studio M3 Ultra のほうが約 2 倍速く、Llama 3.3 70B Q4_K_M で Strix Halo が 5〜8 tok/sec、Mac Studio M3 Ultra が 12〜18 tok/sec です。価格は Strix Halo の 128GB 完成品が値上がりし、2026年11月時点の日本公式ストアで GMKtec EVO-X2 ¥566,999〜、MS-S1 Max ¥691,999 です。Mac Studio M3 Ultra(初版時点の目安で 80〜95 万円。2026 年 8 月に M5 Max / M5 Ultra へ切り替わって Apple 公式では販売終了し、現行の M5 Ultra は ¥949,800〜、Apple 公式、2026 年 11 月時点)より安いものの、以前のような半額以下ではなく、M5 Ultra の約 6〜7 割です。消費電力は Strix Halo 130W 対 Mac 160〜180W。速さ最優先なら Mac、より安く・省電力で 70B / 120B を動かしたいなら Strix Halo、という住み分けになります。
- Ryzen AI MAX+ 395(Strix Halo)で Llama 3.3 70B はどれくらいの速度で動く?
- 96GB VRAM 割当時で Llama 3.3 70B Q4_K_M が 5〜8 tok/sec、Q8 で 3〜5 tok/sec が現実線です。速度は RTX 5090 2 枚構成(公開ベンチで 25〜35 tok/sec)の 1/4〜1/6、Mac Studio M3 Ultra の半分程度です。RTX 5090 1 枚では 70B Q4_K_M(約40〜43GB)が 32GB に収まりません。速さを最優先するなら 5090 の 2 枚構成、容量と省電力を取るなら Strix Halo という住み分けになります。
- Strix Halo で 120B クラスのモデルは動く?
- 動きます。70B / 120B クラスを単体でロードでき、しかもシステム消費電力 130W 前後で動く、という組み合わせは Mac Studio M3 Ultra と Strix Halo にしかない独自性です。容量で勝負するなら Strix Halo か Mac の二択になります。
- ローカルLLM 用途で Strix Halo と RTX 5090 / Mac Studio のどれを選ぶべき?
- 70B を速さ最優先で回すなら RTX 5090 の 2 枚構成(1 枚の 32GB には 70B Q4 が収まりません)、容量と省電力(130W 前後で 70B/120B 単体ロード)を取るなら Strix Halo、速さと容量の両取りなら Mac Studio M3 Ultra、という三択です。Strix Halo は「速いGPU」ではなく「大容量を省電力で回せるGPU」と理解するのが正確です。
- MINISFORUM BD395i MAX と MS-S1 Max、GMKtec EVO-X2 はどう違いますか?
- BD395i MAX は MINISFORUM のベアボード基板(自作 ITX 向け)、MS-S1 Max は同基板を採用した同社の完成機、GMKtec EVO-X2 は GMKtec 社の完成機です。いずれも AMD Ryzen AI MAX+ 395(Strix Halo)を搭載し、96GB VRAM 割当時に Q4_K_M で 5〜8 tok/sec、システム消費電力 120〜150W、という基幹スペックを共有します。価格帯は 30〜40 万円で、CES 2026 で一斉発表されたラインナップです。
- Strix Halo(Ryzen AI MAX+ 395)は何が特別ですか?
- iGPU に最大 96GB を VRAM として割り当てられる初の x86 SoC である点です。70B / 120B クラスを単体でロードできて、システム消費電力 130W 前後で動き、x86/Linux ネイティブ開発環境で回せる、という 3 点セットを同時に持ちます。Mac Studio M3 Ultra や RTX 5090 では成立しない組み合わせで、価格は値上がりし、128GB 構成が 2026 年 11 月時点の日本公式ストアで GMKtec EVO-X2 ¥566,999〜、MS-S1 Max ¥691,999 と、以前の「Mac Studio M3 Ultra の半額以下」ではなくなりました。現行の Mac Studio M5 Ultra(¥949,800〜、Apple 公式、2026 年 11 月時点)と比べると約 6〜7 割の価格です。
- Ryzen AI MAX+ 395 の LLM ベンチマークは他の GPU と比べて速いですか?
- 単純な生成速度(tg tok/sec)では速くありません。Llama 3.3 70B Q4_K_M で 5〜8 tok/sec、これは RTX 5090 2 枚構成の 25〜35 tok/sec(公開ベンチ)に対して 1/4〜1/6、Mac Studio M3 Ultra の 12〜18 tok/sec に対して半分程度です。ただし 130W で 70B / 120B を単体ロードできる独自性は他 GPU に無く、速さより容量・省電力を優先する運用では代替のない選択肢になります。