ローカルLLM prefill 高速化 3 手法 比較 2026 年版:chunked prefill / prefix caching / Flash Attention の効くケースと使い分け
ローカルLLM の prefill(プロンプト処理)を速くする 3 手法 chunked prefill / prefix caching / Flash Attention を、vLLM / SGLang / llama.cpp / Ollama の実装状況・効くケース・落とし穴で整理します。長文エージェントで TTFT を縮める判断フローと、3 手法の組み合わせ順序を 2026 年版で示します。
- #ローカルLLM
- #prefill
- #chunked prefill
- #prefix caching
- #Flash Attention
- #vLLM
- #SGLang
- #llama.cpp
- #TTFT
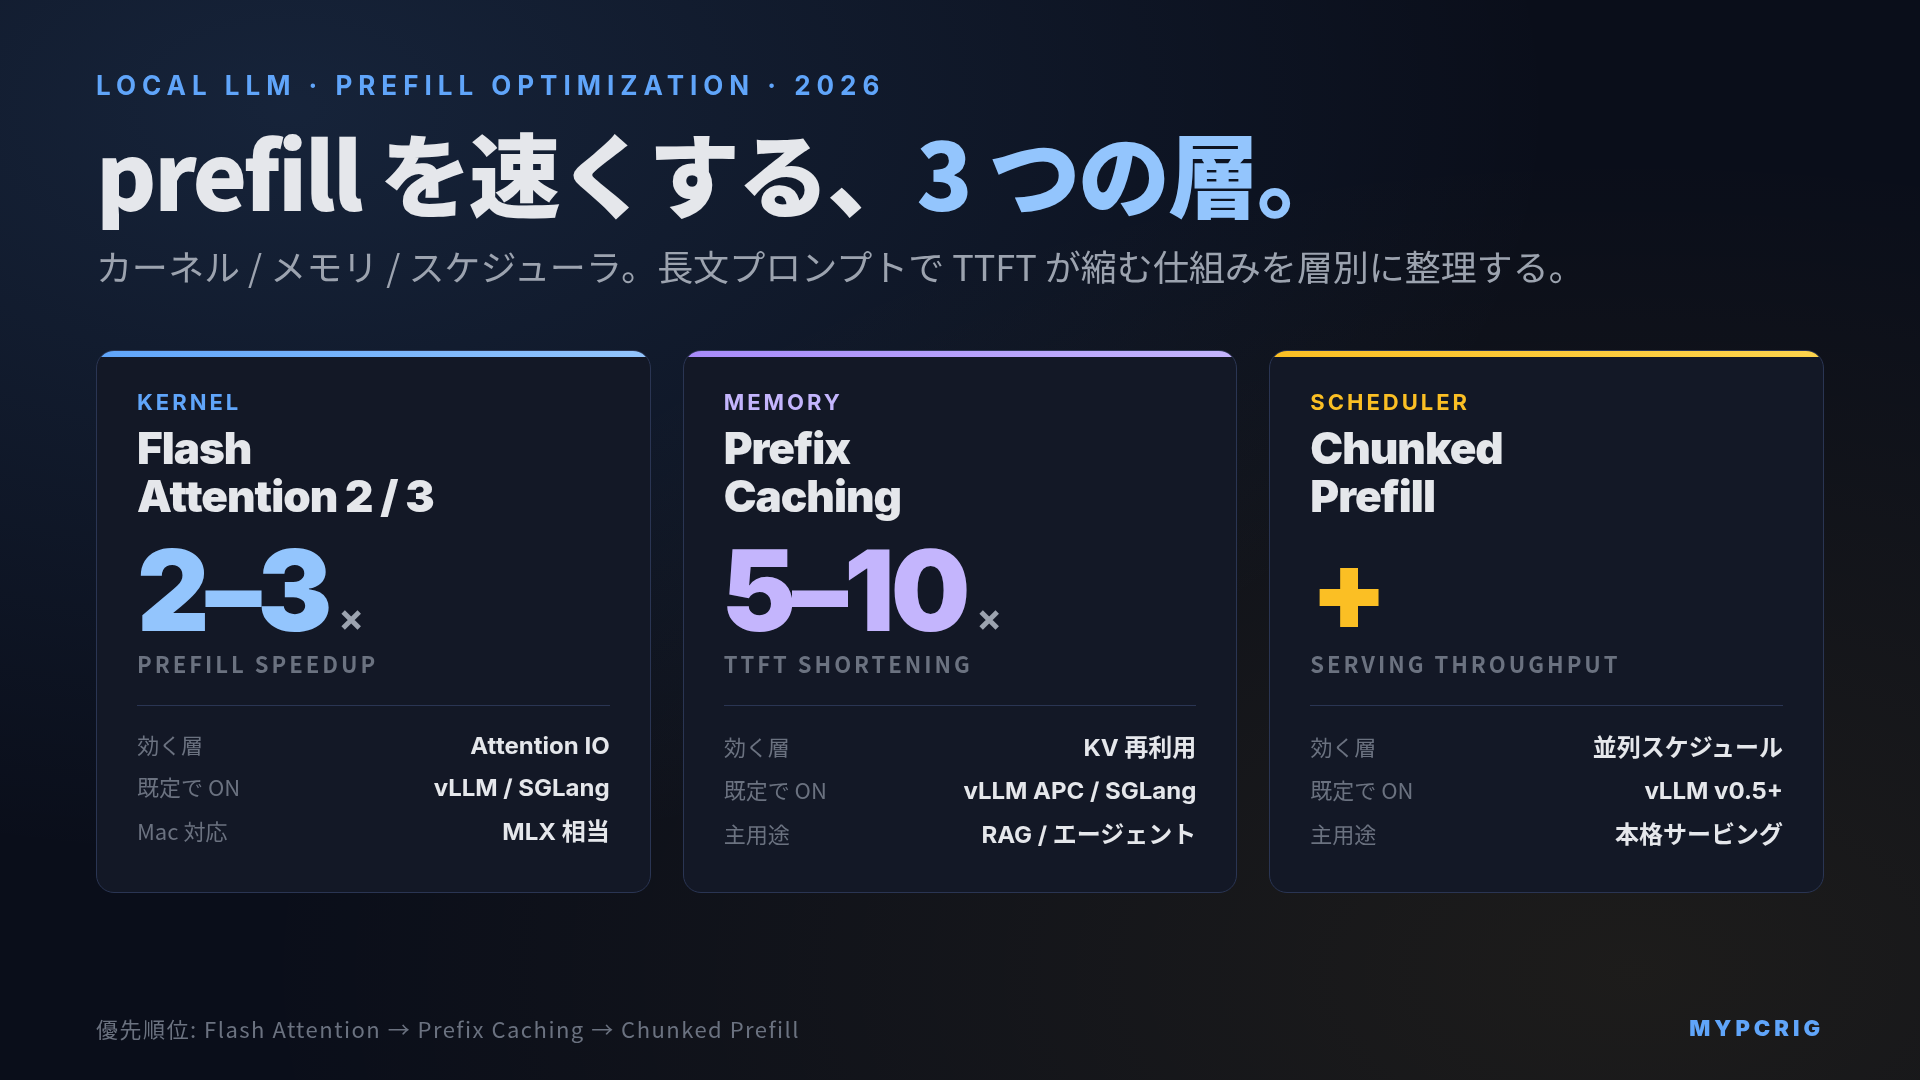
結論:ローカルLLM の prefill(プロンプト処理)を速くする手段は、2026 年時点で 3 つに大別できます。Flash Attention 2 / 3 はカーネル層でメモリ IO を削減する手法で、GPU で動かすならほぼ常時有効化して良い基礎技術です。prefix caching は同じプロンプト先頭を 2 回目以降に投げたときに KV キャッシュを使い回す再利用技術で、RAG とエージェントで TTFT が 5〜10 倍短縮します。chunked prefill は長い prefill を細切れにして decode と並行させるスケジューリング技術で、同時接続が増える本格サービングで実効スループットが伸びます。3 手法は層が違うので併用できます。優先順位は Flash Attention → prefix caching → chunked prefill の順です。
ローカルLLM の体感速度を決めるのは decode(生成)の tok/sec だけではなく、prefill(プロンプト処理)の速度と TTFT(Time To First Token)です。入力が 8K トークンを超えてくる長文・エージェント・RAG 用途では、prefill が体感時間の大半を占めるようになります。この prefill を速くする手段として、2026 年に主要エンジン全てで実装が揃った 3 つの技術を取り上げ、「仕組み」「どのエンジンで有効か」「効くケース・効かないケース」「組み合わせ順序」で整理します。
prefill と decode の 2 フェーズの違いが未整理の場合は「LLM Prefill / Decode の違い 2026 年版」を先に読むと、本記事の背景がつかめます。GPU 別の prefill 速度の公開ベンチマーク結果は「ローカルLLM prefill(プロンプト処理)速度 GPU別ベンチマーク 2026 年版」にまとめてあります。
3 手法の層別マップ
prefill を速くする 3 手法は、効いている層が完全に別です。先に全体像を押さえます。
| 層 | 手法 | 何を速くするか | 効くワークロード |
|---|---|---|---|
| カーネル(演算) | Flash Attention 2 / 3 | Attention 計算の HBM IO 削減 | 長文プロンプト全般、学習・推論どちらも |
| メモリ(再利用) | Prefix Caching | 共通プレフィックスの KV キャッシュ再利用 | RAG、エージェント、マルチターンチャット |
| スケジューラ(並列化) | Chunked Prefill | 長い prefill を細切れにして decode と並行実行 | 本格サービング、同時接続が多い環境 |
- Flash Attention は「同じ計算を速くする」(近似なし、数式等価)
- Prefix Caching は「過去と同じ計算をスキップする」(2 回目以降が速い)
- Chunked Prefill は「他のリクエストを待たせない」(スループットが伸びる)
目的が別です。3 つを重ねて併用できます。vLLM の既定構成では Flash Attention + Prefix Caching + Chunked Prefill の 3 つが同時に効いています。
手法 1: Flash Attention 2 / 3(カーネル層)
仕組み
標準の Attention は、シーケンス長 N に対して Q × K^T の N×N 行列を GPU の HBM(VRAM)に書き戻し、32K トークンなら 10 億要素、128K トークンなら 164 億要素のサイズになり、HBM と演算器の間の往復がボトルネックになります。
Flash Attention(Tri Dao et al., 2022)はこの中間行列を HBM に書き戻さず、GPU 上の SRAM(on-chip cache)でタイル分割して処理します。IO 量が N の 2 乗から N の 1 乗に落ちるため、長文プロンプトで実効速度が数倍伸びます。演算量(FLOPs)自体は変わりませんが、GPU はメモリ帯域律速です。ここが効きます。
- 出典: Flash Attention 論文(Tri Dao et al.)arxiv.org/abs/2205.14135
世代別対応
| 世代 | GPU 例 | FA2 | FA3 | FP8 Attention |
|---|---|---|---|---|
| Ampere | A100 / RTX 3090 | ○ | - | - |
| Ada | RTX 4090 / L40S | ○ | - | - |
| Hopper | H100 / H200 | ○ | ○ | FP8 一部 |
| Blackwell | B200 / RTX 5090 / RTX PRO 6000 | ○ | ○ | ○ |
FA3 は Hopper 以降の TMA / WGMMA / warp specialization という新命令を使います。Ampere / Ada では動きません。Blackwell では FP8 Attention に対応し、FA3 の FP16 比で追加 2 倍近い高速化が入ります。
- 出典: FlashAttention-3 blog tridao.me/blog/2024/flash3
効くエンジン
- vLLM: 既定で FA2、v0.6 以降は FA3 と PagedAttention 併用も選べる
- SGLang: 既定で Flash Attention 系バックエンド
- TGI(Hugging Face): 既定で Continuous Batching + Flash Attention
- llama.cpp:
-faフラグで FA2 相当を有効化(CPU-only では無効) - PyTorch SDPA:
torch.nn.functional.scaled_dot_product_attentionが内部で FA2 を呼ぶ - MLX(Apple Silicon): 独自の memory-efficient attention 実装、CUDA FA は動かない
実装詳細は「Flash Attention 2 / 3 とは 2026 年版」で解説しています。
落とし穴
- CPU-only 推論では効かない: SRAM の構造が無いので原理的に動きません
- 短文単発では効果が小さい: 1K トークン以下の単発チャットではカーネル呼び出しのオーバーヘッドが上回るケースがあります
- GPU offload レイヤーが少ない場合: llama.cpp で数レイヤーだけ GPU に載せる構成では、CPU と GPU の往復で逆効果になる場合があります
手法 2: Prefix Caching(メモリ層)
仕組み
Prefix Caching は、同じプロンプト先頭(システムプロンプト / RAG の検索結果 / 共通コンテキストなど)を 2 回目以降に受け取ったときに、既存の KV キャッシュを再利用します。prefill 自体をスキップする仕組みです。
- 受け取ったトークン列の先頭から共通プレフィックスを hash で検出する
- ハッシュ一致する KV キャッシュがメモリに残っていれば、その先の差分トークン列だけ prefill する
- decode に移行してトークン生成を開始する
decode の tok/sec そのものは変化しません。影響するのは TTFT(最初のトークンまでの秒数)と、prefill 時間が全体を支配するワークロードでの実効スループットです。
- 出典: SGLang / RadixAttention 論文(NeurIPS 2024)arxiv.org/abs/2312.07104
- 出典: vLLM Automatic Prefix Caching ドキュメント docs.vllm.ai/en/latest/features/automatic_prefix_caching.html
効くエンジン
| エンジン | 実装名 | 既定で有効か |
|---|---|---|
| vLLM | Automatic Prefix Caching(APC) | V1 以降 既定 ON(V0 系は --enable-prefix-caching) |
| SGLang | RadixAttention(ツリー構造) | 既定 ON |
| TGI | prefix caching | v3.0 以降 標準サポート |
| llama.cpp | --prompt-cache / --prompt-cache-all | オプトイン |
| Ollama | context reuse | 既定 ON |
| TensorRT-LLM | KV cache reuse | 設定で有効化 |
SGLang の RadixAttention はツリー構造で部分一致まで再利用できるのが特徴で、プレフィックス支配ワークロードの公開ベンチでは vLLM APC より実効スループットが高いと報告されています。
効くワークロード
| ワークロード | 共通プレフィックス比率 | 効果 |
|---|---|---|
| RAG(長システムプロンプト + 検索結果) | 高(50〜90%) | 2 回目以降 TTFT が 5〜10 倍短縮 |
| エージェント(ツール履歴の積み重ね) | 高(70〜95%) | ターンごとの TTFT を大幅短縮 |
| マルチターンチャット | 中(50〜80%) | 2 ターン目以降が高速化 |
| コード補完(IDE 内)の重複接頭辞 | 高(80%+) | レイテンシを体感で半減 |
| 単発プロンプトを使い捨てる用途 | 低 | 効果なし |
公開ベンチでは、SGLang の RAG サービングで RadixAttention 有効時に 2〜3.5 倍のスループット向上、vLLM APC では TTFT が 1 回目比 5〜10 倍短縮されたと報告されており、詳細は「ローカルLLM Prefix Caching ベンチ 2026」でまとめています。
VRAM コストの見積り
キャッシュサイズは次の式で見積れます。
cache_bytes = prefix_tokens × 2(K+V) × layers × hidden × bytes_per_elemLlama 3.3 70B で 4K トークンの prefix を FP16 でキャッシュする場合、同構造を仮想 MHA 換算すると約 10GB、GQA 補正後(KV ヘッド数が query ヘッドの 1/8)で約 1.3GB。KV キャッシュ量子化(Q8 / Q4)を併用すれば半分〜4 分の 1 に抑えられます。
落とし穴
- プレフィックスが毎回違うと効かない: ランダム生成されるプロンプトや、session_id を prefix 先頭に埋め込んでいる実装では、ハッシュ一致せずキャッシュが使えません
- VRAM との天秤: キャッシュしたい prefix の数と長さだけ VRAM が食われます。多テナント運用では「どのプレフィックスを残すか」の LRU 設計が必要です
- 動的フィールドの位置: 「システムプロンプト + ユーザー質問 + 検索結果」の順番で検索結果が末尾なら共通化しやすく、検索結果がプロンプト先頭にあると全く効きません
手法 3: Chunked Prefill(スケジューラ層)
仕組み
Chunked Prefill は、1 本の長い prefill 処理を複数の小さなチャンク(例: 1024 トークン単位)に分割し、各チャンクの合間に他のリクエストの decode トークンを挟み込みます。スケジューリング技術です。
従来のスケジューラは「prefill が走っている間は decode を止める」設計でした。32K トークンの prefill に 5 秒かかる場合、その 5 秒間は他のユーザーの生成が完全にストールしていました。chunked prefill では、prefill を 1K トークンずつのチャンクに分けます。チャンクの合間に decode を 1 ステップずつ挟み込むため、他のリクエストのストールが大幅に小さくなります。
- 出典: vLLM chunked prefill ドキュメント docs.vllm.ai/en/latest/features/scheduling_policies.html
- 出典: Sarathi-Serve 論文(OSDI 2024)arxiv.org/abs/2403.02310
効くエンジン
| エンジン | 実装名 | 対応時期 |
|---|---|---|
| vLLM | chunked prefill | V0 系はモデルにより条件付き、V1 以降は常時 ON |
| SGLang | chunked prefill | v0.3 以降 対応 |
| TensorRT-LLM | chunked context | v0.8 で導入、v0.9 で KV cache reuse と統合 |
| TGI | chunked prefill | v2.4 で試験的サポート、v3.0 以降 標準 |
個人向けの Ollama と llama.cpp は 1 並列運用が基本なので、chunked prefill の恩恵は実用上ほぼありません。
効くワークロード
- 同時接続数が多い本格サービング: 社内 API で複数人が長文プロンプトを投げる場面
- 並列エージェントの実行: ツール呼び出しを並列に走らせる構成
- 夜間バッチ推論: 数百〜数千件のプロンプトを一気に流す運用
- TTFT と inter-token latency の両立: 長文の TTFT を許容しつつ、他リクエストの decode 遅延を小さくしたい場合
落とし穴
- 単一リクエストの prefill 自体は速くならない: chunked prefill は全体スループットを上げる仕組みで、1 本のリクエストの TTFT は chunk 分割のオーバーヘッドでわずかに悪化する場合があります
- チャンクサイズの調整: チャンクを小さくすると他リクエストのストールが減りますが、同時に Attention 計算の効率が落ちます。vLLM の既定値(512〜2048 トークン)は多くの環境で妥当です
- 個人利用では差を感じない: 1 人でチャットするだけなら prefill が走っている間に他の処理が走る必要が無いため、効果はほぼ出ません
3 手法の実行エンジン対応マトリクス
| エンジン | Flash Attention | Prefix Caching | Chunked Prefill | 想定用途 |
|---|---|---|---|---|
| vLLM | FA2 / FA3(既定) | APC(V1 以降 既定 ON) | V1 以降 常時 ON | OpenAI 互換 API、本格サービング |
| SGLang | FA 系(既定) | RadixAttention(既定) | 対応 v0.3+ | プレフィックス支配、マルチテナント |
| TensorRT-LLM | FA2 / FA3 + NVIDIA 最適化 | KV cache reuse | chunked context(v0.8+) | NVIDIA 本番、最高スループット |
| TGI(HF) | FA 系(既定) | 対応 v3.0+ | 試験的 v2.4+ / 標準 v3.0+ | Hugging Face エコシステム |
| llama.cpp | -fa(オプトイン) | --prompt-cache | - | 個人、CPU 混在、GGUF |
| Ollama | 内部で -fa 使用 | context reuse(既定) | - | 個人、簡易運用 |
| MLX LM(Mac) | 独自実装 | 対応(prompt cache) | - | Apple Silicon、M シリーズ |
| LM Studio | バックエンドに依存 | バックエンドに依存 | - | 個人 GUI、Mac/Win |
Mac 系のパターン
Apple Silicon では CUDA 実装の Flash Attention が動きませんが、MLX フレームワークが相当機能を提供し、M4 / M5 世代では Neural Accelerator と組み合わせて prefill 性能を大きく伸ばしており、M4 比で M5 は最大 4 倍の高速化が公表されています。prefix caching は MLX LM の prompt cache / Ollama / llama.cpp のいずれでも使えます。詳細は「Apple M5 ローカルLLM ベンチマーク 2026」を参照してください。
効くケース・効かないケースを横並びで
実務ワークロード別に、3 手法のどれが効くかを一覧化します。
| ワークロード | Flash Attention | Prefix Caching | Chunked Prefill |
|---|---|---|---|
| 短文単発チャット(1K 以下) | △(微差) | ×(効果なし) | ×(効果なし) |
| 長文単発プロンプト(32K+) | ◎ | × | △ |
| マルチターンチャット | ○ | ◎ | ○ |
| RAG サービング | ◎ | ◎ | ◎ |
| コーディングエージェント | ◎ | ◎ | ○ |
| 社内 API マルチテナント | ◎ | ◎ | ◎ |
| バッチ推論(数百件) | ◎ | △(重複による) | ◎ |
| CPU-only 推論 | ×(動かない) | ○(有効) | - |
パターンとして、prefix caching は「過去のリクエストと重複があるか」、chunked prefill は「同時に動いているリクエストがあるか」で効くかどうかが決まり、Flash Attention は「GPU かつ長文か」のほぼ 2 条件だけで判定できます。
使い分けの判断フロー
- GPU で動かすならまず Flash Attention を有効化。vLLM / SGLang / TGI は既定で ON なので意識不要。llama.cpp は
-faを付ける - プロンプト先頭を使い回す構成なら Prefix Caching を有効化。vLLM の APC、SGLang の RadixAttention は既定、Ollama / llama.cpp は設定で ON にする
- 同時接続数が増える本格サービングに移行するなら Chunked Prefill を考える。vLLM / SGLang / TGI / TensorRT-LLM のどれかに移行した時点で既定で動く
- Mac では MLX フレームワーク上での prefix cache 対応を確認する。CUDA FA は動かないため、M5 世代の Neural Accelerator 対応を優先する
優先順位は Flash Attention → Prefix Caching → Chunked Prefill の順です。Flash Attention は常時有効化。Prefix Caching は構成が合致するなら即座に効果が出ます。Chunked Prefill はサービング段階で初めて価値が立ちます。
3 手法と他の高速化軸の関係
prefill 高速化だけが推論高速化のすべてではありません。他の軸との関係を整理しておきます。
- KV キャッシュ量子化(Q8 / Q4): 長文コンテキストで prefill 後の VRAM を圧縮。Prefix Caching と組み合わせるとキャッシュ可能な prefix 数が増える
- 投機デコード(Speculative Decoding): decode(生成)側の高速化。prefill とは別の軸で、Prefix Caching と直交して併用可能
- モデル量子化(GPTQ / AWQ / GGUF Q4_K_M): prefill と decode の両方を速くする最大のレバー。Flash Attention と組み合わせると prefill がさらに短縮
- Continuous Batching / PagedAttention: スループット側の中核技術。Chunked Prefill と同じ vLLM / SGLang の中核で、既定で有効。詳細は「Continuous Batching / PagedAttention とは 2026 年版」
本記事の数値について
本記事で挙げた高速化倍率(「2〜3 倍」「5〜10 倍」等)は、各エンジンの公式ドキュメント・論文・GitHub Issues に報告された公開ベンチからの集約値であり、独自計測は含みません。GPU 別の prefill 速度と TTFT の公開ベンチ結果は「ローカルLLM prefill(プロンプト処理)速度 GPU別ベンチマーク 2026 年版」にまとめてあります。
まとめ
prefill 高速化の 3 手法は、効いている層が全く別です。Flash Attention はカーネルの演算 IO を削り、Prefix Caching は過去計算の再利用、Chunked Prefill は他リクエストとの並列化です。3 つは重ねて使えます。vLLM / SGLang は既定で全部有効になっています。個人のチャットでは Flash Attention と Prefix Caching で十分。本格サービングに移る段階で Chunked Prefill の価値が立つ、という順序で理解しておけば判断を誤りません。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- prefill を速くする 3 手法を一言で言うと何ですか?
- chunked prefill は長い入力を小さく区切って他のリクエストと並行に捌く「スケジューリング」の工夫、prefix caching は同じプロンプト先頭を 2 回目以降に再送したときに KV キャッシュを使い回す「再利用」の工夫、Flash Attention は Attention 計算の中間行列を VRAM に書き戻さないカーネルレベルの「演算」の工夫です。3 つは効く層が別なので、重ねて併用できます。
- 3 手法のどれを最初に有効化すべきですか?
- Flash Attention(FA2 または FA3)が最優先です。GPU で動かすならほぼ常時有効化して良く、llama.cpp は `-fa` フラグ、vLLM / SGLang / TGI は既定で有効です。長文プロンプトの prefill が 2〜3 倍短縮します。次に prefix caching を有効化すると、同じシステムプロンプトを使う RAG やエージェントで TTFT が 5〜10 倍縮みます。chunked prefill は本格サービング(同時接続が増える場面)で効くため、個人のチャット用途では後回しで構いません。
- chunked prefill と prefix caching は何が違うのですか?
- chunked prefill は 1 本の長い prefill を複数のチャンクに分けて、各チャンクの合間に decode トークンを挟み込むスケジューリング技術です。長文入力中でも生成がストールしません。prefix caching は 2 回目以降のリクエストで共通プレフィックスの KV キャッシュを使い回すメモリ技術です。両者は目的が別なので、本格サービングでは併用されます。
- Apple Silicon(Mac)で 3 手法は使えますか?
- Flash Attention は CUDA 実装なので直接は動きませんが、MLX が同等のメモリ効率的な Attention を提供しており、M4 以降の実効性能では近い水準に達しています。prefix caching はエンジン側(Ollama / llama.cpp / MLX LM)が対応していれば OS を問わず効きます。chunked prefill は vLLM / SGLang 側の機能で、Mac はこれらのサーバーを動かす想定が少ないため実用上は使われません。
- 3 手法を全部有効化すれば単純に速くなりますか?
- ほぼ速くなりますが、2 つ落とし穴があります。1 つ目は VRAM で、prefix caching は共通プレフィックス分の KV キャッシュを保持し続けるため、同時に何個の prefix をキャッシュしたいかで VRAM 予算が決まります。2 つ目は短文単発では効果が出ないことで、プロンプト 1K トークン未満の単発チャットでは 3 手法のオーバーヘッドが上回る場合があります。長文・エージェント・RAG で効き、短文チャットでは微差という理解で十分です。