Radeon AI PRO R9700 単機ベンチ 2026年版:70B は動くか、ROCm と Vulkan はどちらが速いか
AMD Radeon AI PRO R9700 32GB 単機でローカルLLMがどこまで動くかを公開ベンチの集約で検証します。ROCm 7 と Vulkan で 7B・14B・32B・70B Q4 の tok/sec と VRAM 消費、プロンプト処理の速度、70B Q4 のオフロード有無を切り分けました。
- #Radeon AI PRO R9700
- #AMD
- #RDNA 4
- #ローカルLLM
- #ROCm
- #Vulkan
- #llama.cpp
- #ベンチマーク
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
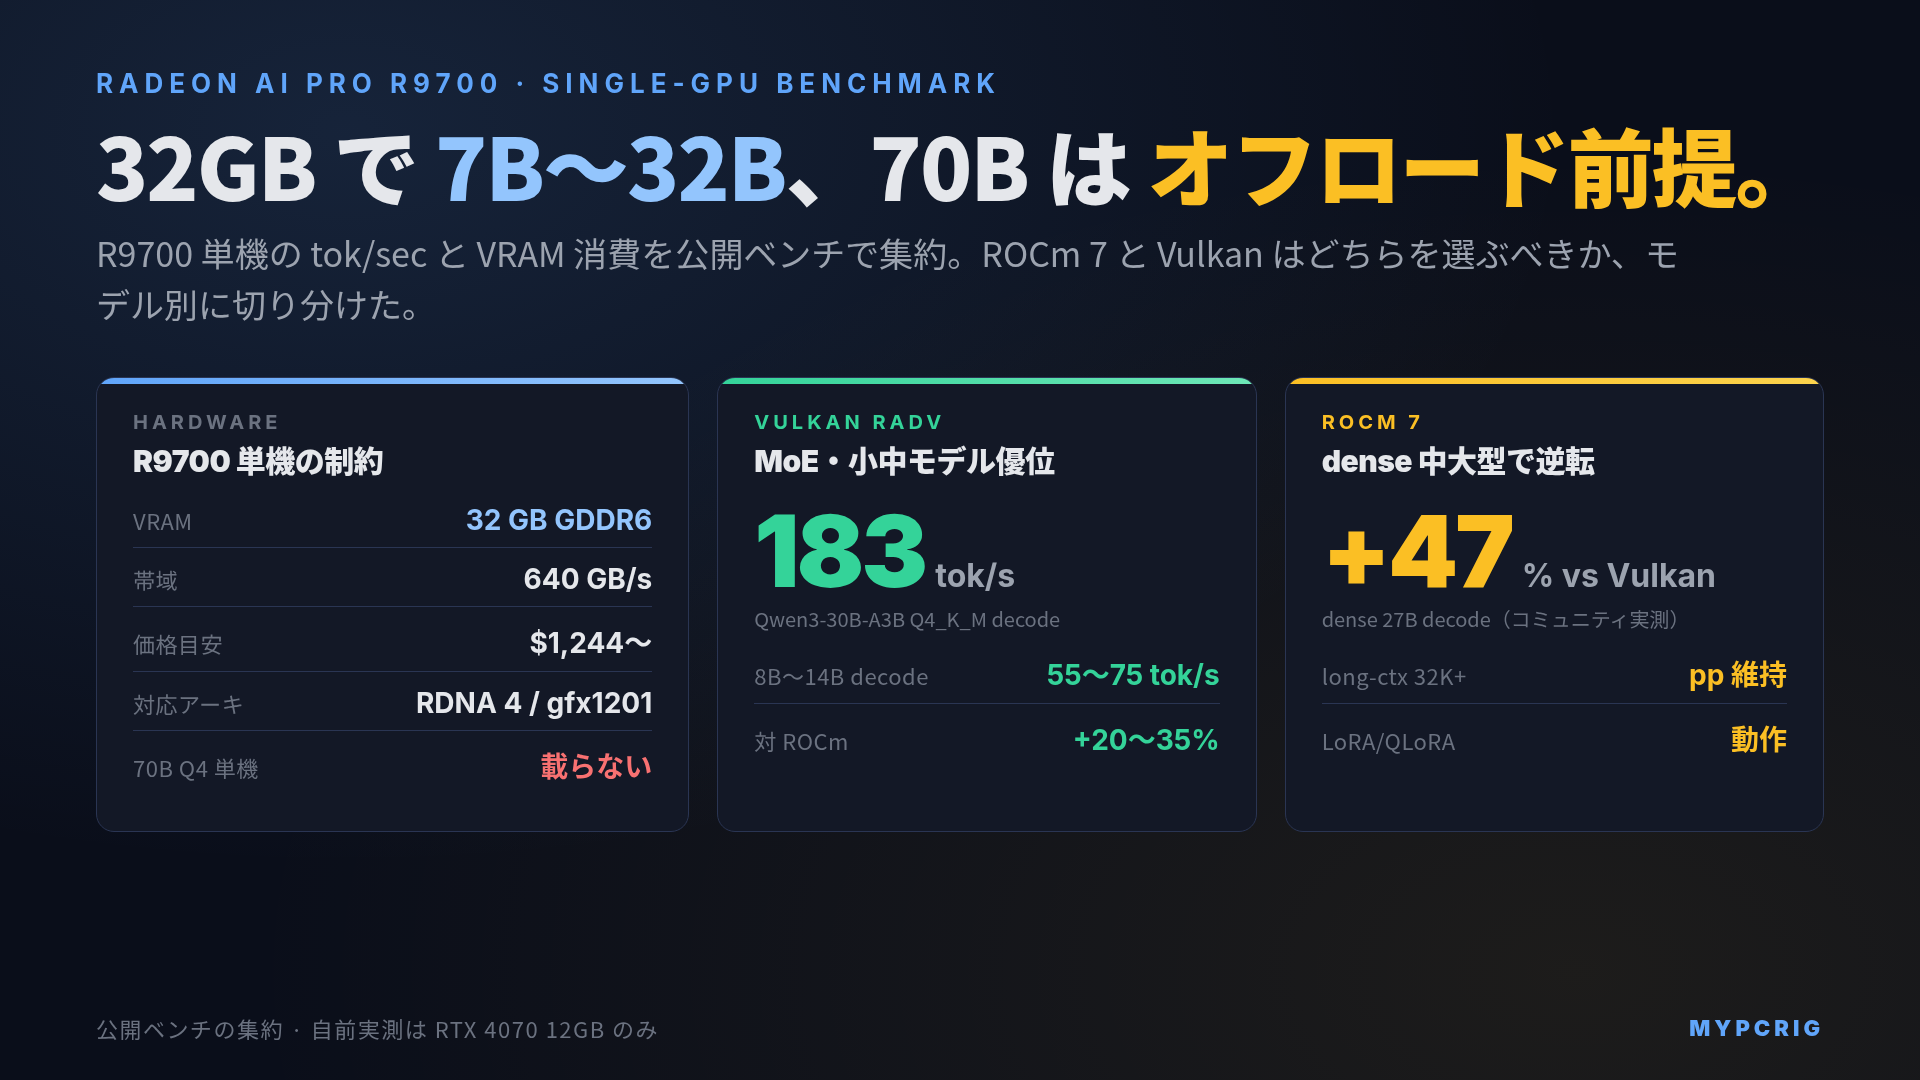
結論:Radeon AI PRO R9700(32GB GDDR6、約640GB/s)単機で現実的に回せるのは 7B〜32B Q4 までです。70B Q4_K_M(約39〜42GB)は VRAM 32GB に収まらず、CPU/RAM オフロードが前提になるため tok/sec が二桁台半ばまで落ちます。バックエンド選択は用途で分かれます。MoE と小中モデルの decode は Vulkan RADV が ROCm を 20〜35% 上回り、dense 27B 近辺は ROCm 7 が逆転するケースもあります。32GB を1枚で安く積みたい層にとって R9700 は刺さる位置にいますが、「70B を単機で動かす目的」で買うと確実に裏切られます。
iris-lab の保有実機は RTX 4070 12GB のみで、R9700 の自前実測はありません。本記事の数値はすべて公開ベンチと GitHub discussion の集約で、出典は各表と本文中の URL に記載しています。R9700 を RTX 5090 / 5080 と比べて「買いか」判断したい場合は AMD Radeon AI PRO R9700 32GB はローカルLLMで買いか 2026年版 を、ROCm と CUDA の全体像は ROCm と CUDA、ローカルLLMで本当に差はあるのか 2026年版 を併読してください。
R9700 単機のハード制約を先に確認する
バックエンド比較の前に、32GB VRAM と 640GB/s 帯域で何が載って何が載らないかを押さえておきます。
| 指標 | Radeon AI PRO R9700 |
|---|---|
| VRAM | 32GB GDDR6 |
| メモリ帯域 | 約 640 GB/s |
| 対応バックエンド | ROCm 7 / Vulkan(RADV・AMDVLK) |
| 対応アーキ | RDNA 4(gfx1201) |
| 価格目安(米国) | 約 $1,244〜$1,299 |
参考:AMD Radeon AI PRO 公式ページ、AMD ROCm 対応表(PDF)。
ローカルLLM の生成(decode)速度はメモリ帯域でほぼ決まります。R9700 の 640GB/s は RTX 5090(約1.8TB/s)の約35%、RTX 5080(約960GB/s)の約67% にあたります。帯域律速になる 70B 密モデルで RTX 5090 と大差が出るのはこの数値の帰結です。帯域と tok/sec の対応は メモリ帯域幅がローカルLLMの tok/sec を決める仕組み に展開しています。
モデル別に「載るか・何 tok/sec か」を切る
Q4_K_M 量子化で VRAM に必要な容量と、公開ベンチの decode / prefill の中央値を並べます。
| モデル | VRAM 要件(Q4_K_M) | 32GB 単機で載るか | decode tok/sec(中央値) | prefill 傾向 |
|---|---|---|---|---|
| Llama 3.2 8B | 約 5〜6 GB | ◎ 余裕 | 55〜75 | 高い |
| Qwen 3 14B | 約 9〜10 GB | ◎ 余裕 | 35〜50 | 中〜高 |
| Qwen 3 32B(dense) | 約 20〜22 GB | ◯ 載る | 20〜28 | 中 |
| Qwen3-30B-A3B(MoE) | 約 17〜19 GB | ◎ 余裕 | 150〜185 | 中 |
| Qwen3.5-35B-A3B(MoE) | 約 20〜23 GB | ◯ 載る | 127〜156 | 中 |
| Llama 3.3 70B(dense) | 約 39〜42 GB | ✕ 載らない | 10〜16(RAM オフロード) | 低(劇的に落ちる) |
MoE モデルは「アクティブパラメータ量 × 帯域」で動くため、同じサイズの dense モデルより tok/sec が明確に速くなります。R9700 単機で「速い体験」を取るなら Qwen3-30B-A3B のような MoE が主戦場です。
70B 密モデルを 32GB 単機で動かすと必然的に CPU/RAM オフロードになり、decode が二桁台半ば(10〜16 tok/sec)まで落ちます。この帯域はストレスなく使うには遅く、「動く」と「使える」の境目にあります。R9700 で 70B を実用レベルで回したいなら dual R9700(64GB)構成が現実解で、Puget Systems のレビューがその構成の数値を出しています(AMD Radeon AI PRO R9700: Dual-GPU AI Inference Performance)。
ROCm 7 と Vulkan のバックエンド差
同じ R9700 でも、llama.cpp の背後で ROCm(HIP)を叩くか Vulkan を叩くかで decode / prefill の数値が大きく変わります。2026 年に ROCm 7 系が RDNA 4 の gfx1201 を正式サポートし、Vulkan 一択だった状況が解消されつつあります。
参考:RDNA4 Vulkan vs ROCm 7.2 for Local LLMs、GitHub ggml-org/llama.cpp Discussion #19890、llama.cpp-rdna4-gfx1201 ネイティブ対応ビルド。
MoE・小中モデルの decode
| モデル | バックエンド | tg128(tok/sec) |
|---|---|---|
| Qwen3-30B-A3B Q4_K_M | Vulkan RADV | 約 183 |
| Qwen3-30B-A3B Q4_K_M | ROCm 7(HIP) | 約 150 |
| Qwen3.5-35B-A3B Q4_K_XL | Vulkan(llama.cpp) | 約 127 |
| 小型 MoE 代表値 | Vulkan | 138.8 |
| 小型 MoE 代表値 | ROCm | 98.0 |
RDNA 4 + 小中モデル・MoE の decode では Vulkan が ROCm を 20〜35% 上回る構図です。llama.cpp 側の Vulkan 実装が RDNA 4 向けに最適化されたのが大きく、ROCm 7 の gfx1201 対応が後発である事情が効いています。
dense 中大型モデルの decode
一方で dense 27B 近辺の decode では ROCm 7 が Vulkan を逆転するケースがあります。コミュニティ実測では ROCm が dense 27B の decode で Vulkan を 47% 上回る報告があります(GitHub ggml-org/llama.cpp Discussion #15021)。27B〜32B の dense クラスを常用するなら ROCm を優先候補にする価値があります。
prefill(プロンプト処理)
| 条件 | バックエンド | pp512(tok/sec) |
|---|---|---|
| 一般ベンチ中央値 | Vulkan | 約 5,620 |
| 一般ベンチ中央値 | ROCm | 約 4,773 |
| Qwen3 32B Q4_K_M | ROCm 7(最適化ビルド) | 約 925 |
短コンテキストの pp512 では Vulkan が ROCm をわずかに上回る相場です。ただし長コンテキスト(32K 超)や Flash Attention を使う場面では ROCm 7 側に優位性が出る傾向があり、prefill の総合判断は使うコンテキスト長に依存します。prefill が体感に効く理由は ローカルLLM の prompt processing(prefill)ベンチマーク に展開しています。
バックエンド選択の実務ルール
数値を踏まえて、R9700 単機で llama.cpp を使うときのバックエンド選択を整理します。
| 用途 | 推奨バックエンド | 根拠 |
|---|---|---|
| 7B〜14B を日常的に回す | Vulkan RADV | decode 20〜35% 速い、セットアップも最小 |
| Qwen3-30B-A3B などの MoE | Vulkan RADV | MoE decode で明確に優位 |
| dense 27B〜32B を丁寧に推論 | ROCm 7 | dense 中大型で逆転する実測あり |
| 長コンテキスト RAG(32K+) | ROCm 7 + Flash Attention | pp 維持が最重要 |
| 70B dense(RAM オフロード前提) | ROCm 7 | 帯域律速かつオフロード処理の最適化が効く |
| ComfyUI / Diffusers 同居 | ROCm 7 | HIP 前提のツールと共用 |
Strix Halo での同種議論(Strix Halo で llama.cpp Vulkan vs ROCm 2026年版)と相似形ですが、R9700 の方が帯域が広い(640 vs 256 GB/s)ため絶対速度は 2〜3 倍の帯になります。
プロンプト処理の遅さが体感に出る境目
decode は速くても prefill が遅い構図は、R9700 単機にも当てはまります。R9700 の 640GB/s は RTX 5090 の約35% なので、長文プロンプトでは最初のトークン生成まで待ち時間が明確に伸びます。
- 短いチャット(プロンプト〜1,000 トークン):差は体感レベルで小さい
- 中程度のコンテキスト(4K〜8K トークン):数秒〜十数秒の待機が増える
- 長文 RAG・コードベース読み込み(32K+):数十秒〜分オーダーの prefill 待機が常態化する
長文エージェント運用を主軸にするなら R9700 単機は厳しく、RTX 5090 1 枚か dual R9700 構成に寄せたほうが実用的です。R9700 を選ぶのは「decode 速度と 32GB VRAM の両立をコスパで取りたい」用途が中心になります。
セットアップ時の落とし穴
実機を手に入れた後の詰まりやすいポイントを 3 つ挙げます。
- ROCm は 7.x 系で gfx1201 を正式対応しました。古い ROCm 6.x では R9700 の性能が出ないため、Phoronix の launch testing で言及されている通り ROCm 7 系をベースにビルドしてください
- llama.cpp は RDNA 4 ネイティブ対応ビルドが有利です。tlee933/llama.cpp-rdna4-gfx1201 のように gfx1201 向けのビルド構成で 98.97 tok/sec(コミュニティ最適化版、RTX 4070 Ti 相当)という報告があります
- Vulkan RADV は Mesa 25 系以降が実用ラインです。Ubuntu 24.04 標準の Mesa でも動きますが、最新 Mesa で RDNA 4 のパスが最適化されており、apt の古いバージョンだと decode の数値が伸びません
R9700 単機で現実的な用途まとめ
ここまでを 1 枚にまとめます。
| 用途 | R9700 単機で現実的か |
|---|---|
| 日常のコーディング補助(7B〜14B) | ◎ 最適解の一つ |
| エージェント運用(MoE 30B クラス) | ◎ decode 150+ tok/sec |
| dense 32B 推論 | ◯ 20〜28 tok/sec、ROCm 推奨 |
| 32GB で足りる Stable Diffusion / Flux | ◯ ROCm 経路で動作 |
| 70B dense の実用運用 | ✕ オフロード前提で遅い |
| 100K+ 長コンテキスト RAG | △ prefill が遅い |
| LoRA / QLoRA 学習 | ◯ ROCm 7 + PyTorch で動作 |
R9700 は「32GB VRAM を 1 枚で安く確保し、decode 速度でも手を抜きたくない」層に刺さる GPU です。70B を単機で動かす目的や、長コンテキスト前提の RAG 運用には別の選択肢(dual R9700 / RTX 5090 / Mac Studio)が合います。48GB で組む構成全体像は 48GB VRAM で組むローカルLLM デスクトップ構築ガイド 2026年版 に、必要スペックの上位ガイドは ローカルLLMを動かすPCの最低スペック 2026年版 にあります。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
Radeon AI PRO R9700 本体
対応電源(1 枚 TBP 300W 想定、将来の dual 構成も見込んで 850W 以上を推奨)
モデルファイル格納用の高速 NVMe SSD(Gen5、2TB)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- AMD Radeon AI PRO R9700 32GB はローカルLLMで買いか 2026年版:RTX 5090 / 5080 と価格・tok/sec で突き合わせた「買いか」判断
- ROCm と CUDA、ローカルLLMで本当に差はあるのか 2026年版:NVIDIA CUDA との対比で ROCm 全体の立ち位置を整理
- 48GB VRAM で組むローカルLLM デスクトップ構築ガイド 2026年版:VRAM 32GB の壁を越える構成例
- ローカルLLMを動かすPCの最低スペック 2026年版:必要スペック上位ガイド