Strix Halo(Ryzen AI MAX+ 395)で llama.cpp Vulkan vs ROCm ベンチマーク 2026年版
Ryzen AI MAX+ 395(Strix Halo)で llama.cpp を回すとき Vulkan バックエンドと ROCm バックエンドのどちらが速いのかを、公開ベンチの token 生成速度・prompt processing・長コンテキスト時の劣化幅で比較します。8B / 30B MoE / 122B クラスの実測値と、Vulkan RADV / ROCm 6.4.4 + hipBLASLt / Flash Attention の使い分け判断まで整理しました。
- #Strix Halo
- #Ryzen AI MAX+ 395
- #llama.cpp
- #Vulkan
- #ROCm
- #ローカルLLM
- #RADV
- #hipBLASLt
- #Radeon 8060S
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
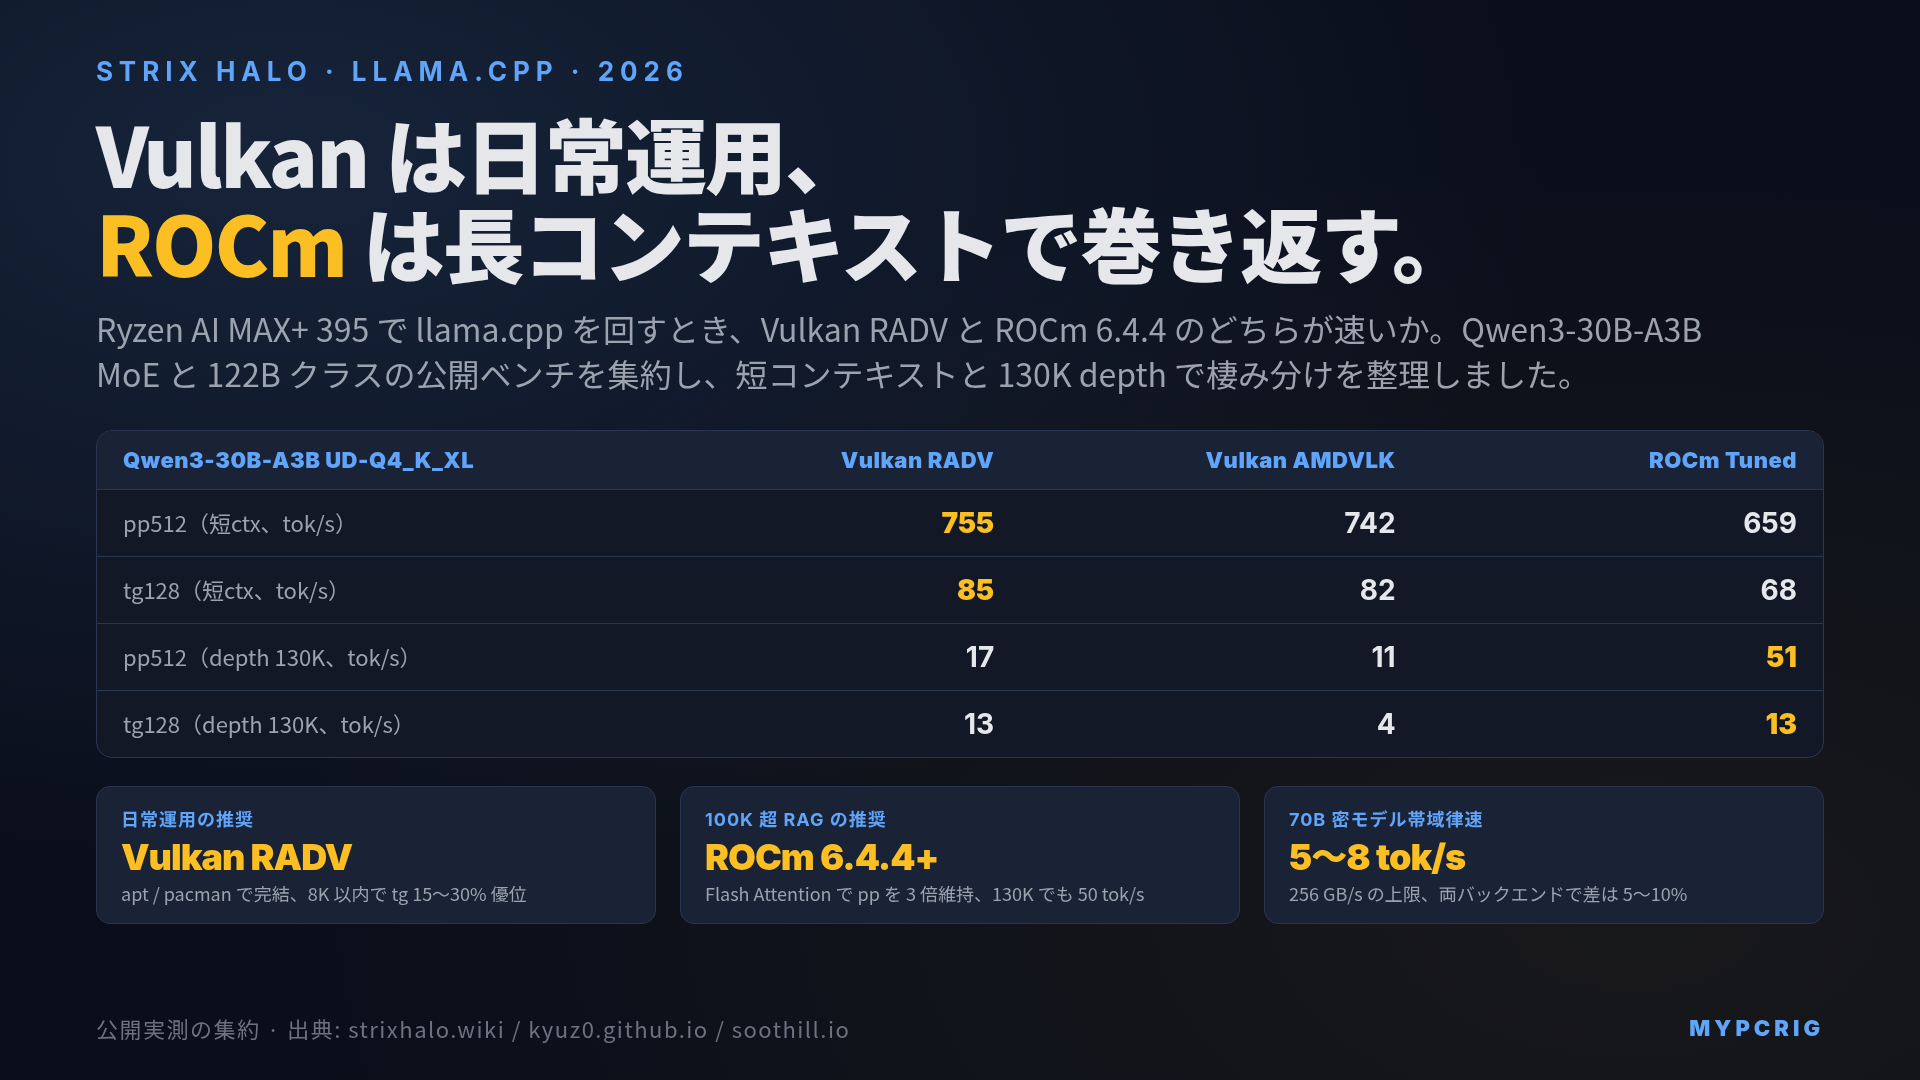
結論:Strix Halo(Ryzen AI MAX+ 395)で llama.cpp を今すぐ使うなら、まずは Vulkan バックエンド(RADV ドライバ)で始めるのが正解です。短〜中コンテキスト(〜8K)の token 生成では Vulkan が ROCm を 15〜30% 上回るケースが多いです。セットアップも apt / pacman で完了します。一方、prompt processing(prefill)は 2026 年の公開ベンチの多くで ROCm の方が速く、入力が長いほど差が開きます。ROCm を選ぶ意味は「長いプロンプトを速く読ませたい」「長コンテキストで prompt processing の速度を維持したい」場合です。ROCm 6.4.4 + hipBLASLt + ROCWMMA + Flash Attention の組み合わせが 130K トークン級の深いコンテキストでも pp を数倍維持できます。実運用では両者を使い分けるのが妥当です。Vulkan は日常使い、ROCm は長コンテキスト運用、というのが 2026 年 9 月時点の落とし所です。
Ryzen AI MAX+ 395(Strix Halo)に統合された Radeon 8060S iGPU は、RDNA 3.5・40 CU で 96GB を VRAM として割り当てられる希少なハードウェアです。llama.cpp を動かす際に選べるバックエンドは Vulkan と ROCm(HIP)の 2 つですが、コミュニティでは「Vulkan の方が速い」「いや ROCm 6.4 系なら勝てる」と結論が分かれてきました。本記事では 2026 年夏以降に出揃った公開ベンチを集約し、モデル別・コンテキスト長別に「どちらを選ぶべきか」を整理します。
iris-lab の保有実機は RTX 4070 12GB のみで、Strix Halo の自前実測はありません。以下の数値はすべて第三者ベンチの集約で、出典は各表と本文中の URL に記載しています。Strix Halo 全体像は Ryzen AI MAX+ 395(Strix Halo)ローカルLLM 推論ベンチマーク 2026年版 を、96GB VRAM 割当の BIOS 設定は Ryzen AI MAX+ 395 で iGPU に 96GB を割り当てる BIOS 設定ガイド 2026年版 を先に読むと前提が揃います。
なぜ Vulkan と ROCm を比較する必要があるのか
llama.cpp は Strix Halo 上で複数のバックエンドから GPU を叩けます。
CPU バックエンドは論外として、iGPU を使う経路は以下の 3 通りです。
| バックエンド | 想定ドライバ | セットアップ難易度 | 対応幅 |
|---|---|---|---|
| Vulkan | RADV(Mesa) / AMDVLK | 低(Ubuntu 24.04 標準) | RDNA 3.5 + Windows / Linux |
| ROCm(HIP) | rocm-hip-runtime + hipBLASLt | 中(ROCm 6.4.4 以降で Strix Halo 正式対応) | RDNA 3.5 / Linux のみが実用 |
| OpenCL | rocm-opencl-runtime | 低 | 遅く、実測ベンチではほぼ非採用 |
「まず速いのはどっち」を決めておかないと、Strix Halo を買ってから何時間も再ビルドで潰すことになります。特に Strix Halo は 2026 年に入って ROCm の対応が急速に進んだため、旧い記事(2025 年秋以前)を根拠にすると判断を誤ります。
公開ベンチ集約:Qwen3-30B-A3B(MoE)と Qwen3.5-122B の実測
Strix Halo Wiki と Soot / Silicon(2026-08-03)の llama.cpp 比較ベンチから、モデル別に代表値を抜き出します。数値はいずれも Ryzen AI MAX+ 395 / 128GB LPDDR5X / iGPU 96GB 割当 / Linux 環境での実測です。
Qwen3-30B-A3B UD-Q4_K_XL(MoE、17.5GB):短コンテキスト
Strix Halo Wiki /AI/llamacpp-performance の pp512 / tg128 テーブルからの引用です。
| バックエンド | pp512(tok/sec) | tg128(tok/sec) |
|---|---|---|
| Vulkan RADV | 755 | 85 |
| Vulkan AMDVLK | 742 | 82 |
| ROCm(素) | 651 | 64 |
| ROCm + hipBLASLt | 652 | 64 |
| ROCm Tuned | 659 | 68 |
この表(pp512、短いプロンプト)では Vulkan RADV が prompt processing・token generation の両方で ROCm を上回っています。ただし後述のとおり、2026 年の他の公開ベンチでは長いプロンプトの prompt processing は ROCm の方が速いという結果が多く、「prefill も Vulkan が速い」とは言えません。ドライバ差では RADV が AMDVLK より 2〜5% 速く、AMD 純正よりも Mesa 側の実装が現状は速い、という逆転現象が観測されています。
出典:llama.cpp Performance — Strix Halo Wiki
Qwen3-30B-A3B UD-Q4_K_XL:長コンテキスト(depth 130,560 での pp512 / tg128)
同じ Wiki の depth 130K テーブルです。深いコンテキストで再計算されるときの速度を測っています。
| バックエンド | pp512(tok/sec) | tg128(tok/sec) |
|---|---|---|
| Vulkan RADV | 17 | 12.5 |
| Vulkan AMDVLK | 10.75 | 3.5 |
| ROCm Tuned(+Flash Attention) | 51 | 13.3 |
130K トークン相当の深さで再計算する場面では、ROCm Tuned + Flash Attention が pp を約 3 倍維持しています。Vulkan AMDVLK は極端に落ちます。RADV でも短コンテキストの 45 倍遅い pp まで下がります。
長コンテキスト RAG や 100K トークン規模のコードベース読み込みを頻繁にやるなら、この差はセッション体感を大きく左右します。
出典:llama.cpp Performance — Strix Halo Wiki
Qwen3-Coder-30B Q4_K_S(17.46GB):32K コンテキストでの pp / tg
Soot / Silicon の EVO-X3 での比較から、32K コンテキストでの値を抜きます。
| バックエンド | pp(tok/sec) | tg(tok/sec) |
|---|---|---|
| Vulkan | 1,115.3 | 97.7 |
| ROCm | 1,344.7 | 73.7 |
(Flash Attention 有効、32K ctx)
tg では Vulkan が ROCm を 32% 上回る一方、pp では ROCm が Vulkan を約 2 割上回っています。コーディング用途の「短いプロンプト + 長い生成」パターンでは Vulkan 有利、長いプロンプトを読ませる用途では ROCm 有利、と処理で分かれます。
出典:llama.cpp: Vulkan vs ROCm on Strix Halo — Soot / Silicon(2026-08-03)
Qwen3.5-122B UD-Q4_K_XL(77GB):大型モデル + 短コンテキスト
同じく Soot / Silicon のデータです。96GB VRAM 割当でギリギリ載る大型モデル領域です。
| バックエンド | pp4096(tok/sec) | tg128(tok/sec) |
|---|---|---|
| Vulkan | 374.3 | 22.9 |
| ROCm | 523.0 | 21.3 |
大型モデルでは tg の差が縮まり、実質同等になります。pp は ROCm が約 4 割速いままです。122B クラスまで来るとメモリ帯域律速の色が強くなります。バックエンド差が薄まる傾向は他の RDNA 3 世代でも観測されているパターンです。
出典:llama.cpp: Vulkan vs ROCm on Strix Halo — Soot / Silicon(2026-08-03)。同じ傾向(pp16384 は HIP が 41〜48% 速く、tg128 は Vulkan が 5〜19% 速い)は nabe2030/hip-vs-vulkan-evo-x2(2026 年 4 月、ROCm 7.2.2、6 モデル)でも報告されています。
一般的な速度レンジ(コミュニティ実測の中央値)
個別ベンチではなく「Strix Halo でこのモデルサイズなら大体これくらい」の相場感も押さえておきます。llm-tracker.info の集計とコミュニティスレッドから抽出した中央値です。
| モデルサイズ | 量子化 | tg(tok/sec) | 補足 |
|---|---|---|---|
| 7〜13B 密モデル | Q4_K_M | 30〜45 | Vulkan / ROCm 差は 10〜20% |
| 30B 密モデル | Q4_K_M | 15〜22 | 中間帯、バックエンド差が最も出る |
| 30B MoE(Qwen3-30B-A3B 等) | Q4_K_M | 70〜100 | エキスパート活性化率次第で上限側 |
| 70B 密モデル | Q4_K_M | 5〜8 | 帯域律速、バックエンド差は 5〜10% |
| 122B MoE(Qwen3.5-122B-A10B 等) | Q4_K_XL | 20〜23 | 77GB クラス、短コンテキストのみ現実的 |
出典:Strix Halo Tokens Per Second 2026 — DataHardware / llama.cpp Performance — Strix Halo Wiki
70B 密モデルの 5〜8 tok/sec は 256 GB/s の帯域上限で決まる領域です。ここは Vulkan でも ROCm でもほぼ変わりません。
差が出るのは中間帯(30B 密)と MoE です。
Vulkan が勝つ場面、ROCm が勝つ場面
数値を整理すると、以下の切り分けが妥当です。
Vulkan(RADV 推奨)を選ぶ
- 常用モデルが 7B〜30B(密 / MoE)で、コンテキストは 8K 以内が中心
- Ubuntu 24.04 / Arch などで「セットアップに時間をかけたくない」
- Windows でも動かしたい場面がある
- ドライバ更新(Mesa 25 系)でさらなる性能向上を追いたい
Vulkan RADV は Mesa の一部として入るため、Ubuntu なら apt install mesa-vulkan-drivers で完結します。llama.cpp のビルドは cmake -DGGML_VULKAN=ON を渡すだけです。追加パッケージも最小限です。
日常運用のデフォルトはこちらに寄せておくのが安全です。
ROCm 6.4.4+ を選ぶ
- 100K トークン超の長コンテキストを RAG / コードベース読み込みで頻繁に使う
- 学習・ファインチューニング(LoRA / QLoRA)まで視野に入る
- ComfyUI や Diffusers など HIP バックエンド前提のツールも同居させたい
- Flash Attention と hipBLASLt を組み合わせた最適化を許容できる
ROCm 6.4.4 は 2025 年秋に Strix Halo(gfx1151)を正式サポートしました。hipBLASLt 対応で GEMM 性能が改善しました。追加で ROCWMMA 拡張と Flash Attention を有効化すると、130K トークン級の depth でも pp を 50 tok/sec 超で維持できます。
長い会話履歴・長いソースコードを繰り返し読む用途では、この耐久性が体感を決めます。
出典:llama.cpp: Vulkan vs ROCm on Strix Halo — Soot / Silicon(2026-08-03)
モデル別の再現性が低いケースに注意
同じ Strix Halo でも、モデル・量子化・llama.cpp ビルド番号で結果が反転する事例があります。
- Qwen3.8 Flash Next では Vulkan 11.6 tok/sec に対し ROCm 1.8 tok/sec と、Vulkan が 6.4 倍速いという極端な結果が報告されています(Soot / Silicon、2026-08-27)
- 逆に「Vulkan beats ROCm は誤解」という反証記事もあり、llama.cpp のビルド差・実行フラグ差で結論が変わることを指摘しています(Bkpaine, Medium 2026-07)
ベンチ数値は llama.cpp のビルド番号(Soot / Silicon の比較でも ROCm は b10085、Vulkan は b10216 と揃っていません)と Flash Attention の有無で 10〜30% は動きます。「自分の使うモデルで実測する」まではあくまで参考値、という前提で読んでください。
セットアップ時の落とし穴
いざインストールする段階で詰まりやすいポイントを 3 つ挙げておきます。
- ROCm は 6.4.4 以降でないと Strix Halo(gfx1151)の性能が出ません。Ubuntu の apt 標準リポジトリはバージョンが古いことがあるため、AMD 公式の rocm.docs.amd.com からインストール手順を追うのが安全です
- Vulkan RADV は Mesa 25.0 系以降で Strix Halo(RDNA 3.5)のパスが最適化されました。古い Ubuntu 22.04 で apt 経由で入る Mesa では性能が伸びません
- BIOS の UMA Frame Buffer Size を 96GB に設定していないと、大型モデルはロードすらできません。llama.cpp のバックエンド以前の設定なので、先に BIOS 設定ガイド で確認してください
用途別の判断まとめ
ここまでを 1 枚に集約します。
| 用途 | 推奨バックエンド | 補足 |
|---|---|---|
| 8B〜13B を毎日カジュアルに回す | Vulkan RADV | セットアップ最小、tg 30〜45 tok/sec |
| 30B MoE(Qwen3-30B-A3B)でエージェント運用 | Vulkan RADV | tg 70〜100 tok/sec、体感高速 |
| 30B 密モデルで丁寧に推論 | Vulkan または ROCm 6.4.4+ | 差 15〜30%、環境依存 |
| 70B 密モデルを容量目当てで載せる | どちらでも同等 | 帯域律速、5〜8 tok/sec |
| 100K 超の長コンテキスト RAG / コードベース | ROCm + Flash Attention | pp 維持が最重要、depth 130K でも 50 tok/sec |
| ローカル LoRA / QLoRA 学習 | ROCm | 学習系ライブラリは HIP 前提が多い |
| ComfyUI / Diffusers も同居 | ROCm | HIP バックエンド共用でストレージ節約 |
Strix Halo と他ハードウェアとの比較
同じ 30B MoE を回す場合の相場感で比較すると、Strix Halo(Vulkan RADV)で 70〜100 tok/sec、RTX 5090 で 200 tok/sec 超、Mac Studio M3 Ultra で 90〜120 tok/sec というのが公開ベンチの相場です。速度単独では RTX 5090 が明確に速いものの、96GB VRAM で 70B 密 + 30B MoE を同時に置ける Strix Halo、512GB Unified で巨大 MoE を単体ロードできる Mac Studio、と各機に独自ポジションがあります。
詳細は Strix Halo と Mac Studio M3 Ultra 比較 2026年版 と ROCm と CUDA、ローカル LLM で本当に差はあるのか 2026年版 を併読してください。
llama.cpp 以外のランタイム(Ollama / LM Studio / vLLM)を比較したい場合は ローカル LLM 実行ツール比較 2026年版 をどうぞ。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
Ryzen AI MAX+ 395(Strix Halo)搭載ミニPC
- Ryzen AI MAX+ 395 搭載ミニPC(128GB)を Amazon.co.jp で探す
- GMKtec EVO-X2(Ryzen AI MAX+ 395 / 128GB)を Amazon.co.jp で見る
- MINISFORUM MS-S1 MAX(Ryzen AI Max+ 395 / 128GB)を Amazon.co.jp で見る
Framework Desktop(BD395i MAX 基板 / Ryzen AI MAX+ 395 採用)は Amazon.co.jp では単独ページが安定していないため、公式サイト frame.work/jp/ja/desktop で確認するのが確実です。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- Ryzen AI MAX+ 395(Strix Halo)ローカルLLM 推論ベンチマーク 2026年版:Strix Halo の絶対 tok/sec を機種横並びで整理
- Ryzen AI MAX+ 395 で iGPU に 96GB を割り当てる BIOS 設定ガイド 2026年版:UMA / GTT の BIOS 設定と OS 側のチェック手順
- ROCm と CUDA、ローカル LLM で本当に差はあるのか 2026年版:NVIDIA CUDA との対比で ROCm の立ち位置を整理
- ローカル LLM 実行ツール比較 2026年版:Ollama / LM Studio / llama.cpp / vLLM の使い分け