ゲーミングPCでローカルLLMは動くか 2026年版
手元のゲーミングPC (RTX 5090 / 5080 / 5070 Ti / Ryzen 7 7800X3D 構成) でローカルLLM は本当に動くか。32GB・16GB・12GB VRAM 別に何 B のモデルが実用的に回るか、ゲームと LLM を同時起動したときの fps 低下と tok/sec の折衷、24h LLM 常時運用の電気代、AI 専用機を別に組むべき境界を 2026 年版で判定します。
- #ゲーミングPC
- #ローカルLLM
- #RTX 5090
- #RTX 5080
- #RTX 5070 Ti
- #AI 兼用
- #Claude Code
- #Ollama
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
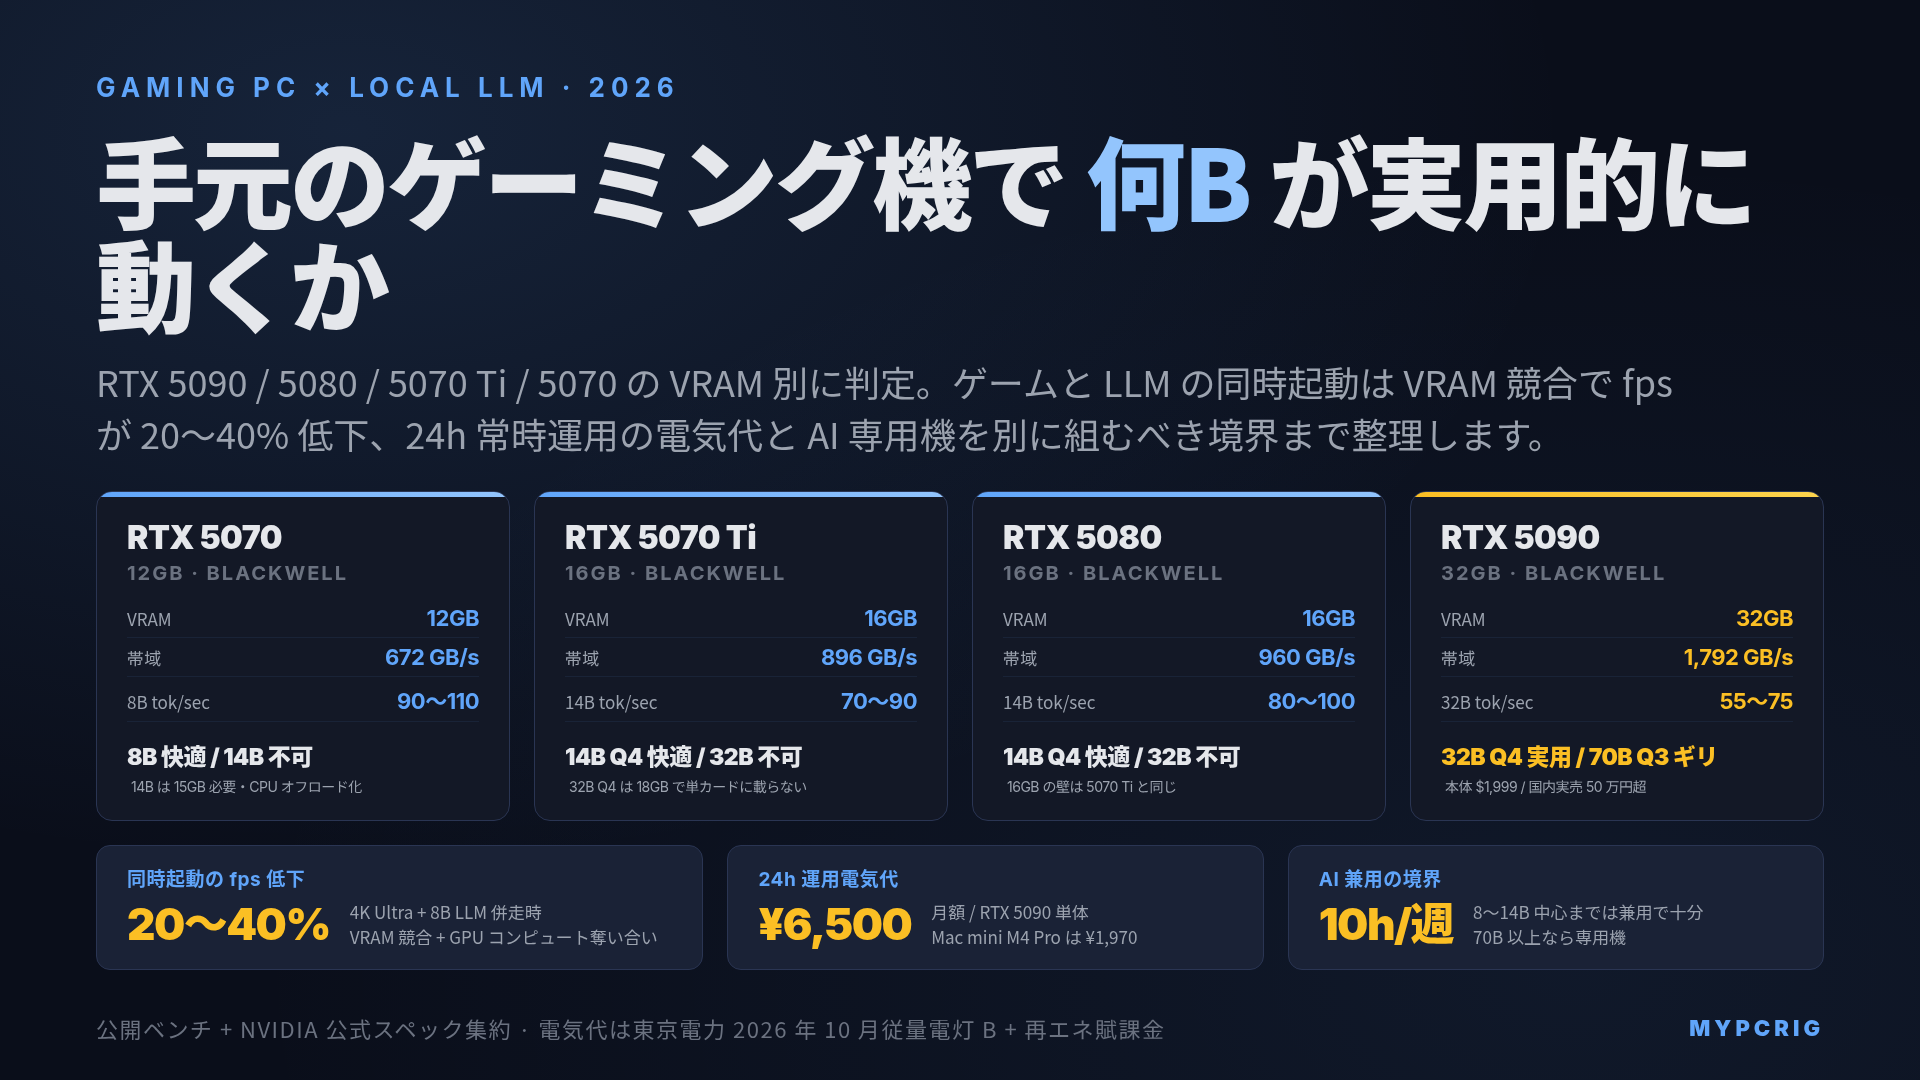
結論:手元のゲーミングPCで動くローカルLLMは VRAM 次第です。12GB で 8B 快適、16GB で 14B 快適、24GB で 32B Q4 実用、32GB で 70B Q3 がギリ回ります。ゲームと LLM の同時起動は VRAM 競合で fps が 20〜40% 落ちるため実運用は推奨しません。週 10 時間以内の AI 利用で 8〜14B 中心ならゲーミング兼用で十分、70B 以上を頻繁に使う・24h LLM サービングを回したい・エージェントで高応答性が要るなら AI 専用機を別に組むべきです。tok/sec の数値は公開ベンチの集約値です。
RTX 5090 / 5080 / 5070 Ti を積んだゲーミングPC を既に持っていると、「このマシンでローカルLLM も動かせないか」という発想が自然に出てきます。Claude Code や Codex の普及で「手元で LLM を回したい」場面が増え、Ollama の日本語化で入り口のハードルも下がりました。この記事では、手持ちのゲーミングPC で LLM を兼用するときの判定を 7 つの軸で整理します。
数値の出典は、各 GPU の NVIDIA 公式スペック・Ollama 公式モデル VRAM 表・llama.cpp の公開ベンチからの集約値です。この記事の GPU について筆者の実測は含まれません。
VRAM 容量別:何 B のモデルが実用ラインか
ローカル LLM が動くかは VRAM で決まります。ゲーミング GPU の主要 SKU と、各 VRAM で実用的に回るモデル規模を Q4_K_M 量子化前提で整理します。
| GPU | VRAM | 実用ラインのモデル | 8B tok/sec(Q4) | 14B tok/sec | 32B tok/sec(Q4) |
|---|---|---|---|---|---|
| RTX 5060 Ti 16GB | 16GB | 14B Q4 | 70〜90 | 35〜50 | 不可 |
| RTX 5070 12GB | 12GB | 8B Q4 | 90〜110 | 不可(15GB 必要) | 不可 |
| RTX 5070 Ti 16GB | 16GB | 14B Q4 | 130〜160 | 70〜90 | 不可 |
| RTX 5080 16GB | 16GB | 14B Q4 | 145〜175 | 80〜100 | 不可 |
| RTX 5090 32GB | 32GB | 32B Q4 / 70B Q3 ギリ | 200〜260 | 120〜160 | 55〜75 |
tok/sec は decode(1 トークンずつ生成する段階)の目安で、メモリ帯域律速です。モデルが VRAM に収まっている限り、帯域が広い RTX 5070(672 GB/s)、RTX 5080(960 GB/s)、RTX 5090(1,792 GB/s)の順にほぼ帯域に比例して tok/sec が伸びる構造です。
12GB の壁:RTX 5070 の 12GB は 8B までが実用ラインで、14B Q4 は重み単体で約 8GB・KV キャッシュ込みで 15GB 近く必要なため、VRAM オーバーして CPU オフロードになります。CPU オフロードが入ると tok/sec は 1/5〜1/10 まで落ちるため、Ollama で 14B を選ぶと「動くけれど遅い」状態になります。
16GB の壁:RTX 5070 Ti / 5080 / 5060 Ti の 16GB は 14B までが快適です。32B Q4 は重み 18GB で単カードに載りません。16GB で 32B を回したい場合は Q3 量子化(15GB 前後)に落とすか、CPU オフロードを許容することになります。
24GB の壁:ゲーミング GPU で 24GB は RTX 3090 24GB 中古か、未発売の RTX 5070 Ti Super 24GB を待つかの 2 択です。詳細は「RTX 5070 Ti Super 24GB いつ発売 2026」で扱っています。
32GB の RTX 5090:32B Q4 が余裕、70B Q3_K_S がギリ(約 30GB)、Stable Diffusion XL も余裕という理想的な構成です。ただし本体価格 $1,999 / 国内実売 50 万円超のため、「ゲーミング兼用」の予算感を超えます。
VRAM 容量とモデル対応の全体像は「ローカルLLM メモリ容量別 動かせるモデル早見表 2026年版」で詳しく扱っています。
ゲームと LLM の同時起動:fps と tok/sec の折衷
「ゲームプレイ中にバックグラウンドで LLM を回したい」というシナリオを整理します。結論は推奨しません。
バックグラウンド LLM + 前面ゲームプレイ
同じ GPU で 2 系統のワークロードを同時に動かすと、VRAM の取り合いと GPU コンピュートの奪い合いが同時に発生します。公開ベンチと NVIDIA のドライバドキュメントから、おおよその影響を集約します。
| シナリオ | ゲーム fps | LLM tok/sec | 可否 |
|---|---|---|---|
| ゲーム単体(4K Ultra) | 100% | — | ○ |
| ゲーム + 8B LLM(VRAM 7GB 消費) | 60〜80% | 20〜40 tok/s(通常の半分) | △ |
| ゲーム + 14B LLM(VRAM 11GB 消費) | VRAM オーバーで不安定 | 不安定 | ✗ |
| ゲーム + 32B LLM(VRAM 22GB 消費) | 不可(16GB VRAM では) | 不可 | ✗ |
RTX 5090 32GB なら 8B LLM をバックグラウンドに置いても VRAM に余裕があるため動きますが、fps は 20〜40% 落ちます。4K 144Hz を狙うゲーミング用途でこの fps 低下は体感で明確に差が出ます。
推奨する運用:ゲーム終了後に LLM を立ち上げる、または Alt+Tab で切り替える前提にする。Ollama は OLLAMA_KEEP_ALIVE でモデルをメモリに残す秒数を調整できますが、ゲームプレイ中にモデルをアンロードしておけば VRAM を全部ゲームに回せます。
24h LLM 常時運用の場合
LLM サーバーを 24h 動かしつつゲームもしたい場合、Linux dual boot で LLM 専用セッションを分けるか、Windows の WSL2 + Ollama で LLM をバックグラウンドに置くかの選択になります。WSL2 の運用詳細は「WSL2 で動かすローカルLLM セットアップガイド 2026年版」が参考になります。
ただし 24h 稼働は電気代の問題も出てきます。次の節で試算します。
24h 常時運用の電気代:GPU 別の月額試算
ゲーミング GPU を 24h LLM サービングに回した場合の月額電気代を試算します。単価は姉妹記事「デスクトップPCの消費電力と電気代 GPU別 早見表 2026年版」と同じく、東京電力 従量電灯 B の第 3 段階 40.49 円/kWh(税込、2026 年 10 月時点)に、再エネ発電促進賦課金 4.18 円/kWh(2026 年 5 月〜2027 年 4 月検針分)を足した実効 44.67 円/kWh です。燃料費調整額は月ごとに変わるため含めていません。
GPU の idle 時と推論時の消費電力は NVIDIA 公式スペック(TGP)と、Tom’s Hardware / TechPowerUp のレビューの集約値で、GPU 単体の値です(CPU・マザーボード等は含まない)。Mac の 2 機種は Apple 公式の消費電力ページ(Mac mini / Mac Studio)の値で、壁コンセントで測ったシステム全体の値です。推論時は Apple 公式の最大値をそのまま置いた上限側の見積もりです。
| GPU | idle | 推論時 | 1 日 10 時間推論 + 14 時間 idle | 月額電気代 |
|---|---|---|---|---|
| RTX 5070 12GB(GPU 単体) | 15W | 220W | 2.41 kWh/日 | 約 3,230 円 |
| RTX 5070 Ti 16GB(GPU 単体) | 20W | 300W | 3.28 kWh/日 | 約 4,400 円 |
| RTX 5080 16GB(GPU 単体) | 25W | 360W | 3.95 kWh/日 | 約 5,290 円 |
| RTX 5090 32GB(GPU 単体) | 25W | 450W | 4.85 kWh/日 | 約 6,500 円 |
| Mac mini M4 Pro(システム全体) | 5W | 140W(最大) | 1.47 kWh/日 | 約 1,970 円 |
| Mac Studio M3 Ultra(システム全体) | 9W | 270W(最大) | 2.83 kWh/日 | 約 3,790 円 |
RTX 5090 で 1 日 10 時間推論を回すと、GPU 単体だけで月額約 6,500 円の電気代がかかります。Mac mini M4 Pro はシステム全体を Apple 公式の最大値で見積もっても約 1,970 円で、約 3.3 倍の差です。RTX 5090 機は CPU やマザーボードの電力が上乗せされるので、実際の差はこれより開きます。LLM を本格的に 24h 回すなら、Apple Silicon の電力効率が明確に優位です。システム全体の消費電力で比べた早見表は姉妹記事「デスクトップPCの消費電力と電気代 GPU別 早見表 2026年版」で扱っています。
ゲーミングを並行して楽しむ場合は、ゲーム時のピーク電力(RTX 5090 で 575W)も加算されるため、純粋な AI 専用機より電気代は高めになります。
AI 専用機を別に組むべき境界
「手元のゲーミングPC で足りるか / AI 専用機を別に組むべきか」の判断を、利用パターンの実量から整理します。
ゲーミング兼用で足りるケース
- 週 10 時間以内の AI 利用
- モデルは 8〜14B 中心(32B 以上をほとんど使わない)
- ゲームも頻繁に遊ぶ(毎日 2〜3 時間以上)
- LLM の tok/sec が落ちても気にならない用途(コード補完・下書き支援)
- 月額電気代の増分を気にしない
AI 専用機を別に組むべきケース
- 24h LLM サービングを常時回したい
- 70B 以上のモデルを頻繁に使う(32GB〜96GB VRAM が要る)
- ゲームプレイ中も裏で LLM を回したい(fps 低下を許容できない)
- エージェント運用で応答性が重要(マルチターンの TTFT を極小化したい)
- 複数モデルを同時起動して vLLM / SGLang でサービングしたい
別に組む場合の選択肢
- Mac Studio M3 Ultra 96GB:70B Q4 まで実用速度(約 13 tok/s)、電力効率が圧倒的に高く、24h 稼働に向きます。初版時点の価格は 70 万円〜でしたが、M3 Ultra は Apple 公式では販売を終えており、現行の M5 Ultra 96GB は ¥949,800(2026 年 11 月時点)です。詳細は「Mac Studio でローカルLLM を動かすガイド 2026年版」。
- RTX 3090 24GB 中古 × 2 枚:中古 10〜12 万円 × 2 で 48GB VRAM を確保。70B Q4 まで実用的に回ります。初期費用を抑えたい場合の定番です。
- AMD Strix Halo / Ryzen AI MAX 搭載ミニPC:128GB の統合メモリで 96GB 相当を LLM に割り当てられます。消費電力は 100W 前後と低く、Mac Studio の対抗馬として 2026 年に本格普及しました。詳細は「Ryzen AI MAX(Strix Halo)ローカルLLM 実行能力の実測集約 2026年版」。
専用機の最低スペックは「ローカルLLMを動かすPCの最低スペック 2026年版」に整理してあります。
ゲーミング機を AI 用に強化する最小投資
今のゲーミングPC を活かしつつ AI 用途に強化する場合、追加投資の優先順位は次のとおりです。
1. メインメモリ 32GB → 64GB 増設(優先度:高)
Claude Code / Codex のようなコーディングエージェントを動かすと、エディタ・ブラウザ・コンテナ・LLM の全てが同時に走ります。16GB では即スワップし、32GB でもコンテキストが大きい作業で苦しくなります。64GB(DDR5-6000 32GB×2)で明確に余裕が出ます。価格は 2 万円前後です。Claude Code の RAM 使用量は「Claude Code を快適に動かすPC構成 2026年版」で実測が整理されています。
2. NVMe SSD 増設(優先度:中)
ローカル LLM のモデルファイルは 1 本あたり 5〜40GB で、複数モデルをストックすると数百 GB に膨らみます。Samsung 990 PRO 4TB や Crucial T500 2TB の増設でモデル倉庫を確保します。価格は 2〜4 万円です。
3. Linux dual boot(優先度:中、追加費用ゼロ)
Windows + Ollama / WSL2 でも動きますが、Linux ネイティブの方が推論ランタイム(vLLM / SGLang)の安定性が高く、GPU メモリ管理も直接的です。Ubuntu 24.04 LTS を別パーティションに入れておけば、AI 用途の時だけ切り替える運用ができます。
4. 電源容量の見直し(優先度:GPU 増設時のみ)
既存ゲーミング機の電源が 850W の場合、RTX 5090 を増設すると全体 TDP が電源容量に迫ります。LLM 推論は 1 枚の GPU だけ使うのでピーク電力は低めですが、ゲームと LLM の同時運用を本気で考えるなら 1000W〜1200W に増強しておくと安心です。
Claude Code / Codex を手元のゲーミング機で動かす場合
Claude Code や GitHub Codex のようなコーディングエージェントを手元で使う構成は、クラウド API を叩く形が主流で、ローカルの LLM を直接呼ぶ運用は補助的な位置付けになります。この場合の PC 要件は RAM と CPU が中心で、GPU 性能は補助的です。
| 項目 | 推奨スペック |
|---|---|
| CPU | 8 コア 16 スレッド以上(Ryzen 7 7800X3D / Core Ultra 7 265K など) |
| RAM | 32GB 必須、64GB で快適 |
| GPU | ゲーミング用途と同じ(LLM 兼用なら 16GB VRAM 以上) |
| SSD | 1TB NVMe Gen4 以上 |
Claude Code の実測値では、32GB RAM + 8 コア CPU で複数ファイルの編集が快適に動きます。ゲーミング用途で既にこの構成なら、ハードウェアの買い増しなしで Claude Code / Codex が快適に使えます。詳細は「Claude Code を快適に動かすPC構成 2026年版」で tok/sec と RAM 使用量の実測を集約しています。
ローカル推論を併用する場合(オフライン作業用・プライバシー重視の用途)は、VRAM 16GB で 14B モデル、32GB で 32B モデルという VRAM 判定が追加で入ります。
まとめ
- ゲーミングPC で動くローカルLLM は VRAM で決まる。12GB で 8B 快適、16GB で 14B 快適、32GB で 32B Q4 実用・70B Q3 ギリ
- ゲームと LLM の同時起動は VRAM 競合と GPU コンピュート奪い合いで fps が 20〜40% 落ちるため推奨しない。Alt+Tab で切り替える運用が現実的
- 1 日 10 時間推論の月額電気代は RTX 5090(GPU 単体)で約 6,500 円、Mac mini M4 Pro(システム全体・Apple 公式最大値)で約 1,970 円。本格 24h サービングは Apple Silicon が電力効率で優位
- 週 10 時間以内・8〜14B 中心ならゲーミング兼用で十分。24h サービング・70B 以上・エージェント高応答性が要るなら AI 専用機を別に組む
- 最小投資は RAM 64GB 増設(約 2 万円)→ NVMe SSD 増設(約 2〜4 万円)→ Linux dual boot(追加費用ゼロ)の順で効く
- Claude Code / Codex のようなクラウド API を叩くエージェントなら、GPU は補助的で RAM 32GB / 8 コア CPU で快適に動く
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
ゲーミング兼 AI 用途の主要 GPU
- GeForce RTX 5090 32GB を Amazon.co.jp で見る
- GeForce RTX 5080 16GB を Amazon.co.jp で見る
- GeForce RTX 5070 Ti 16GB を Amazon.co.jp で見る
- GeForce RTX 5070 12GB を Amazon.co.jp で見る
- GeForce RTX 5060 Ti 16GB を Amazon.co.jp で見る
CPU とメモリ強化パーツ
- AMD Ryzen 7 7800X3D を Amazon.co.jp で見る
- AMD Ryzen 7 9800X3D を Amazon.co.jp で見る
- DDR5-6000 64GB (32GB×2) キット を Amazon.co.jp で見る
モデル倉庫用 NVMe SSD
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート