Mac MLX LoRA ファインチューニング ガイド 2026
Mac の MLX-LM で LoRA を回す手順と、Mac mini M4 16GB で 3B・8B(4bit)を学習した秒/iter とピークメモリの実測。
- #Mac
- #MLX
- #MLX-LM
- #LoRA
- #QLoRA
- #ファインチューニング
- #Apple Silicon
- #Mac mini M4
- #16GB
- #ローカルLLM
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
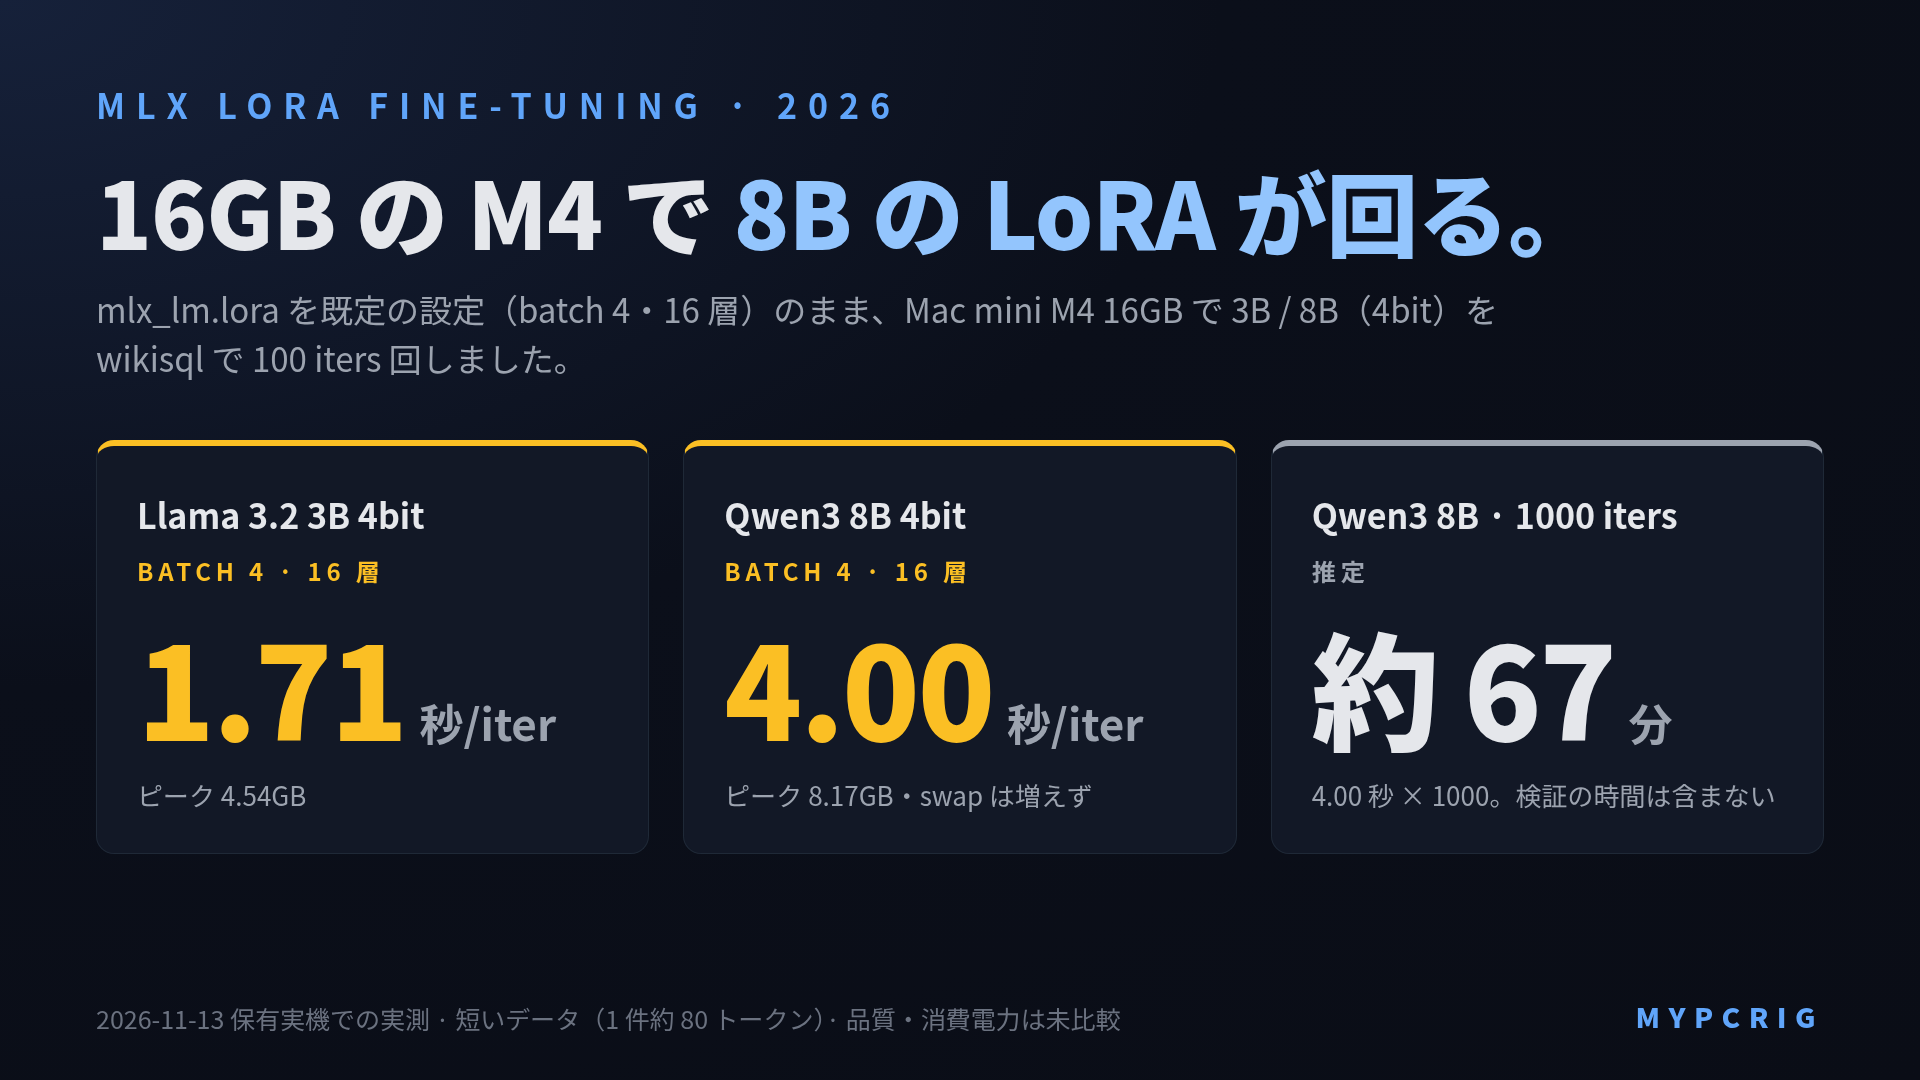
結論。Mac で自分の日本語データを LLM に Fine-tune したいなら、現実解は MLX-LM の mlx_lm.lora です。私の Mac mini M4 16GB で試したところ、4bit の Qwen3 8B は既定の設定(batch 4、16 層)のまま LoRA が回り、ピークメモリは 8.17GB、1 iter 4.00 秒でした(1 件約 80 トークンの短いデータ)。14B 以上は測っていませんが、モデルが大きくなるほど必要なメモリは増えるので、32B や 70B を LoRA するなら 64GB 以上、96GB 以上の構成が目安になります。Unsloth は README で macOS 対応を掲げていますが、私は Mac で試していません。bitsandbytes は Metal 非対応なので、ここでは Apple が開発する MLX-LM を扱います。本記事は MLX-LM の mlx_lm.lora コマンドの使い方、JSONL データセットの作り方、Mac mini M4 16GB での私の実測と Unified Memory の目安、学習済みアダプタの推論反映 (mlx_lm.generate --adapter-path / mlx_lm.fuse) までを集約します。
「Mac で LLM を動かせるようになったから、次は自分のデータで Fine-tune したい」。Mac Studio M4 Max や M3 Ultra、MacBook Pro M4 Max 128GB を手に入れた読者の次の壁がここです。Search Console でも mlx lora mac lora ファインチューニング mlx-lm fine tune といったクエリが継続して表示されており、推論側の MLX は分かったけれど Fine-tune 側の手順にたどり着けていない状況が見えます。この記事は、推論機として Mac を使っている人が最初の LoRA Fine-tune を回すまでの実行手順を整理します。数値の出典は、私が持つ Mac mini M4 16GB での実測と MLX-LM の公式ドキュメント(LORA.md)です。14B 以上や M4 Max などの値は測っておらず、目安として書いています。
推論フレームワークとしての MLX と llama.cpp の違いは「MLX と GGUF の違い:Mac LLM 2026」で扱っています。本記事はその続編にあたり、学習側の MLX-LM に絞ります。
Mac で Fine-tune する道具:MLX-LM
まず前提を確認します。Mac (Apple Silicon) で LoRA / QLoRA を回す道具として、この記事では MLX-LM を使います。ほかの道具の Mac 対応は次のとおりです。
| ツール | Mac 対応 | 備考 |
|---|---|---|
MLX-LM (mlx_lm.lora) | ◎ | Apple 公式。Apple Silicon の Unified Memory をそのまま使う |
| Unsloth | △ | README は macOS 対応と MLX モデルの学習を挙げている。私は Mac で試していない |
| Axolotl | △ | 内部で bitsandbytes や DeepSpeed に依存。Mac では動かない構成が多数 |
| Hugging Face PEFT + Transformers | △ | 動作はするが MPS バックエンドで遅く、量子化 (bitsandbytes) が効かない |
| llama.cpp | × | 推論専用。LoRA 学習コマンドは持たない |
bitsandbytes が NVIDIA 専用で動かないため、消費者向け GPU で定番の QLoRA (4bit 量子化 + LoRA) を Mac でそのまま再現することはできません。Mac では 「MLX 側で量子化されたモデルに対して LoRA アダプタを当てる」 方式になります。MLX-LM の mlx_lm.lora コマンドが --model に 4bit 量子化済みの MLX モデル (例: mlx-community/Llama-3.1-8B-Instruct-4bit) を受け取るとき、これが Mac における実質的な QLoRA 相当です。
MLX-LM のソースと使い方は ml-explore/mlx-lm (旧 mlx-examples/lora) の LORA.md に全部書いてあります。本記事はその README を Mac の購入判断・運用判断と結びつけて整理するガイドです。
mlx_lm.lora の基本構文
mlx_lm パッケージを入れると mlx_lm.lora が CLI として使えるようになります。
pip install -U mlx-lmLoRA Fine-tune の最小コマンドはこの形です。
mlx_lm.lora \
  --model mlx-community/Llama-3.1-8B-Instruct-4bit \
  --train \
  --data ./data \
  --iters 1000 \
  --batch-size 2 \
  --learning-rate 1e-5 \
  --adapter-path ./adapters
主要オプション:
--model: Hugging Face の MLX 対応リポ (mlx-community/*が標準) またはローカルの MLX 形式ディレクトリ--train: 学習モードに入る。省略すると評価のみ--data: 学習データのディレクトリ。中にtrain.jsonlとvalid.jsonlを置く--iters: 学習イテレーション数。Fine-tune のスケール感は 500〜3000 が目安--batch-size: バッチサイズ。既定は 4。Mac mini M4 16GB では 8B の 4bit モデルも既定の 4 のまま回りました(下の実測)--learning-rate: 1e-5 が MLX-LM の README デフォルト--adapter-path: 学習後のアダプタ重みを書き出す先--num-layers: LoRA を当てる層の数 (デフォルト 16)。大きくすると表現力が上がるがメモリも増える--steps-per-eval: 検証損失の出力間隔 (デフォルト 200 イテレーション)
デフォルトでは MLX-LM は最後の 16 層のすべての線形層(self_attn.q_proj / k_proj / v_proj / o_proj と mlp.gate_proj / up_proj / down_proj)に LoRA を当てます。対象を絞りたい場合 (例: q_proj と v_proj のみ) は YAML 設定ファイルの lora_parameters.keys を書き換えて指定します。--fine-tune-type は lora (デフォルト) / dora / full から選択できる別軸のオプションで、ここでは手法を選びます。YAML の形式は MLX-LM のリポジトリの examples/lora_config.yaml が参照実装です。
学習データの JSONL フォーマット
MLX-LM が受け付ける JSONL は、chat テンプレート型と completions 型の 2 系統です。
chat テンプレート型:
{"messages": [{"role": "user", "content": "鎌倉で紅葉がきれいな寺は?"}, {"role": "assistant", "content": "長谷寺の散策路と、建長寺の総門周辺が特に紅葉の名所です。"}]}completions 型:
{"prompt": "鎌倉で紅葉がきれいな寺は?", "completion": "長谷寺の散策路と、建長寺の総門周辺が特に紅葉の名所です。"}data/train.jsonl と data/valid.jsonl に 1 行 1 サンプルで並べれば読み込まれます。chat テンプレート型を使うとベースモデルのトークナイザが持つ chat テンプレートが自動適用されるため、Llama 3 / Qwen 2.5 系のインストラクトモデルに対して Fine-tune する場合はこちらが素直です。
Hugging Face datasets からの変換は Python 数行で済みます。
from datasets import load_dataset
import json

ds = load_dataset("your-dataset", split="train")
with open("data/train.jsonl", "w") as f:
    for row in ds:
        rec = {"messages": [
            {"role": "user", "content": row["instruction"]},
            {"role": "assistant", "content": row["output"]}
        ]}
        f.write(json.dumps(rec, ensure_ascii=False) + "\n")
日本語データでの注意点は 2 つ。1 つ目はトークナイザの挙動差で、Llama 3 系と Qwen 2.5 系では日本語 1 文あたりのトークン数が異なります (Qwen 2.5 のほうが日本語トークナイズが効率的で、同じ文でもトークン数が 2〜3 割少ない傾向)。2 つ目は長文データでの max_seq_length 設定で、デフォルト 2048 を超える場合は YAML で明示する必要があります。
私の Mac mini M4 16GB で 3B と 8B を LoRA した実測
条件:2026-11-13、Mac mini M4 16GB(GPU 10 コア、macOS 27.2)、mlx-lm 0.32.2 / mlx 0.32.4。モデルは mlx-community/Llama-3.2-3B-Instruct-4bit と mlx-community/Qwen3-8B-4bit。データは mlx-community/wikisql(英語の質問から SQL を作る公開データ、train 1,000 件、1 件約 80 トークン)で、100 iters 回しました。学習率 1e-5 と --max-seq-length 2048 は既定のまま、検証は最初と最後に 5 バッチです。指定は次のコマンドと同じです(実際は 10 iters ごとの値を記録するため、Python から同じ引数で呼びました)。
mlx_lm.lora --model mlx-community/Qwen3-8B-4bit --train --data ./data/wikisql \
  --iters 100 --batch-size 4 --num-layers 16 --steps-per-report 10 \
  --steps-per-eval 1000 --val-batches 5 --seed 0
秒/iter とトークン/秒は、10 iters ごとに出る報告 10 回の平均です(検証の時間は含みません)。ピークは mx.get_peak_memory() の値、メモリの空きは memory_pressure の空き率、swap は vm_stat の書き出し(Swapouts)で見ました。
| モデル | batch | LoRA を当てる層 | 秒/iter | トークン/秒 | ピーク | 学習するパラメータ | 検証損失(最初 → 最後) | 100 iters の所要 |
|---|---|---|---|---|---|---|---|---|
| Llama 3.2 3B 4bit | 4(既定) | 16(既定) | 1.71 | 186 | 4.54GB | 6.9M(0.216%) | 2.989 → 1.349 | 182 秒 |
| Llama 3.2 3B 4bit | 1 | 8 | 0.34 | 247 | 2.49GB | 3.5M | 3.221 → 1.378 | 37 秒 |
| Qwen3 8B 4bit | 4(既定) | 16(既定) | 4.00 | 90 | 8.17GB | 9.7M(0.118%) | 2.923 → 1.094 | 429 秒 |
| Qwen3 8B 4bit | 1 | 8 | 0.80 | 117 | 5.56GB | 4.9M | 3.065 → 1.129 | 87 秒 |
既定の batch 4、16 層のままで、3B も 8B も 16GB の Mac で回りました。メモリが足りずに設定を下げる必要はなく、batch 1、8 層の行は比べるために測ったものです。8B を既定で回したときも空き率は最小 31% で、swap の書き出しは増えていません。
batch 1 は 1 iter で見る件数が 4 分の 1 なので、秒/iter が小さいのは当然です。ただ 1 件あたりに直しても batch 1 のほうが速く、3B では batch 4 が 1.71 / 4 = 0.43 秒/件、batch 1 が 0.34 秒/件でした(8B は 1.00 対 0.80 秒/件)。長さの違う例を 4 件まとめると詰め物(パディング)が増えるためと見ていますが、確かめてはいません。
この結果の範囲は次のとおりです。
- wikisql は 1 件が短いデータです。長い文章で学習するとピークはこれより大きくなります。長い文章、
--grad-checkpoint、--max-seq-lengthを変えた場合は測っていません - 学習後のモデルの品質と、日本語のデータでの学習は見ていません
- 消費電力・温度は測っていません
Unified Memory 要件:モデルサイズ別の目安
ここが Mac 選びで一番重要な箇所です。推論と Fine-tune では必要な Unified Memory が大きく違います。
4bit の 8B は上の実測の値です。それ以外の行は私も測っておらず、モデルの大きさから見た目安です。MLX-LM の LORA.md の “Memory Issues” 章は、メモリを減らす方法(量子化、batch を下げる、--num-layers を減らす、例を短く切る、--grad-checkpoint)を挙げていますが、モデルごとの必要量は書いていません。
| モデル | 量子化 | LoRA Fine-tune に必要な Unified Memory | 推論時の目安 | 推奨 Mac |
|---|---|---|---|---|
| 3B (Llama 3.2 3B) | 4bit | 実測ピーク 4.54GB(batch 4、16 層、短いデータ) | — | Mac mini M4 16GB で回った |
| 7B / 8B (Qwen3 8B 等) | 4bit | 実測ピーク 8.17GB(batch 4、16 層、短いデータ) | 5〜6GB | Mac mini M4 16GB で回った。長い文章で学習するなら 24GB 以上だと余裕がある(未計測) |
| 7B / 8B | bf16 (非量子化) | 24〜32GB | 16GB | MacBook Pro M4 Pro 36GB / M4 Max 48GB |
| 13B / 14B (Qwen 2.5-14B 等) | 4bit | 24〜32GB | 9〜10GB | MacBook Pro M4 Max 48GB |
| 32B (Qwen 2.5-32B 等) | 4bit | 48〜64GB | 18〜20GB | MacBook Pro M4 Max 64GB / Mac Studio M4 Max 64GB |
| 70B (Llama 3.1-70B 等) | 4bit | 96〜128GB | 40〜42GB | Mac Studio M3 Ultra 96GB / 256GB |
bf16 の 8B と 14B 以上の行は未計測の目安で、学習データの長さ、batch、LoRA rank の設定で上下します。4bit の 8B は短いデータなら 16GB で回ったので、ここを基準に、モデルの大きさに比例して増えると見て選ぶのが安全です。
Unified Memory が足りないと vm_stat の swap が増え、学習速度が急激に落ちます。macOS は Unified Memory の上限近くまで使われると swap を使い始めるため、「空いているメモリ量 - 学習用バッファ分」のマージンを 4〜8GB は残しておくのが安全です。sudo sysctl iogpu.wired_limit_mb=<値> や Python API の mx.set_wired_limit() で GPU 側に確保するメモリ上限を広げられますが、macOS のプロセス全体の圧迫につながるため、無理に伸ばさず 「上位モデルの Unified Memory を買う」 のが結局一番効きます。
PC 側 (NVIDIA / AMD) で LoRA / QLoRA を回す場合の構成は「ローカルLLM ファインチューニング向けPC構成ガイド 2026年版」で VRAM 要件と合わせて整理しています。LoRA / QLoRA / DPO / SFT の手法そのものの違いは「LoRA / QLoRA / DPO / SFT ファインチューニング手法の違い」を参照してください。
学習時間の体感:Mac で 1 回の Fine-tune にどれくらいかかるか
学習時間は「イテレーション数 × 1 イテレーションあたりの秒数」で決まります。上の Mac mini M4 16GB の実測(100 iters)から、1000 iters の時間を推定しました。
| モデル (4bit MLX) | Mac | 秒/iter(実測) | 100 iters の所要(実測、検証込み) | 1000 iters の総時間(推定) |
|---|---|---|---|---|
| Llama 3.2 3B | Mac mini M4 16GB | 1.71 秒 | 182 秒 | 約 29 分(推定) |
| Qwen3 8B | Mac mini M4 16GB | 4.00 秒 | 429 秒 | 約 67 分(推定) |
1000 iters の列は、実測の秒/iter に 1000 を掛けただけの推定です(1.71 × 1000 = 1,710 秒、4.00 × 1000 = 4,000 秒)。検証の時間は入っていません。既定の --steps-per-eval は 200 なので、既定のまま回すと途中の検証のぶん長くなります。データの 1 件が長くなれば 1 iter の秒数も伸びます。
14B 以上と、M4 Pro・M4 Max・M3 Ultra は測っていません。外部の値としては、LORA.md に「32GB の M1 Max で Mistral 7B を batch 1、4 層、wikisql で回すと約 250 トークン/秒」という例があります。上の表と条件(モデル、量子化、層の数)が違うので、そのまま比べることはできません。
NVIDIA の GPU との速度の比較も、同じ条件では測っていません。Mac を選ぶ理由は速度より、大きなモデルを丸ごと Unified Memory に載せて LoRA できる点にあります。この辺りの選び分けは「Unified Memory vs NVIDIA VRAM 徹底比較 2026年版」でも整理しています。
学習済みアダプタを推論に反映する
mlx_lm.lora --train を回し終わると、--adapter-path で指定したディレクトリに adapters.safetensors と adapter_config.json が書き出されます。これを推論で使うには 2 通りあります。
方法 1: 推論時にアダプタを動的読み込み
mlx_lm.generate \
  --model mlx-community/Llama-3.1-8B-Instruct-4bit \
  --adapter-path ./adapters \
  --prompt "鎌倉で紅葉がきれいな寺は?"
ベースモデルは変えずアダプタだけ切り替えて使う運用です。複数の Fine-tune 結果を使い分けるならこちら。
方法 2: ベースモデルにマージして配布
mlx_lm.fuse \
  --model mlx-community/Llama-3.1-8B-Instruct-4bit \
  --adapter-path ./adapters \
  --save-path ./fused_model
mlx_lm.fuse でベース重みにアダプタを統合し、単一のモデルディレクトリとして吐き出します。配布や LM Studio でそのままロードしたい場合はこちら。ただし 4bit 量子化済みモデルにマージすると量子化誤差が重なるため、品質を最大化したいなら bf16 ベースでマージしてから再量子化する方法もあります。
mlx_lm.fuse の出力は Hugging Face 互換の safetensors + config.json で、Hugging Face Hub にそのままアップロードできます。自分の日本語データで Fine-tune した 8B モデルを mlx-community 以外の自分のリポに上げて、同僚の Mac から mlx_lm.generate --model you/your-model で呼べる、という配布運用もここで成立します。
Mac 側のメモリ圧迫対策
Fine-tune 中は Unified Memory がほぼ上限まで使われます。安定して回すためのチェックリスト:
vm_statで swap を監視: ターミナルでvm_stat 1を回すと 1 秒ごとに swap in/out の累積が出ます。Swap が増え始めたらバッチサイズを下げるか--num-layersを減らしますsudo powermetricsで GPU 使用率を見る: Fine-tune 中 GPU 使用率が 100% に張り付かない場合、I/O 待ちか CPU 側のデータローダがボトルネックです。--grad-checkpointを外す、データセットを事前ロードする等で改善しますiogpu.wired_limit_mbの設定: デフォルトでは Apple のドライバが Unified Memory のうち GPU に割り当てられる量を制限しています。128GB マシンでも GPU 側に 96GB 程度しか回らない設定が多いです。sudo sysctl iogpu.wired_limit_mb=118000のように明示的に広げると 70B LoRA が通ります (macOS 15 以降では Python API のmx.set_wired_limit()でも同等の制御が可能)。ただし macOS 本体のメモリも食うため、残量が常に 4GB 以上あるか監視が必要です- バッチサイズ 1 +
--grad-checkpoint: Unified Memory ギリギリの構成では、バッチサイズ 1 と勾配チェックポイントの併用で成立するレンジが広がります。学習は遅くなりますが落ちません - 学習用データは外付け SSD に逃がす: データセット本体と
adapter-pathを Thunderbolt 5 の外付け NVMe に置けば、内蔵 SSD の寿命を節約でき、学習ジョブを停止・再開する運用がしやすくなります。外付け SSD の選び方は「Mac 外付け SSD 選び方 Thunderbolt / USB4 2026年版」を参照してください
これらを組み合わせると、Unified Memory を公称値の 80〜90% まで学習側に回しつつ、swap を抑えて安定稼働する領域に入ります。
どの Mac を買えば Fine-tune できるか:購入判断
MLX LoRA の Fine-tune 用途で Mac を選ぶときの指針を、必要モデルサイズ別に整理します。
| やりたいこと | 必要 Unified Memory | 推奨 Mac |
|---|---|---|
| 8B 系 (Qwen3 8B / Llama 3.1 8B) の 4bit を自分のデータで LoRA したい | 16GB〜(短いデータで実測)。長い文章なら 24GB 以上が安心(未計測) | Mac mini M4 16GB で回った / 長い文章なら MacBook Pro 14 M4 Pro 24GB 以上 |
| 14B〜32B クラスを LoRA したい (日本語応答の精度を上げたい) | 64GB〜96GB | MacBook Pro 14/16 M4 Max 64GB / Mac Studio M4 Max 64GB |
| 70B クラスを LoRA したい (本格的な専門領域特化) | 128GB〜 | MacBook Pro 16 M4 Max 128GB / Mac Studio M3 Ultra 256GB |
| 70B を LoRA + 複数実験を並列したい | 192GB〜 | Mac Studio M3 Ultra 256GB / 512GB |
Unified Memory を「推論用の大きさ」で選んでしまうと Fine-tune 時に一段上のモデルに手が届かない、という構図が起きやすいです。Mac mini M4 16GB の実測では、Qwen3 8B 4bit のモデルのファイルは約 4.6GB で、LoRA のピークは 8.17GB、約 1.8 倍でした(短いデータ)。長い文章のデータではこの倍率が上がるので、「推論もしたいが Fine-tune も試したい」なら、推論で狙うモデルより一段多めに Unified Memory を見ておくと詰まりにくくなります。
推論側の Mac Studio ガイドは「Mac Studio ローカル LLM 運用ガイド 2026年版」、Unified Memory そのものの決め方は「Mac Unified Memory 何GB 必要か 2026年版」で扱っています。
まとめ:Mac で Fine-tune できることが購入理由を 1 段引き上げる
Mac で LoRA / QLoRA を回すなら、まず MLX-LM の mlx_lm.lora を試すのが近道です。4bit の 8B なら 16GB の Mac mini M4 でも既定の設定で回り、1 iter 4.00 秒、ピーク 8.17GB でした(短いデータ)。32B クラスなら 64〜128GB、70B クラスなら M3 Ultra 96GB / 256GB が目安です(未計測)。70B を丸ごと Unified Memory に載せて LoRA できる点が Mac の優位性で、ここに価値を感じるなら M3 Ultra の高額機も選択肢に入ります。
「推論できるから Mac」から「Fine-tune できるから Mac」へ購入理由を引き上げる 1 本の記事として、本記事と関連記事を併せて購入判断に使ってもらえればと思います。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。Mac Studio 本体は Amazon.co.jp の新品流通が細いため Apple 公式を併記します。公式リンクからは紹介料が発生しません。
Mac 本体(MLX LoRA 向けの主要構成)
- MacBook Pro 16 M4 Max 64GB 2TB を Amazon.co.jp で見る(14〜32B クラス LoRA の主力構成)
- MacBook Pro 16 M5 Max 128GB を Amazon.co.jp で見る(70B クラスまで視野に入る構成)
- Mac Studio M3 Ultra を Apple 公式サイトで見る(Amazon.co.jp の新品流通が細いため公式を案内。紹介料は発生しません)
学習データ・アダプタ保存用の外付け SSD(Thunderbolt 5 / USB4)
- Samsung T9 4TB を Amazon.co.jp で見る(学習データ・アダプタ・fuse 済みモデルの退避先)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- MLX と GGUF の違い:Mac LLM 2026 — 推論側の MLX / llama.cpp 使い分け
- Mac Studio ローカル LLM 運用ガイド 2026年版 — 推論機としての Mac Studio 選び方
- LoRA / QLoRA / DPO / SFT ファインチューニング手法の違い — 手法そのものの比較
- ローカルLLM ファインチューニング向けPC構成ガイド 2026年版 — PC 側 (NVIDIA / AMD) で LoRA を回す場合の VRAM 要件
- Mac Unified Memory 何GB 必要か 2026年版 — Fine-tune を見据えた Unified Memory の決め方