ollama API 使い方ガイド 2026 Python 連携
ollama API の使い方を 2026 年版で整理。Python / REST / OpenAI 互換・tool calling の例をまとめます。
- #ollama
- #API
- #Python
- #REST
- #OpenAI 互換
- #tool calling
- #ローカルLLM
- #AI開発
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
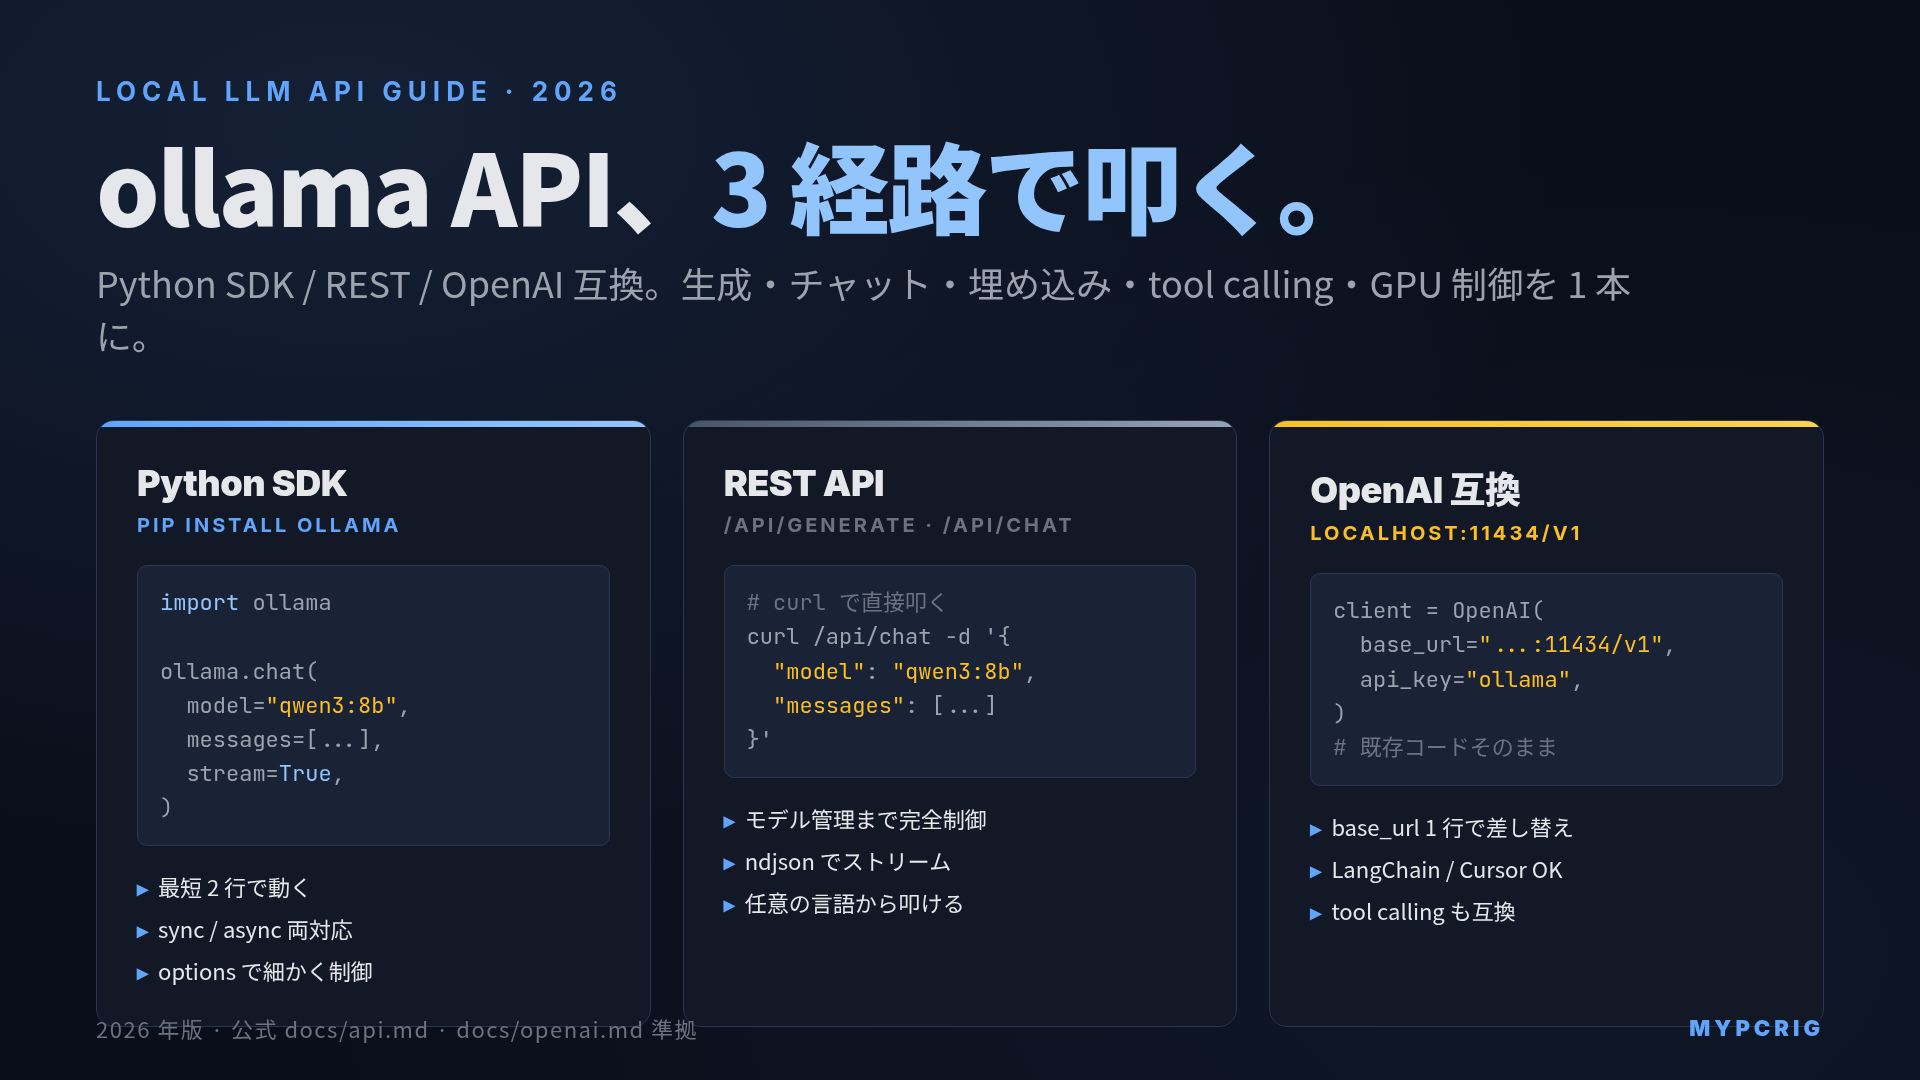
結論: ollama API は Python SDK(pip install ollama)/ REST(/api/generate・/api/chat)/ OpenAI 互換(http://localhost:11434/v1)の 3 経路でほぼ同じことができます。最初に動かすなら Python SDK、既存アプリに差し込むなら OpenAI 互換、仕組みを把握したいなら REST を素で叩くのが最短です。本記事は、2026 年版の公式ドキュメントに沿って、生成・チャット・埋め込み・tool calling・ストリーミング・GPU 制御・エラー対処までを一枚にまとめます。
ollama は「ローカルLLM を 1 コマンドで動かせる」ところまでは広く知られています。API を使って自分のコード・エージェント・エディタと繋ごうとすると「どのエンドポイントが何用で、OpenAI 互換はどこまで動くのか」が散らばっていて迷いやすい領域です。公式ドキュメントは https://github.com/ollama/ollama/blob/main/docs/api.md に 1 本、OpenAI 互換は別ファイル https://github.com/ollama/ollama/blob/main/docs/api/openai-compatibility.mdx に分かれています。Python SDK は https://github.com/ollama/ollama-python に、JS SDK は https://github.com/ollama/ollama-js にそれぞれあります。本記事はこの 4 本を横串で読める形に整理したものです。中身の違い(llama.cpp vs ollama)が気になる場合は、先に Ollama と llama.cpp の違い 2026年版 を押さえておくと設計判断がブレません。
結論表: どの用途でどのエンドポイントが使いやすいか
Python SDK / curl REST / OpenAI 互換の 3 経路について、代表的な用途ごとの向き不向きを並べます。基準は実装の素直さと互換範囲の広さです。速度の数値比較ではありません。
| 用途 | Python SDK (ollama) | REST (/api/*) | OpenAI 互換 (/v1/*) |
|---|---|---|---|
| テキスト生成(1 発) | ◎ 2 行で動く | ○ curl で確認 | ○ 既存アプリと互換 |
| チャット(履歴あり) | ◎ messages=[...] | ○ /api/chat | ◎ 本家と同構造 |
| ストリーミング | ◎ stream=True | ○ ndjson parse | ○ SSE 互換 |
| 埋め込み(embedding) | ◎ embed() | ○ /api/embed | ◎ /v1/embeddings |
| tool calling | ◎ tools=[...] | ○ /api/chat tools | ◎ /v1/chat/completions tools |
| モデル一覧・状態 | ○ list() / ps() | ◎ /api/tags / /api/ps | △ 本家に無い |
| モデル pull / 削除 | ○ pull() / delete() | ◎ /api/pull / /api/delete | △ 本家に無い |
| 既存 OpenAI コードに差し替え | △ 書き換え必要 | △ 書き換え必要 | ◎ base_url 1 行 |
Python SDK は書き味がいちばん軽いです。REST はモデル管理まで含めた完全な制御ができます。OpenAI 互換は既存コード資産との互換性が強みです。
実装では複数を混ぜて使うのが普通で、たとえば「モデル管理は REST、推論は OpenAI 互換」といった組み合わせがよくあります。
ollama API エンドポイント一覧(2026 年版)
公式 docs/api.md に定義されているエンドポイントのうち、実運用で触る頻度が高い 8 本を並べます。すべて http://localhost:11434 が既定のベース URL です。デフォルトは認証無しです。
| エンドポイント | メソッド | 用途 |
|---|---|---|
/api/generate | POST | 単発のテキスト生成(履歴なし) |
/api/chat | POST | チャット形式(履歴あり・tool calling 対応) |
/api/embed | POST | ベクトル埋め込み(RAG 用途) |
/api/tags | GET | インストール済みモデル一覧 |
/api/show | POST | モデルの詳細(Modelfile / パラメータ数 / コンテキスト長) |
/api/pull | POST | モデルのダウンロード(進捗を ndjson で返す) |
/api/delete | DELETE | モデルの削除 |
/api/ps | GET | 現在ロード中のモデルと VRAM / GPU 使用状況 |
このほか /api/create(Modelfile からの新規モデル生成)、/api/copy(モデル複製)、/api/version もあります。全仕様は https://github.com/ollama/ollama/blob/main/docs/api.md を一次情報として参照してください。
Python クライアントの基本例
Python SDK は pip install ollama でインストールします。
公式リポジトリは https://github.com/ollama/ollama-python で、同期・非同期・ストリーミング・tool calling のすべてをカバーしています。
テキスト生成(1 発)
import ollama

response = ollama.generate(
    model="qwen3:8b",
    prompt="日本の首都は?一文で答えて。",
)
print(response["response"])
チャット(履歴あり)
import ollama

messages = [
    {"role": "system", "content": "あなたは簡潔に答えるアシスタントです。"},
    {"role": "user", "content": "ローカルLLM で RAG を構築する時のポイントは?"},
]

response = ollama.chat(model="qwen3:8b", messages=messages)
print(response["message"]["content"])
ストリーミング
対話 UI で tok/sec の体感を保ちたい場合は、stream=True でトークン単位の yield を受け取ります。
import ollama

for chunk in ollama.chat(
    model="qwen3:8b",
    messages=[{"role": "user", "content": "量子化の仕組みを 3 行で。"}],
    stream=True,
):
    print(chunk["message"]["content"], end="", flush=True)
options による細かい制御
生成品質・速度のチューニングには options を渡します。
主要パラメータは num_ctx(コンテキスト長)、num_gpu(GPU レイヤー数)、num_thread(CPU スレッド数)、temperature、seed、num_batch、repeat_penalty などです。コンテキスト長が黙って切り捨てられる挙動は ollama の既知の落とし穴で、長文を扱うなら num_ctx を明示するのが鉄則です。
import ollama

response = ollama.chat(
    model="qwen3:8b",
    messages=[{"role": "user", "content": "長文..."}],
    options={
        "num_ctx": 32768,
        "num_gpu": 999,          # 可能な限り全層を GPU に載せる
        "temperature": 0.2,
        "seed": 42,
    },
)
num_gpu=999 は「可能な限り全層を GPU に載せる」挙動です。ollama 側が VRAM に収まる最大枚数を自動で決めます。VRAM ギリギリで CPU オフロードを避けたい場合は、ここを明示的な数値(モデル総層数以上)に設定します。
REST API を curl で叩く例
Python 以外から叩く・CI で動作確認する・レスポンスの実物を見たい場合は curl が最短です。
/api/generate
curl -s http://localhost:11434/api/generate -d '{
  "model": "qwen3:8b",
  "prompt": "日本の首都は?一文で。",
  "stream": false
}' | jq .response
stream: false を指定しないと ndjson(1 行 1 JSON オブジェクト)がストリーミングで返ってきます。パイプラインから使うなら jq -s でまとめて受けるか、stream: false でまとめて受け取るのが実装が楽です。
/api/chat with ストリーミング
curl -s http://localhost:11434/api/chat -d '{
  "model": "qwen3:8b",
  "messages": [
    {"role": "user", "content": "RAG のポイントを 2 行で。"}
  ]
}' | while IFS= read -r line; do
  echo "$line" | jq -r '.message.content // empty'
done
ndjson の 1 行ずつに message.content が入り、最終行には done: true と eval_count / eval_duration が含まれます。
tok/sec は eval_count / (eval_duration / 1e9) で計算できます。
/api/embed
RAG 用途の埋め込みは /api/embed を叩きます。
モデルは nomic-embed-text や mxbai-embed-large など埋め込み専用モデルを選びます。
curl -s http://localhost:11434/api/embed -d '{
  "model": "nomic-embed-text",
  "input": ["ローカルLLM で RAG を構築する"]
}' | jq '.embeddings[0] | length'
長さが 768 や 1024 の数値配列が返ります。そのままベクトル DB(Qdrant / Chroma / pgvector 等)に突っ込めます。埋め込みモデルの選び方は ローカルLLM 埋め込みモデル比較 2026年版 を参照してください。
OpenAI 互換エンドポイント
ollama は http://localhost:11434/v1 配下に OpenAI 本家互換のエンドポイントを持ちます。既存の OpenAI SDK や LangChain / LiteLLM / Cursor は、base_url を書き換えるだけでそのまま使えます。公式ドキュメントは https://github.com/ollama/ollama/blob/main/docs/api/openai-compatibility.mdx にあります。
OpenAI SDK(Python)から叩く
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # 任意の文字列で OK(ollama 本家は認証無し)
)

resp = client.chat.completions.create(
    model="qwen3:8b",
    messages=[{"role": "user", "content": "一文で自己紹介して。"}],
)
print(resp.choices[0].message.content)
OpenAI 本家の SDK がそのまま動くため、「OpenAI 本番 → ollama ローカル」の切り替えが環境変数 1 本で済むのが最大の利点です。Cursor / Continue.dev / Open WebUI などのクライアントも、base_url 書き換えで ollama を裏に挿せます。
クライアント UI 側の選び方は ローカルLLM チャット UI 比較 2026年版(Open WebUI / LibreChat ほか) にまとめています。
互換範囲と非対応機能
OpenAI 互換は便利ですが、本家にあって ollama に無い機能・挙動差があるので、本番で切り替える前に自分のユースケースで通し検証するのが安全です。
| 項目 | 本家 OpenAI | ollama (/v1) |
|---|---|---|
/v1/chat/completions | ◎ | ◎ |
/v1/completions | ◎ | ◎ |
/v1/embeddings | ◎ | ◎ |
/v1/models | ◎ | ◎ |
| tool calling / function calling | ◎ | ○(モデル依存) |
| streaming(SSE) | ◎ | ◎ |
response_format (JSON) | ◎ | ○(部分互換) |
logprobs 詳細 | ◎ | ✕ 非対応 |
seed の完全一致再現 | ○ | △ ランタイム差 |
| 画像入力(vision) | ◎ | ○(base64 推奨) |
| 音声系(Whisper / TTS) | ◎ | ○ STT・TTS とも対応(/v1/audio/speech と /v1/audio/transcriptions は Ollama v0.40.8〜、/v1/audio/translations は v0.40.12〜。対応モデルは限定) |
実務で引っかかりやすいのは seed の完全一致です。ollama 側は llama.cpp / MLX のバージョンや GPU レイヤー配分によって再現性が揺れます。本家 OpenAI 相当の決定性を求める場合は、温度 0 + top_k=1 を併用した上で、同一マシン同一モデル同一バイナリでしか比較しない運用に留めるのが現実的です。
tool calling(関数呼び出し)の実装例
2026 年版の ollama は tool calling(function calling)を /api/chat と /v1/chat/completions の両方で扱えます。モデル側が tool を学習しているかに依存し、Qwen 3 系 / Llama 4 系 / gpt-oss / mistral-nemo / command-r-plus などが対応します。tool calling 全般の概念は ローカルLLM の関数呼び出し / tool use ガイド 2026年版 に別記事があります。
Python SDK から tool を渡す
import ollama

def get_weather(city: str) -> str:
    # ここに実際の天気 API 呼び出しを書く
    return f"{city} は晴れ、気温 22 度"

tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "指定した都市の現在の天気を返す",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "都市名"},
                },
                "required": ["city"],
            },
        },
    }
]

response = ollama.chat(
    model="qwen3:8b",
    messages=[{"role": "user", "content": "東京の天気は?"}],
    tools=tools,
)

tool_calls = response["message"].get("tool_calls", [])
for tc in tool_calls:
    name = tc["function"]["name"]
    args = tc["function"]["arguments"]
    if name == "get_weather":
        result = get_weather(**args)
print(result)モデルがツールを呼ぶべきと判断すると、message.tool_calls に関数名と引数が JSON で返ります。実際の関数実行はクライアント側で行い、その結果を role: "tool" で再度 messages に積んで ollama.chat() を呼び直す、というループを組むのが基本パターンです。
MCP サーバーと組み合わせたい場合は ローカルLLM MCP サーバー構築ガイド 2026年版 に流れが整理されています。
GPU 制御の勘所
ollama は起動時に GPU を自動検出します。VRAM に収まる分だけモデルをロードします。細かい制御が必要になる場面は限られます。ギリギリの構成では以下の 3 系統を押さえておきます。
環境変数(サーバー全体の挙動)
| 環境変数 | 役割 |
|---|---|
OLLAMA_HOST | バインド先。既定は 127.0.0.1:11434。LAN 公開は 0.0.0.0:11434 |
OLLAMA_NUM_PARALLEL | 1 モデルあたりの並列リクエスト数。既定 1 で、VRAM に応じて増やす |
OLLAMA_MAX_LOADED_MODELS | 同時にロードしておけるモデル数。既定は CPU 推論で 3、GPU は 3 × GPU 枚数 |
OLLAMA_FLASH_ATTENTION | 1 で Flash Attention を有効化。VRAM と速度の両面で有利 |
OLLAMA_KV_CACHE_TYPE | q8_0 / q4_0 で KV キャッシュを量子化し VRAM を節約 |
OLLAMA_KEEP_ALIVE | モデルを VRAM に保持する時間。-1 で永続、0 で即アンロード |
Flash Attention と KV キャッシュ量子化の組み合わせは、VRAM に対して効きが大きい設定です。コンテキスト長を伸ばしたときの KV キャッシュ消費を抑える仕組みは ローカルLLM の KV キャッシュ量子化ガイド 2026年版 で詳しく扱っています。
同時リクエストと OLLAMA_NUM_PARALLEL(保有実機での実測)
API をスクリプトやエージェントから並列に叩くと、OLLAMA_NUM_PARALLEL の値で速さが変わります。Ollama の FAQ のとおり既定は 1 で、増やすと必要なメモリは OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH の文脈ぶん増えます。
保有している Mac mini M4 16GB で、OLLAMA_NUM_PARALLEL を同時の本数と同じ値にして測りました(2026-11-14、Ollama 0.40.16、qwen3:8b、OLLAMA_CONTEXT_LENGTH=4096、プロンプト約 350 トークン・生成 256 トークン、各 3 回の平均)。サーバーは 127.0.0.1 で、同じ Mac から /api/generate(raw: true、ストリーミング)に同時に投げています。
| 同時の本数 | 合計 tok/s | 1 本あたり tok/s | 初トークンまで(平均) |
|---|---|---|---|
| 1 | 18.2 | 20.2 | 1.42 秒 |
| 2 | 26.5 | 15.7 | 3.12 秒 |
| 4 | 42.2 | 13.6 | 5.47 秒 |
| 8 | 61.2 | 10.6 | 8.69 秒 |
合計は 8 本で 1 本の約 3.4 倍まで伸びますが、1 本ごとの応答は遅くなり、初トークンまでの待ちも伸びます。バッチで大量に回すなら本数を増やすほど得で、チャットの応答性を守りたいなら 2〜4 本に抑えるのが目安です。比較のため RTX 4070 12GB で llama-server(同じ 8B の Q4_K_M、-np 8)を測ると、8 本で合計 356 tok/s、初トークンまで 0.66 秒でした(4070 の Ollama は測っていません)。並列処理の仕組みは「Continuous Batching / PagedAttention とは」で扱っています。
API の options.num_gpu(リクエスト単位)
/api/generate と /api/chat の options.num_gpu に数値を渡すと、何層を GPU に載せるかをリクエスト単位で指定できます。
999 を渡すと「可能な限り全層を GPU に」の意味で、VRAM に収まる最大枚数を ollama 側が自動で決めます。
/api/ps でロード状態を確認
curl -s http://localhost:11434/api/ps | jqレスポンスにはロード中のモデル名、総パラメータサイズ、現在の VRAM 使用量、GPU/CPU の分配比が含まれます。
思ったほど GPU が使われていないときは、まずここで実際のロード状況を見るのが早道です。
パフォーマンスチューニングの基本
Flash Attention と KV キャッシュ量子化
公開ベンチの集約で、OLLAMA_FLASH_ATTENTION=1 と OLLAMA_KV_CACHE_TYPE=q8_0 の併用は、同一モデルで KV キャッシュの VRAM 消費を体感約半分に抑える報告が多数あります。これにより num_ctx を伸ばせたり、ギリギリで CPU オフロードになっていた層を VRAM に押し戻せたりします。
num_ctx の明示
ollama のデフォルト num_ctx は 2048〜4096 と控えめです。長いプロンプトを渡すと黙って先頭が切り捨てられるのが落とし穴です。長文処理では必ず options.num_ctx を明示的に指定し、同時に /api/show でモデル側の最大コンテキスト長を確認しておきます。
num_batch と num_thread
CPU オフロードが混在する環境では num_thread(CPU スレッド数)が効きます。
純 GPU 推論では num_batch(デフォルト 512)を上げるとプリフィル速度が改善する場合がありますが、VRAM を食う副作用があるため、OOM と速度を見ながら 256 / 512 / 1024 を試すのが現実的です。チューニングの手触りを詳しく追いたい場合は ローカルLLM 推論を速くする llama.cpp / Ollama チューニング設定ガイド 2026年版 を参照してください。
認証とネットワーク公開
ollama 本家には認証機能が無いため、外部から叩く構成では前段を工夫します。
| 構成 | 向く用途 | 備考 |
|---|---|---|
ローカルのみ(OLLAMA_HOST=127.0.0.1:11434) | 自分の PC だけで使う | デフォルトで安全 |
| Tailscale | 自宅・会社 PC 間で共有 | もっとも手軽、暗号化込み。Mac でのサーバー化手順 |
| Caddy / nginx + Basic 認証 | LAN 内の 1〜数名で共有 | HTTPS 化もついでに済む |
| Cloudflare Tunnel | 外出先からも叩きたい | 公開 IP 不要、認証と組み合わせやすい |
| LiteLLM 前段 | 複数バックエンドを統合したい | API キー発行・レートリミット・課金風ログまで一括。LiteLLM API ゲートウェイガイド |
本番運用では LiteLLM を前段に置く構成が、認証・ログ・OpenAI 互換 API を同時に満たせます。もっとも実用的です。
エラー対処: よく出るパターン
実運用で遭遇する頻度が高いエラーと、原因・対策の対応を並べます。
| エラー | 典型的な原因 | 対策 |
|---|---|---|
model not found | モデル未取得 or 名前タイポ | ollama pull <name> で取得、ollama list で正確な名前を確認 |
request timeout | 大モデル初回ロード or プリフィル長 | OLLAMA_LOAD_TIMEOUT を伸ばす、OLLAMA_KEEP_ALIVE=-1 で常駐 |
context length exceeded | num_ctx を超えるプロンプト | モデル側の最大 ctx を確認、num_ctx を上げる or プロンプト圧縮 |
out of memory | VRAM 不足 | num_gpu を減らす、KV キャッシュ量子化、より小さい量子化(Q4)に変更 |
connection refused | ollama 未起動 or ホスト違い | ollama serve 起動、OLLAMA_HOST と curl 先が一致しているか確認 |
tool call parse error | モデルの JSON 出力が崩れた | 対応モデル(Qwen3 / Llama4 / gpt-oss 等)に変更、プロンプトで JSON のみ出力を強制 |
落とし穴: 本家 OpenAI と微妙に挙動が違う 3 点
OpenAI 互換で動かすときに、本家との差で引っかかりやすい点を 3 つに絞って並べます。
seedの決定性: OpenAI 互換のseedは ollama 側のランタイム(llama.cpp / MLX)・バージョン・GPU レイヤー配分で結果が揺れます。本家相当の決定性は期待しないほうが安全ですstopの挙動差: 複数のstop文字列を渡したとき、本家は配列内のどれかで停止しますが、ollama 側は最長一致を優先する実装差があります。長めの stop は 1 本に絞るのが安全です/api/generateと/api/chatのレスポンス形状:generateはresponse直下にテキスト、chatはmessage.content配下にテキスト、と形が違います。両方を切り替えるコードは、レスポンス取り出しを薄いラッパー関数にまとめておくと移植が楽です
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
ollama 本体はオープンソースで無料ですが、ローカルで動かすハードウェア側の相場感を参考までに並べます。本文で言及した構成に関連する代表的な 3 製品のみを掲載しています。
- GeForce RTX 5090 を Amazon.co.jp で見る — VRAM 32GB 級、70B クラスまで一枚で載せたい場合の上限
- GeForce RTX 5060 Ti 16GB を Amazon.co.jp で見る — 8B〜14B の量子化モデルを常用する価格重視の選択肢
- Mac mini M4 Pro を Apple 公式サイトで見る — ユニファイドメモリで 32GB〜48GB クラスのモデルを静音・低電力で回す Mac ローカルサーバー向け
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- ollama API は Python と REST のどちらから叩くのが良いですか?
- 最初の数行で動かすなら Python SDK(`pip install ollama`)が最短です。モデル名を渡すだけで同期・非同期・ストリーミングが揃っており、エディタの補完も効きます。REST API(`http://localhost:11434/api/generate` や `/api/chat`)は、Python 以外の言語から叩く場合、デバッグで中身を直接見たい場合、CI などで curl で叩きたい場合に向きます。既存アプリが OpenAI SDK を使っているなら、3 つめの選択肢として `base_url` を `http://localhost:11434/v1` に書き換える OpenAI 互換エンドポイントも使えます。
- ollama の OpenAI 互換 API はどこまで本家と同じですか?
- `/v1/chat/completions` / `/v1/completions` / `/v1/embeddings` の 3 本と、tool calling / streaming / 一部の `response_format` までが互換範囲です。本家 OpenAI にあって ollama に無い機能として、`logprobs` の詳細出力、`seed` の完全一致再現、一部の `stop` パラメータ、画像入力の仕様差(ollama は URL より base64 推奨)が挙げられます。音声系は `/v1/audio/speech`(TTS)が v0.40.8 以降、`/v1/audio/transcriptions`(STT)が v0.40.8 以降、`/v1/audio/translations` が v0.40.12 以降で順次対応しています(対応モデルは公式ドキュメントの `speech` capability 参照)。Cursor / LangChain / LiteLLM / Continue.dev などは `base_url` を書き換えるだけでほぼそのまま動きますが、本番で切り替える前に自分のユースケースで通し検証するのが安全です。公式仕様は `https://github.com/ollama/ollama/blob/main/docs/api/openai-compatibility.mdx` で随時更新されます。
- ollama で GPU が使われているか、どう確認しますか?
- いちばん手早いのは `ollama ps` コマンドで、ロード中モデルの GPU/CPU 比率が表示されます。API からは `/api/ps` エンドポイントで同じ情報を JSON で取れます。GPU レイヤー数を自分で制御したい場合は、`/api/generate` と `/api/chat` の `options.num_gpu` にレイヤー数を数値で渡すと、何層を GPU に載せるかを明示できます。環境変数側では `OLLAMA_FLASH_ATTENTION=1` と `OLLAMA_KV_CACHE_TYPE=q8_0` を併用すると、KV キャッシュ量子化で VRAM を体感で約半分に抑えられる計測例があり、ギリギリのモデルを VRAM に収めるときに効きます。
- tool calling(関数呼び出し)はどのモデルで使えますか?
- 2026 年版の ollama で tool calling が動く主要モデルは、Qwen 3 系(`qwen3`)、Llama 4 系(`llama4`)、`gpt-oss`、`mistral-nemo`、`command-r-plus` などです。モデル側が tool を学習しているかどうかに依存するため、ollama のモデルページで `tools` タグが付いているモデルを選びます。API 側の仕様は `/api/chat` の `tools` 配列に関数定義(JSON Schema)を渡し、モデルがツールを呼び出した場合は `message.tool_calls` に関数名と引数が入って返ります。詳細は `https://github.com/ollama/ollama/blob/main/docs/api.md` を参照してください。
- ollama を外部ネットワークから叩きたい場合、認証はどうしますか?
- ollama 本家には認証機能が無いため、前段に Caddy / nginx / Cloudflare Tunnel / Tailscale のいずれかを置くのが基本構成です。もっとも手軽なのは Tailscale で、ollama を動かすマシンに Tailscale を入れ、同じ tailnet のクライアントからだけ `http://<tailscale-ip>:11434` で叩ける構成にします。Caddy / nginx を使うなら Basic 認証 + HTTPS で `/api/*` を保護し、ollama 側は `OLLAMA_HOST=127.0.0.1:11434` でローカルバインドに留めます。LiteLLM を前段に置くと、API キー管理・レートリミット・複数バックエンドの統合まで一括でできるので、本格的に公開するなら LiteLLM 経由がもっとも実運用に近い構成です。