LiteLLM 使い方 ローカルLLM 統一API 2026年版
LiteLLM を使えば Ollama / vLLM / LM Studio / llama.cpp と OpenAI / Anthropic / Gemini API を 1 つの OpenAI 互換エンドポイントに束ねられます。Claude Code / Cursor / Cline から複数バックエンドを統一 API で叩く、LiteLLM Proxy の導入・model_list 設定・フォールバック・ローカル+クラウド併用構成を 2026 年版でまとめました。
- #LiteLLM
- #LiteLLM Proxy
- #ローカルLLM
- #OpenAI互換API
- #Ollama
- #vLLM
- #Claude Code
- #Cursor
- #Cline
- #AIゲートウェイ
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
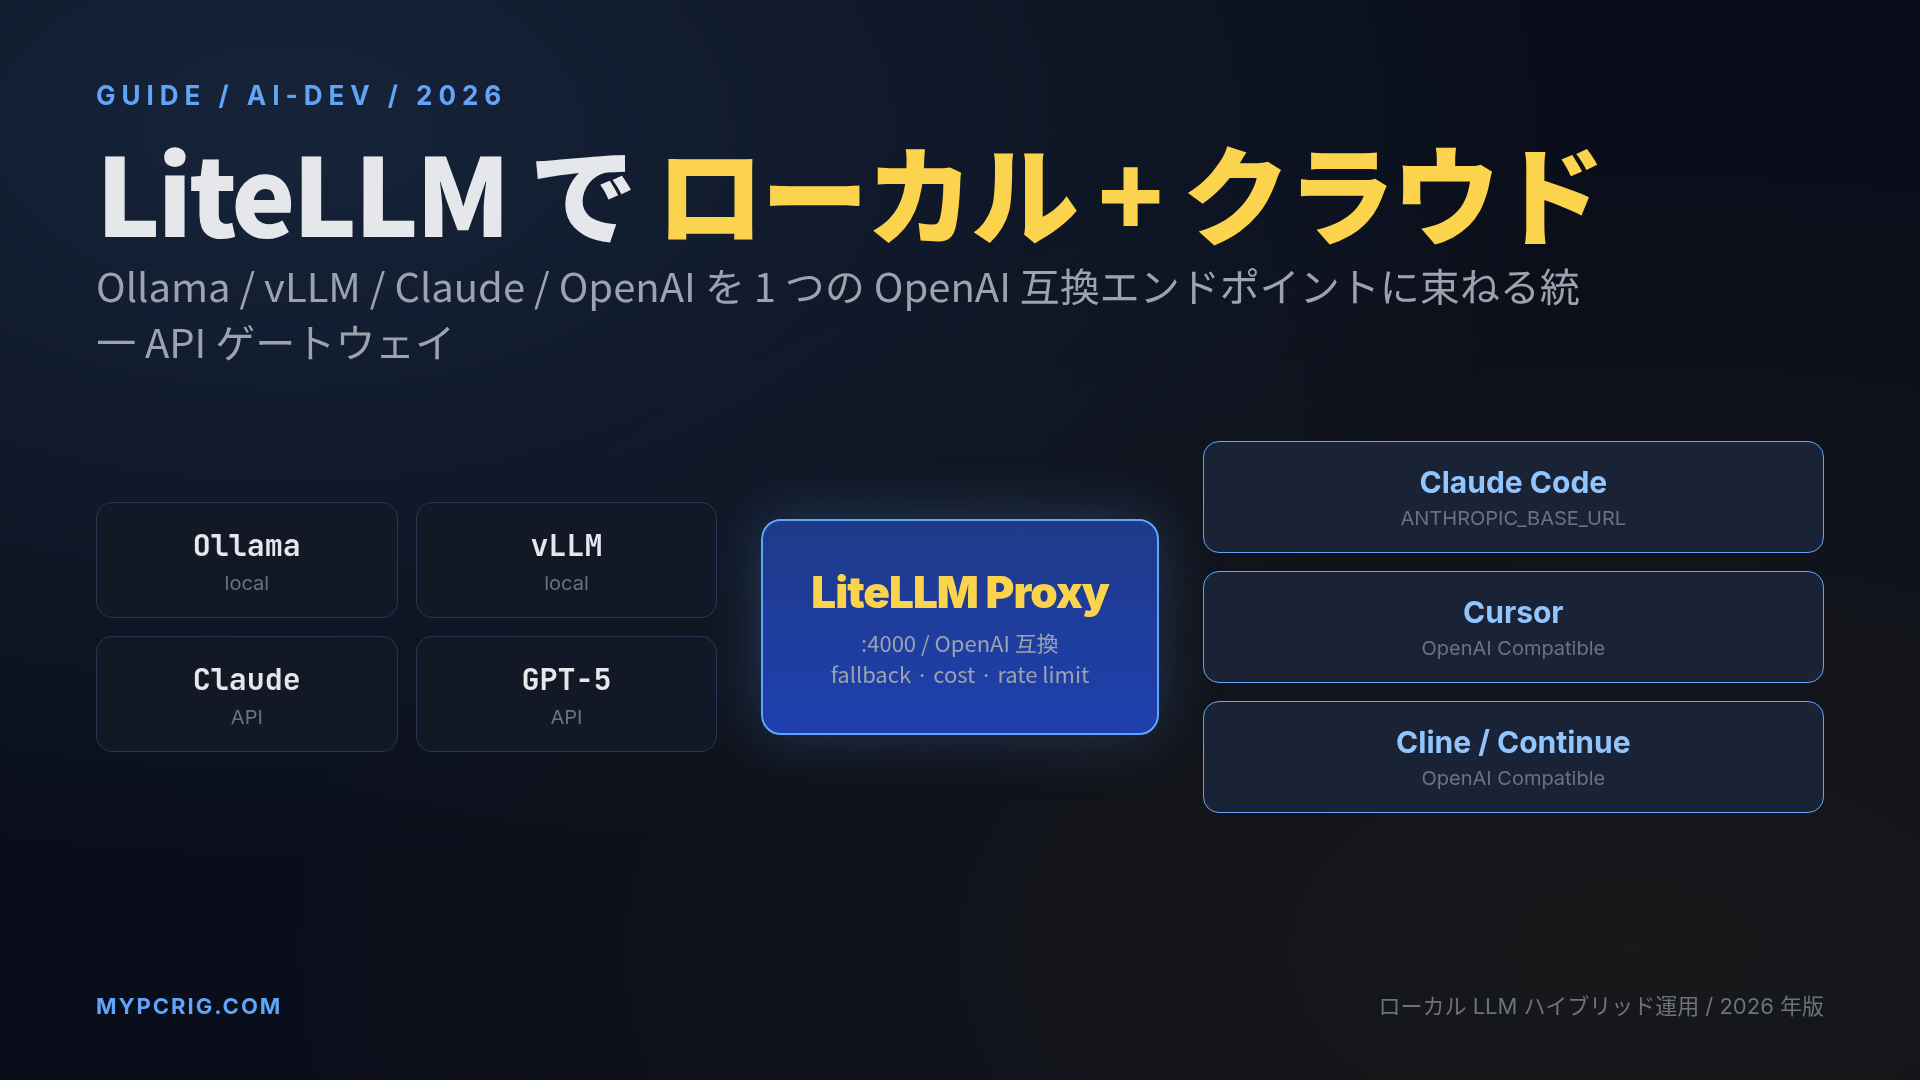
結論:LiteLLM Proxy は「複数のローカル LLM バックエンド(Ollama / vLLM / LM Studio)と複数のクラウド API(OpenAI / Anthropic / Gemini)を 1 つの OpenAI 互換エンドポイントに束ねる」用途で最短の選択肢です。Claude Code / Cursor / Cline のように「OpenAI 互換 API URL を差し込むだけ」のクライアントから、ローカル LLM とクラウド API をモデル名で切り替えられます。フォールバック(クラウド障害時にローカル退避、または逆)、モデル別コスト集計、レート制限、API キー分散といった運用機能も 1 つの config.yaml で完結します。個人開発者の使い方としては「ローカル LLM を主に使いつつ、Claude Code だけは Anthropic API を叩き、Anthropic 障害時のみローカルに逃がす」というハイブリッド運用が投資対効果の出やすい構成です。
Claude Code や Cursor で「モデルを切り替えたい」と思ったとき、多くの人が最初に突き当たるのが「OpenAI 互換 API のベース URL は 1 つしか設定できない」という制約です。ローカルの Ollama を使いたいときと Anthropic API を使いたいときで、いちいち環境変数を書き換えるのは実運用として現実的ではありません。
LiteLLM Proxy はこの間に立ちます。複数のバックエンドを「モデル名」で切り替えられる 1 つのエンドポイントとして提供します。2025 年から GitHub star 20k+ を超え、個人開発者の「AI ツール群を束ねるゲートウェイ」として定番になった選択肢です。この記事では LiteLLM Proxy の 5 分導入から、Claude Code / Cursor / Cline との接続、フォールバック設計、ローカル+クラウド併用構成までを 2026 年版でまとめます。
LiteLLM は 3 層のうち「ゲートウェイ」層
「OpenAI 互換 API を出すツール」は乱立していますが、実際は 3 つの層に整理できます。
| 層 | 役割 | 代表例 |
|---|---|---|
| 推論エンジン層 | モデルを 1 個ロードして動かす | Ollama / LM Studio / llama.cpp server |
| サービング層 | 本格スループット向けの推論サーバ | vLLM / SGLang / TensorRT-LLM |
| ゲートウェイ層 | 複数バックエンドを 1 エンドポイントに束ねる | LiteLLM / OpenRouter / Portkey |
推論エンジン層はそれぞれが OpenAI 互換 API を 1 モデル分ずつ公開します(Ollama なら http://localhost:11434/v1、LM Studio なら http://localhost:1234/v1 など)。サービング層は同じく OpenAI 互換です。バッチ推論やテンソル並列など本番運用向けの機能を持ちます。用途別の使い分けは ローカルLLM 推論ツール比較 2026年版 と vLLM / SGLang / TensorRT-LLM サービング比較 2026年版 を合わせて読むと 3 層の関係が見えます。
LiteLLM は 3 層目のゲートウェイで、上記の推論エンジン層とクラウド API を 1 つのエンドポイントに束ねる役割です。
Claude Code や Cursor の設定画面には「Base URL: http://localhost:4000」の 1 行だけ書いておけば、モデル名(claude-sonnet / local-llama / local-qwen-coder)でルーティングが切り替わる、というのが基本の使い方です。
5 分で LiteLLM Proxy を立ち上げる最小構成
まず動く形を作ります。Python 3.10 以上と Ollama がインストールされている前提で、以下の手順です。
1. インストール
pip install "litellm[proxy]"Proxy モードには追加依存が必要なので [proxy] extras を必ず指定します。SDK モードだけなら pip install litellm で足りますが、この記事の対象は Proxy モードです。
2. config.yaml を書く
最小 4 行の設定です。Ollama で動く Llama 3.1 8B を 1 モデル登録します。
model_list:
  - model_name: local-llama
    litellm_params:
      model: ollama_chat/llama3.1:8b
      api_base: http://localhost:11434
model_name はクライアント側から使う名前、litellm_params.model は LiteLLM が背後で認識するプロバイダとモデル名の組み合わせです。Ollama の場合は ollama_chat/ プレフィックスを付けます(旧 ollama/ プレフィックスは補完系タスク向けで、チャットには ollama_chat/ が現行の推奨です)。
3. 起動
litellm --config config.yaml --port 4000--port 4000 を省略すると 4000 番で立ち上がります。起動直後にログで LiteLLM: Proxy initialized at http://0.0.0.0:4000 と表示されれば OK です。
4. 疎通確認
別ターミナルから OpenAI 互換の curl を投げます。
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local-llama",
    "messages": [{"role": "user", "content": "こんにちは"}]
  }'
choices[0].message.content にレスポンスが返れば導入成功です。この時点で「OpenAI 互換エンドポイントに Ollama を隠す」という最低限のゲートウェイが立ち上がったことになります。
実運用の config.yaml サンプル:4 バックエンド束ね
ここからが本題です。
個人開発者の実運用ではローカル LLM 2〜3 個 + クラウド API 2〜3 個を混ぜます。以下は「Ollama の Llama 3.3 70B」「vLLM の Qwen 3 Coder 30B」「Anthropic Claude Sonnet」「OpenAI GPT-5」の 4 バックエンドを束ねる例です。
model_list:
  - model_name: local-llama
    litellm_params:
      model: ollama_chat/llama3.3:70b-instruct-q4_K_M
      api_base: http://localhost:11434
      timeout: 300

  - model_name: local-qwen-coder
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-Coder-30B-A3B-Instruct
      api_base: http://localhost:8000/v1
      api_key: dummy

  - model_name: claude-sonnet
    litellm_params:
      model: anthropic/claude-sonnet-4-6
      api_key: os.environ/ANTHROPIC_API_KEY

  - model_name: gpt-5
    litellm_params:
      model: openai/gpt-5
      api_key: os.environ/OPENAI_API_KEY

router_settings:
  routing_strategy: simple-shuffle
  fallbacks:
    - claude-sonnet: ["local-llama"]
    - gpt-5: ["claude-sonnet", "local-llama"]

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
このファイルを読むと、以下の運用が 1 プロセスで成立します。
- モデル名で切り替え:クライアントは
local-llama/claude-sonnet/gpt-5のいずれかを指定するだけ - API キーの分離:
os.environ/ANTHROPIC_API_KEYの書き方で環境変数から読み込む(config.yaml に平文で書かない) - フォールバック:Anthropic API が失敗したらローカル Llama へ、OpenAI が失敗したら Anthropic → ローカルの順に退避
- タイムアウト個別設定:ローカルの 70B は初回ロードが遅いので
timeout: 300を上げておく - vLLM は
hosted_vllm/プレフィックス:OpenAI 互換で立ち上がっている vLLM を指す指定
master_key は Proxy 自身の認証キーです。クライアントから Authorization: Bearer <master_key> を付けて叩く形になります。
ローカル閉じで使う場合は簡易的な値で足ります。
Claude Code / Cursor / Cline から LiteLLM を叩く
Proxy が立ち上がったら、あとはクライアント側で「Base URL を LiteLLM に向ける」だけです。3 つの代表的な AI コーディングツールでの設定例を並べます。
Claude Code CLI
Claude Code は Anthropic 公式 CLI です。ANTHROPIC_BASE_URL 環境変数でエンドポイントを差し替えられます。
export ANTHROPIC_BASE_URL="http://localhost:4000"
export ANTHROPIC_API_KEY="sk-litellm-master-key"
claude
config.yaml 側では model_name: claude-sonnet-4-6 のような Anthropic モデル名で登録しておくと、Claude Code はモデル名を書き換えずに送信できます。ただし Anthropic 固有機能(プロンプトキャッシュ、思考トークンの構造化出力)は Proxy 経由で欠落する場合があるため、Claude Code の主用途では素の Anthropic API を叩くほうが機能を活かせます。LiteLLM 経由が生きるのは「コスト管理でモデル別に集計したい」「Anthropic 障害時のローカル退避を用意したい」といった副次的な用途です。Claude Code 向けの機体スペック目安は Claude Code PC スペック実測ベンチマーク 2026年版 を参照してください。
Cursor
Cursor は Settings → Models → OpenAI API Key の項目で「OpenAI 互換エンドポイント」を差し替えられます。
- Base URL:
http://localhost:4000/v1 - API Key: LiteLLM の master_key
- Model: config.yaml で登録した
model_name(例:local-qwen-coder)
Cursor の場合は Anthropic モードでの利用に制限があります。Ollama や vLLM のローカルモデルを OpenAI 互換モードで叩く用途で LiteLLM を挟むのが素直です。
Cline / Continue.dev
Cline(旧 Claude Dev)や Continue.dev のような VSCode 拡張は、OpenAI 互換エンドポイントの入力を素直に受け付けます。
- API Provider: OpenAI Compatible
- Base URL:
http://localhost:4000/v1 - Model ID:
local-qwen-coderなど
Continue.dev の詳細な設定手順は Continue.dev + Ollama ローカルコーディング環境構築ガイド 2026年版 で扱いました。LiteLLM を挟むと Continue.dev から「モデル 1 個」を指定するだけで、実際はローカル LLM を主に、クラウド API を控えに、というルーティングが可能になります。
フォールバック設計:クラウドが落ちてもローカルで凌ぐ
LiteLLM Proxy の運用面での価値の 1 つが router_settings.fallbacks です。書式は「主モデルが失敗したときに順に試す代替モデルのリスト」で、config.yaml 例で示した以下の設定が典型例です。
router_settings:
  fallbacks:
    - claude-sonnet: ["local-llama"]
    - gpt-5: ["claude-sonnet", "local-llama"]
これは「Anthropic API がタイムアウトやレートリミットで失敗したときにローカル Llama へ、OpenAI GPT-5 が落ちたときは Anthropic → ローカルの順に試す」という設定です。個人開発者の実用としては、以下の 2 パターンが投資対効果が高い設計になります。
- クラウド主・ローカル控え:常用は Anthropic API、ダウン時に業務停止しないための保険としてローカル 70B クラスを控えに置く
- ローカル主・クラウド控え:常用はローカル Llama 3.3 で API 料金を圧縮、複雑な推論が必要なタスクのみクラウドに逃がす
後者は月額の Anthropic 料金を実質 1/5〜1/10 に落とせるケースがあります。個人開発者で「Claude Code の月間トークンが 10M を超えた」層には特に効きます。ローカル 70B クラスを回す機体構成は 48GB VRAM ローカル LLM デスクトップ構築ガイド 2026年版 を参考にしてください。
コスト集計とレート制限
LiteLLM Proxy は各リクエストに対してモデル別・API キー別のコストとトークン数を記録できます。個人開発者にとっての実用機能は以下です。
/spend/logs:LiteLLM の管理 API から過去のリクエスト単価と累計を取得max_budget:特定の API キーに月次予算を設定し、超過で自動遮断tpm/rpm:モデルごとの分間トークン数・分間リクエスト数の上限- UI ダッシュボード:Proxy 起動後に
http://localhost:4000/uiにアクセスするとモデル別コストが可視化できる(Admin UI は既定で有効。無効化する場合はDISABLE_ADMIN_UI=True)
「Claude Code + Codex + Cursor を全部併用しているけど、どのツールがどれだけ Anthropic 料金を使っているのか分からない」という運用課題は LiteLLM Proxy で解決できる典型ケースです。AI コーディング CLI のメモリ要件は Claude Code / Codex 用メモリ 32GB / 64GB / 128GB ガイド 2026年版 で扱いました。
落とし穴と実運用の tips
導入時にハマりやすい 5 点を並べておきます。
- Anthropic のプロンプトキャッシュは Proxy 経由で維持されない場合がある:LiteLLM のバージョンとリリースノートで「Anthropic cache_control 対応」が明記されている版を使うのが安全です。キャッシュ率の悪化はコスト増に直結するため、Claude Code の主用途は Anthropic 直接叩きのままにしておくのが穏当です
- Ollama の keep_alive とヘルスチェックのずれ:Ollama は既定で 5 分アイドルするとモデルをアンロードします。LiteLLM のヘルスチェック間隔と噛み合わないと初回リクエストが遅くなるため、Ollama 側で
OLLAMA_KEEP_ALIVE=-1を設定して常駐させる運用が実用的です - Streaming レスポンスのタイムアウト:
stream=trueで長時間応答を返すモデル(推論モデル系)は Proxy 側のstream_timeoutを大きめに設定します ollama/とollama_chat/の使い分け:チャット系タスクはollama_chat/、補完系(Completions API)はollama/が推奨ですmaster_keyを LAN 公開しない:LAN 外から叩くなら Tailscale や Cloudflare Tunnel で ACL を挟むのが安全です。Mac をローカル LLM サーバとして LAN 内で共有する構成は Mac をローカル LLM サーバとして Tailscale + Ollama で運用するガイド 2026年版 を参照
LiteLLM を回すために必要な PC スペック
LiteLLM Proxy 自身は軽量です。常駐 RAM 数百 MB・CPU 負荷はリクエスト転送のみです。VRAM は使いません。重いのは背後のバックエンドです。必要スペックはそちらのモデルサイズで決まります。
| 使い方 | LiteLLM Proxy 母艦 | バックエンド母艦の目安 |
|---|---|---|
| 個人開発者、ローカル LLM 8B クラス | 同一 PC で常駐 | RTX 5060 Ti 16GB / Mac mini M4 Pro 24GB |
| ローカル 30B〜70B クラスを常用 | 同一 PC でも別 PC でも可 | RTX 5090 32GB / Mac Studio M4 Max 64GB |
| 家庭内 LAN で複数クライアントから叩く | NAS / Raspberry Pi 5 / 別 PC | 母艦側は上記に準じる |
LiteLLM Proxy を専用の別マシン(NAS や Raspberry Pi 5)に置いて、ローカル GPU マシンとクラウド API を仲介させる構成も動きます。母艦マシンの選び方は VRAM 別の目安を ローカルLLM VRAM 容量別モデル早見表 2026年版 にまとめました。
LLM 側のバックエンドとして Ollama を使うか vLLM を使うかの選択は、単体スループット狙いなら vLLM、複数モデル切替の柔軟性なら Ollama、というのが 2026 年時点の穏当な線引きです。詳細は Ollama vs llama.cpp の違い 2026年版 と ローカルLLM 推論ツール比較 2026年版 を合わせて読んでください。
導入判断のチェックリスト
LiteLLM Proxy を入れるかどうかは、以下の 3 問に「はい」がいくつあるかで決めます。
- 複数の AI コーディングツール(Claude Code + Cursor + Cline など)を併用している
- ローカル LLM とクラウド API のどちらも使い、モデル名で切り替えたい
- 月間 API 料金を可視化・上限管理したい、または障害時のフォールバックを用意したい
「はい」が 2 つ以上なら導入価値があります。1 つ以下なら素直に Ollama / Anthropic API を直接叩くほうが構成がシンプルです。ローカル LLM のチャット UI として Open WebUI や LibreChat を挟む選択肢は ローカルLLM Chat UI 比較 2026年版 で、MCP プロトコル経由で外部ツールを繋ぐ場合は ローカルLLM MCP サーバー実装ガイド 2026年版 を参考にしてください。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
LiteLLM Proxy 自身は OSS で費用は発生しません。ここでは背後のローカル LLM バックエンドを動かす GPU と、Proxy を常駐させる小型 PC / Mac の候補を挙げます。本文で言及した機体・パーツのみです。
RAG / ローカル LLM 用 GPU
- GeForce RTX 5060 Ti 16GB を Amazon.co.jp で見る — 8B クラスの Ollama + LiteLLM 同居運用の入門機
- GeForce RTX 5090 32GB を Amazon.co.jp で見る — 70B クラスをローカルで動かす想定
Apple Silicon(LiteLLM Proxy + Ollama 同居運用)
- Apple Mac mini M4 Pro を Apple 公式ストアで見る — ユニファイドメモリで小型かつ静音、24〜64GB 構成でローカル LLM 母艦
- Apple Mac Studio を Apple 公式ストアで見る — M4 Max / M3 Ultra 系で 70B クラスを回す
ネットワーク常駐(Proxy 専用機として使う)
- Raspberry Pi 5 8GB を Amazon.co.jp で見る — LiteLLM Proxy 単体を常駐、LAN のゲートウェイに置く用途
Apple 公式ストアのリンクからは紹介料は発生しません(Amazon アソシエイトの対象外です)。
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
よくある質問
- LiteLLM Proxy と LiteLLM SDK は何が違いますか?
- LiteLLM は 2 つのモードを持ちます。SDK モードは Python コードから `litellm.completion()` を直接呼ぶ形で、単一プロセス内の呼び分けに使います。Proxy モードは FastAPI サーバとして常駐し、`http://localhost:4000/v1/chat/completions` の OpenAI 互換エンドポイントを公開します。Claude Code や Cursor など「OpenAI 互換 API URL を差し込むだけ」のクライアントから複数バックエンドを束ねたい場合は Proxy モードが本命です。個人開発者の常用形態は Proxy モードで、config.yaml に model_list を書いて `litellm --config config.yaml` で起動する流れが標準です。
- Ollama や vLLM を直接叩けば済むのに、LiteLLM を挟む意味はありますか?
- 1 台のクライアント(Claude Code / Cursor)から 1 個のバックエンド(Ollama だけ)を叩く用途では LiteLLM は不要です。意味が出るのは「複数のバックエンドをモデル名で切り替える」場面で、たとえば `local-llama` は Ollama、`local-qwen-coder` は vLLM、`claude-sonnet` は Anthropic API、というルーティングを 1 つのエンドポイントに集約できます。加えてフォールバック(Anthropic API 障害時にローカル退避)、レート制限、モデル別のコスト集計、API キー分散、といった運用機能が SDK 側に載っていない Proxy 固有の価値です。
- LiteLLM Proxy はどのくらいの PC で動きますか?
- LiteLLM Proxy 自身は Python + FastAPI の薄いプロセスで、常駐 RAM は数百 MB、CPU 負荷もリクエスト転送のみで軽量です。VRAM は使いません。重いのは背後のバックエンド(Ollama や vLLM)なので、必要 PC スペックはそちらのモデルサイズで決まります。LLM 母艦のスペック目安は [ローカルLLM VRAM 容量別モデル早見表 2026年版](/blog/local-llm-vram-capacity-model-chart-2026/) を参照してください。LiteLLM Proxy を専用の別マシン(Raspberry Pi や NAS)に置いて、ローカル GPU マシンとクラウド API を仲介させる構成も動きます。
- Claude Code から LiteLLM Proxy 経由でローカル Ollama を呼べますか?
- 呼べます。Claude Code は `ANTHROPIC_BASE_URL` 環境変数で Anthropic API のベース URL を差し替えられる設計になっており、LiteLLM Proxy の URL(例:`http://localhost:4000`)を指すと Claude Code からのリクエストが Proxy に届きます。config.yaml で `claude-sonnet-4-6` などのモデル名を Ollama バックエンドにマップしておくと、Claude Code からは Anthropic モデル名のまま送信して、実際はローカル Llama 3.3 70B が返す、といったハイブリッド運用が可能です。ただしプロンプトキャッシュや思考トークンなど Anthropic 固有機能は Proxy 経由では失われる場合があるため、常用の主モデルには依然としてクラウド API を使い、コスト削減用に一部モデルだけローカルに逃がす、という併用が現実的です。
- LiteLLM のフォールバック機能はどう書けばいいですか?
- config.yaml の `router_settings.fallbacks` に「主モデルが失敗したときの逃げ先」をリストで書きます。たとえば `- claude-sonnet: ["local-llama"]` と書くと、Anthropic API がレートリミットや障害で失敗したときにローカル Ollama の Llama 3.3 に自動で切り替わります。逆に `- local-llama: ["claude-sonnet"]` にすればローカル GPU が VRAM 不足で落ちたときにクラウドへ逃がせます。個人開発者の実用としては「クラウドが主・ローカルが控え」よりも「ローカルが主・失敗時のみクラウド」の逆パターンで API 料金を圧縮する使い方のほうが投資対効果が出やすい構成です。
- OpenAI 互換 API を名乗るツールはたくさんありますが、LiteLLM の位置付けはどこですか?
- OpenAI 互換 API を提供するツールは大きく 3 層に分かれます。まず推論エンジン層(Ollama / vLLM / LM Studio / llama.cpp サーバ)は「モデルを動かすランタイム」で、それぞれが OpenAI 互換エンドポイントを 1 モデル分ずつ公開します。次にサービング層(vLLM / SGLang / TensorRT-LLM)は「本格スループット向けの推論サーバ」です。LiteLLM は 3 層目の「ゲートウェイ層」で、上記の推論エンジン群 + クラウド API 群を 1 つのエンドポイントに束ねる役割です。用途別の使い分けは [ローカルLLM 推論ツール比較 2026年版](/blog/local-llm-runtime-tools-comparison-2026/) と [vLLM / SGLang / TensorRT-LLM サービング比較 2026年版](/blog/vllm-sglang-tensorrt-llm-serving-comparison-2026/) を合わせて読むと 3 層の関係が見えます。