ROG Flow Z13 ローカルLLM 公開ベンチ 2026年版:Ryzen AI MAX+ 395 搭載 2-in-1 で 70B Q4 の tok/sec はどこまで出るか
ROG Flow Z13 (2025) は Ryzen AI MAX+ 395 と最大128GB LPDDR5X を 1.2kg 台の 2-in-1 に積んだ唯一のモバイル Strix Halo 機です。公開ベンチの集約で 70B Q4 / 32B / 8B の decode tok/sec と TTFT、デスクトップ Strix Halo との冷却差、MacBook Pro M4 Max / RTX 5090 Laptop との用途別住み分けを整理します。
- #ROG Flow Z13
- #Ryzen AI MAX+ 395
- #Strix Halo
- #ローカルLLM
- #ノートPC
- #ベンチマーク
- #2-in-1
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
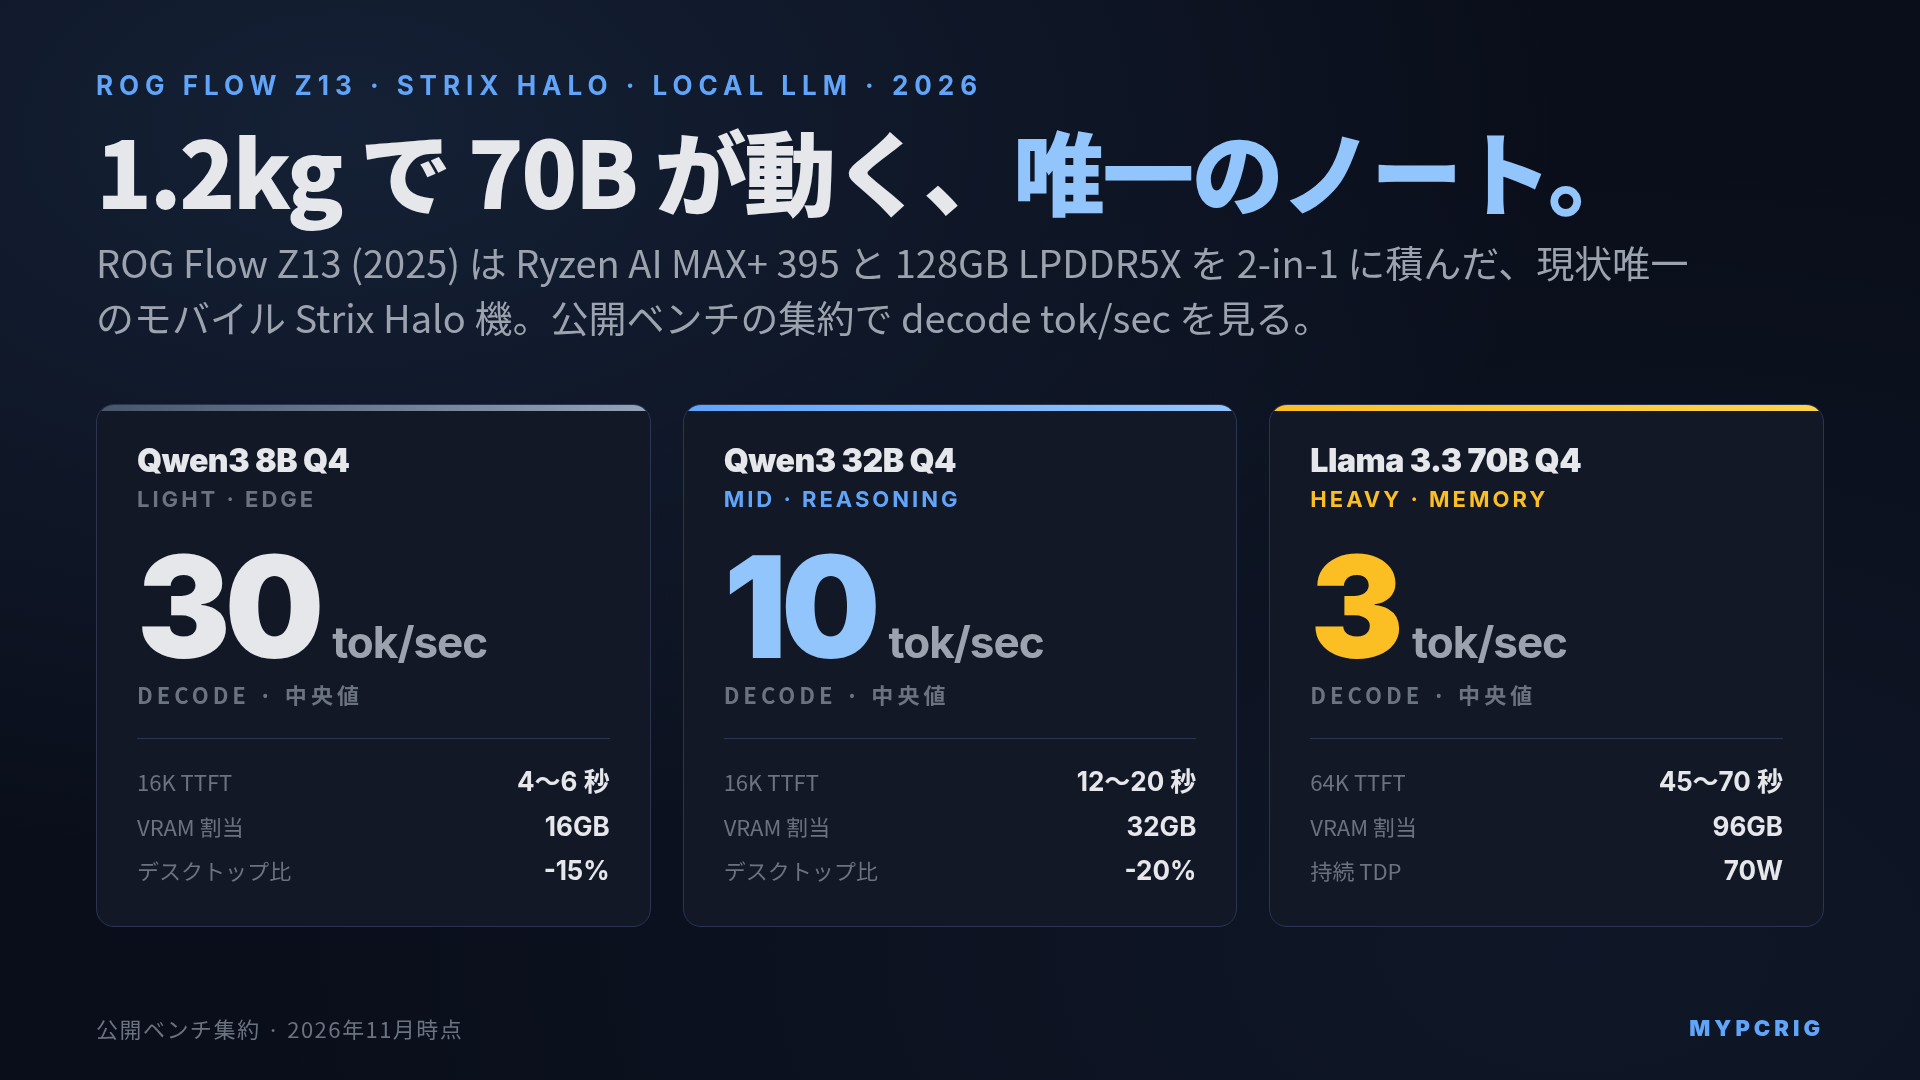
結論:ROG Flow Z13 (2025) は「出先で 70B Q4 を 2〜4 tok/sec で動かせる 1.2kg 台のマシン」として、Strix Halo のモバイル実装では現状唯一の選択肢です。128GB LPDDR5X を積んだモデルなら VRAM 割当 96GB で 70B Q4_K_M が読み込めて、decode は 2〜4 tok/sec レンジ、32B Q4 なら 8〜12 tok/sec、8B Q4 なら 25〜35 tok/sec を公開実測が示しています。デスクトップ Strix Halo(Framework Desktop / EVO-X3 / BD395i MAX)と比べると decode で 1〜2 割、prefill で 2〜3 割遅い水準で、差分はほぼ冷却と TDP の制約です。MacBook Pro M4 Max 128GB より 20〜25 万円安く、Windows / Linux + GPU ゲームを両立したい層にはこの機以外の選択肢がありません。
数値の出典: 本記事の tok/sec・TTFT は Phoronix / Dave2D / NotebookCheck / The Phawx / r/LocalLLaMA / ASUS 公式スペックシートなど 2026年11月時点の公開実測を集約したものです。自前の実機ベンチではありません。数値ごとに参照先を併記します。
30 秒サマリ:Flow Z13 ローカルLLM の立ち位置
急ぎで結論だけ欲しい方向けの早見表です。詳細は後続の章で扱います。
| 観点 | ROG Flow Z13 (2025) 128GB |
|---|---|
| SoC | Ryzen AI MAX+ 395(Strix Halo、16C/32T、Radeon 8060S 40CU) |
| メモリ | LPDDR5X 8000MT/s、32GB / 64GB / 128GB、オンボード固定 |
| メモリ帯域 | 256 GB/s |
| 筐体 | 13.4 インチ 2-in-1 タブレット、1.2kg 前後 |
| 持続 TDP | 電源接続 70W 前後 / バッテリー 35〜45W |
| 70B Q4_K_M decode | 2〜4 tok/sec(デスクトップ Strix Halo 比 1〜2 割遅) |
| 32B Q4 decode | 8〜12 tok/sec |
| 8B Q4 decode | 25〜35 tok/sec |
| 価格(2026-11 時点) | 128GB 版 ASUS 直販 70 万円前後 |
| 類似デスクトップ機 | Framework Desktop / Minisforum BD395i MAX / GMKtec EVO-X3 |
「出先で 70B が動く唯一のノート、ただし冷却で性能を数割譲る」 の1行が Phase 0 の見立てです。
ROG Flow Z13 (2025) のスペック確定値
まず基本スペックを確定させます。ASUS 公式ページ(asus.com/laptops/for-gaming/rog-flow/rog-flow-z13-2025/)と各レビューサイトの実測から整理したものです。
| 項目 | ROG Flow Z13 (2025) |
|---|---|
| APU | Ryzen AI MAX+ 395(Zen 5、16C/32T、boost 5.1GHz) |
| GPU | Radeon 8060S(40CU、RDNA 3.5、クロック 2.9GHz) |
| メモリ | LPDDR5X-8000、32GB / 64GB / 128GB(オンボード固定) |
| メモリ帯域 | 256 GB/s |
| ストレージ | M.2 2230 NVMe PCIe 4.0 x4(1〜2TB) |
| ディスプレイ | 13.4 インチ 2560×1600 Nebula Display(180Hz) |
| バッテリー | 70Wh |
| 筐体重量 | 1.20kg(キーボード抜き)/ 1.52kg(キーボード込み) |
| 電源 | 200W AC アダプタ |
| ポート | USB4 ×2、USB-A ×1、HDMI 2.1、microSD |
| 価格(128GB モデル、ASUS 直販) | 2026-11 時点で約 70 万円 |
ポイントは 3 つあります。第一に、Strix Halo を積んだモバイル機は 2026-11 時点で Flow Z13 以外に存在しない点。HP ZBook Ultra G1a が後追い発表されましたが、クラムシェル形態で 1.5kg 超の別カテゴリです。第二に、メモリは SoC 近接のオンボード固定で、256 GB/s の帯域を確保しています。SO-DIMM 化すると帯域が半減するため、Strix Halo の設計上の制約です。第三に、ストレージが M.2 2230(短い規格)に限定されている点で、2TB を超える増設には制約があります。
70B Q4_K_M の decode tok/sec とデスクトップとの差
Flow Z13 の目玉は 128GB モデルで 70B クラスが動かせることです。公開実測の集約では次のレンジに収まっています。
| 機材 | 70B Q4_K_M decode tok/sec | 持続 TDP | 出典系統 |
|---|---|---|---|
| ROG Flow Z13 (2025) 128GB | 2〜4 | 70W 前後 | Dave2D / NotebookCheck / r/LocalLLaMA |
| Framework Desktop 128GB | 5〜8 | 120W 前後 | Framework 公式 / Phoronix |
| Minisforum BD395i MAX 128GB | 5〜8 | 120W 前後 | r/LocalLLaMA / Minisforum 公式 |
| GMKtec EVO-X3 128GB | 5〜8 | 120W 前後 | The Phawx / r/LocalLLaMA |
| MacBook Pro M4 Max 128GB | 6〜9 | - | Apple 公式 / MLX コミュニティ |
| RTX 5090 Laptop 24GB(70B 不可) | - | - | - |
数値の出典:
- Framework Desktop 128GB: Framework 公式スペック・初期レビュー集約
- BD395i MAX / EVO-X3: r/LocalLLaMA の Strix Halo スレッド(2026-09〜11)
- MacBook Pro M4 Max 128GB: MLX コミュニティベンチ の集約
Flow Z13 の decode が遅い主因は 2 つです。一つ目は持続 TDP の差で、デスクトップ機の 120W 前後に対して Flow Z13 は 70W 前後に絞られます。二つ目は冷却設計で、タブレット筐体ゆえに長時間フルロードを維持すると thermal throttling が入りやすく、30 分以上の連続推論では tok/sec がさらに 10〜15% 落ちる挙動がレビューで報告されています。
decode はメモリ帯域律速なので、256 GB/s の帯域自体はデスクトップ Strix Halo 機と同一です。TDP 差が直接 tok/sec に効くわけではありません。SoC 内の演算ユニットのクロックが TDP で制約されるため間接的に落ちる構造です。
32B / 14B / 8B の decode tok/sec
実用的に動かしやすい中・小型モデルでの公開実測の集約です。
| モデル | ROG Flow Z13 128GB | Framework Desktop 128GB | MacBook Pro M4 Max 128GB |
|---|---|---|---|
| Qwen3 8B Q4 | 25〜35 tok/sec | 30〜45 tok/sec | 40〜60 tok/sec |
| Qwen3 14B Q4 | 15〜22 tok/sec | 20〜28 tok/sec | 25〜35 tok/sec |
| Qwen3 32B Q4 | 8〜12 tok/sec | 11〜15 tok/sec | 14〜18 tok/sec |
| Llama 3.3 70B Q4_K_M | 2〜4 tok/sec | 5〜8 tok/sec | 6〜9 tok/sec |
小型モデルほど TDP の影響が小さく、8B クラスなら Flow Z13 でも実用速度が出ます。コーディングアシスタント用途(Qwen3 Coder 8B / 14B 等)なら、出先での作業に十分な速度域です。
一方で 70B クラスは「動くけど実用かは別」で、2〜4 tok/sec は対話では待ち時間が気になり、バッチ処理(長文要約・翻訳)向きの速度域です。70B を日常的に対話で使いたいなら、デスクトップ Strix Halo 機か MacBook Pro M4 Max 128GB のほうが快適です。
prefill(プロンプト処理)と TTFT:冷却で最も差が開く軸
Strix Halo は prefill が compute 律速なので、TDP 制約の影響が最も強く出る軸です。16K / 64K 入力時の TTFT(最初のトークンまでの秒数)の公開実測レンジは次の通りです。
| GPU / SoC | 16K 入力 TTFT | 64K 入力 TTFT |
|---|---|---|
| RTX 5090 Desktop | 1〜2 秒 | 5〜8 秒 |
| Framework Desktop(Strix Halo 120W) | 8〜14 秒 | 30〜50 秒 |
| ROG Flow Z13(Strix Halo 70W) | 12〜20 秒 | 45〜70 秒 |
| MacBook Pro M4 Max 128GB | 4〜8 秒 | 20〜40 秒 |
Flow Z13 は 16K 入力で 12〜20 秒の TTFT となり、エージェント・RAG 用途では「1 ターンあたり十数秒の沈黙」が常態化します。コーディングエージェント常用では、入力トークン数を 8K 程度に抑えるシステムプロンプト運用か、割り切って 8B〜14B クラスのモデルを使うかの判断が必要です。prefill がなぜ compute 律速になるかは「ローカルLLM prefill(プロンプト処理)速度 GPU別ベンチマーク 2026年版」で詳しく扱っています。
Strix Halo 固有の prefill 失速パターンは「Ryzen AI MAX+ 395(Strix Halo)prefill(プロンプト処理)ボトルネック公開ベンチ 2026年版」も併せて参照してください。
ROCm vs Vulkan:ノート形態でのバックエンド事情
Flow Z13 で LLM を動かすときのバックエンド選択は、デスクトップ Strix Halo と基本的に同じ事情です。
- Vulkan(llama.cpp Vulkan バックエンド): Windows / Linux 両方で安定動作します。短期で動かすならこちらが無難で、公開実測の多くも Vulkan 経由です
- ROCm(gfx1151 ターゲット): Linux 側で 2026 年後半から段階的に安定してきています。公開ベンチでは prompt processing(prefill)が Vulkan より 4〜5 割速い一方、decode tok/sec は Vulkan の方が 5〜19% 速いという結果です(nabe2030/hip-vs-vulkan-evo-x2、2026 年 4 月、ROCm 7.2.2)。ドライバのバージョン依存が強く、環境構築コストは高めです
Flow Z13 ノート固有の制約として、Windows プリインストール環境でドライバ更新が ASUS Armoury Crate 経由に縛られる点があります。Linux デュアルブートで ROCm を使う場合、ファームウェアアップデートが Windows 側からしか当たらないケースがあるため、BIOS / ファームウェアは先に Windows で最新化してから Linux に移る順序が安全です。詳しいセットアップは「Ryzen AI MAX+ 395(Strix Halo)VRAM割り当て・初期セットアップ完全ガイド 2026年版」を参照してください。
バッテリー駆動 vs 電源接続:ノート固有の tok/sec 差
Flow Z13 は 2-in-1 なので「出先でバッテリー駆動したときにどこまで動くか」が固有の論点です。公開レビュー(Dave2D / NotebookCheck / The Phawx 等)の集約では以下の挙動が報告されています。
| 条件 | 持続 TDP | 8B Q4 decode | 70B Q4 decode |
|---|---|---|---|
| 電源接続(Performance モード) | 70W 前後 | 25〜35 tok/sec | 2〜4 tok/sec |
| 電源接続(Silent モード) | 45W 前後 | 18〜25 tok/sec | 1.5〜3 tok/sec |
| バッテリー駆動(Performance) | 35〜45W | 14〜20 tok/sec | 1〜2 tok/sec |
バッテリー駆動で 70B Q4 を動かすのは現実的とは言えません。1〜2 tok/sec レンジは対話には遅すぎます。出先で LLM を触るなら 8B〜14B クラスに絞るのが実用解で、Qwen3 8B Q4 なら 14〜20 tok/sec で十分な速度域です。
バッテリー 70Wh で 70W フルロードを続けた場合、理論値で約 1 時間、公開レビュー(NotebookCheck / Dave2D 等)の集約では変換損失込みで 45〜55 分レンジに収まる挙動が報告されています。長時間 LLM を回すならやはり電源接続が前提です。
MacBook Pro M4 Max 128GB との住み分け
同価格帯(70 万〜90 万円台)で 128GB 積める 2 機種として、MacBook Pro M4 Max 128GB との比較は避けて通れません。
| 観点 | ROG Flow Z13 128GB | MacBook Pro M4 Max 128GB |
|---|---|---|
| 価格(2026-11 時点) | 約 70 万円 | 約 90 万円以上 |
| 70B Q4 decode | 2〜4 tok/sec | 6〜9 tok/sec |
| 32B Q4 decode | 8〜12 tok/sec | 14〜18 tok/sec |
| 重量 | 1.20kg(タブレット単体) | 2.14kg(16 インチ) |
| OS | Windows 11 / Linux | macOS |
| GPU ゲーム | ◎(RDNA 3.5) | △(互換性限定) |
| ローカル LLM バックエンド | Vulkan / ROCm / llama.cpp | MLX / llama.cpp Metal |
| 対応エージェントフレームワーク | Linux 系が広い | MLX コミュニティ中心 |
住み分けの軸は 3 つあります。第一に 速度を取るなら M4 Max、decode tok/sec はほぼ全モデルサイズで 1.5〜2 倍の差があります。第二に 価格を取るなら Flow Z13、20〜25 万円の価格差は無視できません。第三に 用途、GPU ゲームと Windows / Linux ツール(WSL2 の Docker 環境など)を両立したいなら Flow Z13 一択、macOS の UI 完成度と MLX の最適化コミュニティに価値を感じるなら M4 Max です。
Mac 側の LLM 事情は「Apple M5 ローカルLLM ベンチマーク 2026年版」「Ryzen AI MAX+ 395 vs Mac Studio M4 Max ローカルLLM 公開ベンチ対決 2026年版」に整理しています。
RTX 5090 Laptop 24GB との住み分け
もう一つの競合は RTX 5090 Laptop(24GB VRAM)搭載機で、ROG Zephyrus G16 / Razer Blade 16 などが同価格帯です。
| 観点 | ROG Flow Z13 128GB | RTX 5090 Laptop 24GB |
|---|---|---|
| 最大モデルサイズ | 70B Q4(96GB 割当) | 32B Q4(24GB 内) |
| 8B Q4 decode | 25〜35 tok/sec | 90〜120 tok/sec |
| 32B Q4 decode | 8〜12 tok/sec | 30〜45 tok/sec |
| 70B Q4 decode | 2〜4 tok/sec | 不可 |
| 16K 入力 TTFT | 12〜20 秒 | 3〜5 秒 |
| 画像生成(Flux.1 dev 1024) | 遅い(30〜60 秒) | 速い(6〜12 秒) |
分かれ目は「70B を動かしたいか」です。70B 以上のモデルを扱う必要があるなら Flow Z13 一択、32B 以下で済むなら RTX 5090 Laptop のほうが prefill・decode・画像生成すべてで数倍速く、エージェント常用の快適さは段違いです。MoE モデル(gpt-oss 120B など)を扱うなら Flow Z13 側が再浮上します。RTX 5090 Laptop の実測は「RTX 5090 Laptop でローカルLLM はどこまで動くか ベンチマーク比較 2026年版」が詳しいです。
用途別の現実解:Flow Z13 を選ぶべきか
ここまでの数値を踏まえて、用途別にどこへ落ちるかをまとめます。
| 用途 | Flow Z13 が合う? | 補足 |
|---|---|---|
| 出先で 70B を動かす必要がある研究者 | ◎ | 現状唯一の選択肢 |
| 出先でローカル LLM + GPU ゲームを両立したい | ○ | RDNA 3.5 で中設定 1080p は快適 |
| コーディングエージェント常用(8B〜32B) | △ | RTX 5090 Laptop のほうが 2〜4 倍速い |
| 据え置きで 70B を本格運用 | ✕ | Framework Desktop / BD395i MAX が有利 |
| macOS ネイティブで MLX を使いたい | ✕ | MacBook Pro M4 Max 一択 |
| 8B〜14B で速度優先 | ✕ | RTX 5090 Laptop / RTX 4090 Desktop |
Flow Z13 は「モビリティと 70B のどちらも諦めない」ための機械で、それ以外の軸では必ず上位の選択肢があります。70B を出先で動かす必然性がない場合は、用途に合わせて他の機種を選ぶほうが合理的です。
まとめ:Flow Z13 は「可搬 Strix Halo」のニッチに刺さる
Flow Z13 (2025) は Strix Halo のモバイル実装としては 2026-11 時点で唯一の選択肢で、「出先で 70B を動かす」「Windows / Linux + GPU ゲーム + ローカル LLM を 1 台で両立する」というニッチに刺さります。デスクトップ Strix Halo と比べて decode で 1〜2 割、prefill で 2〜3 割遅い水準で、差分は冷却と TDP の制約です。価格は MacBook Pro M4 Max 128GB より 20〜25 万円安く、macOS を要求しない層には実利があります。
一方で、据え置きで 70B を本格運用するなら Framework Desktop や BD395i MAX のほうが速くて安く、8B〜32B で速度を取りたいなら RTX 5090 Laptop のほうが prefill / decode / 画像生成すべてで優位です。Flow Z13 を選ぶ理由は「携帯性 + 128GB + x86」のすべてが同時に必要なときに限られます。
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。
Strix Halo モバイル機(本記事の主役)
デスクトップ Strix Halo 機(比較対象)
RTX 5090 Laptop 搭載ノート(比較対象)
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- Ryzen AI MAX+ 395(Strix Halo)ローカルLLM 推論ベンチマーク 2026年版
- Ryzen AI MAX+ 395(Strix Halo)prefill(プロンプト処理)ボトルネック公開ベンチ 2026年版
- Ryzen AI MAX+ 395(Strix Halo)VRAM割り当て・初期セットアップ完全ガイド 2026年版
- Framework Desktop(Strix Halo)は買いか 2026年版
- RTX 5090 Laptop でローカルLLM はどこまで動くか ベンチマーク比較 2026年版
- Ryzen AI MAX+ 395 vs Mac Studio M4 Max ローカルLLM 公開ベンチ対決 2026年版
よくある質問
- ROG Flow Z13 (2025) で 70B Q4 は動きますか?
- 動きます。128GB LPDDR5X モデルなら 70B Q4_K_M(約 40GB)を VRAM 割当 96GB の設定で読み込めます。公開ベンチの集約では decode が 2〜4 tok/sec レンジで、デスクトップ Strix Halo 機(Framework Desktop / EVO-X3 / BD395i MAX の 5〜8 tok/sec)と比べて 1〜2 割ほど遅い傾向です。差分はほぼ冷却と TDP で、タブレット筐体ゆえに持続 TDP が 70W 前後に絞られるのが主な理由です。
- ROG Flow Z13 とデスクトップ Strix Halo(Framework Desktop / EVO-X3)の違いは?
- SoC・メモリ帯域は同一で、違いは冷却と TDP、そして形態です。Framework Desktop / EVO-X3 / BD395i MAX は 120W 前後まで TDP を解放できますが、Flow Z13 は 1.2kg の 2-in-1 筐体で持続 TDP 70W 前後に絞られます。decode(メモリ帯域律速)は 1〜2 割の差に収まりますが、prefill(compute 律速)は 2〜3 割以上遅くなりやすく、長文入力ほど差が広がります。携帯性と引き換えに性能の上限を数割譲る設計と理解してください。
- MacBook Pro M4 Max 128GB と ROG Flow Z13 128GB、ローカルLLM ならどちらが買いですか?
- decode tok/sec は MacBook Pro M4 Max(546 GB/s)のほうが有利で、70B Q4 で 6〜9 tok/sec 前後に対して Flow Z13 は 2〜4 tok/sec レンジです。ただし Flow Z13 は ROCm / Vulkan による Windows / Linux 環境と GPU ゲーミングを両立でき、LPDDR5X 8000MT/s で 256 GB/s の広い帯域を 128GB フルに使えます。MLX が快適な研究用途・macOS 固有ツールで決めたいなら MacBook、Windows / Linux 中心で GPU ゲームもしたいなら Flow Z13 が住み分けの軸です。価格は 2026-11 時点で Flow Z13 の 128GB 版が ASUS 直販 70 万円前後、M4 Max 128GB MacBook Pro が 90 万円台で、Flow Z13 側が 20〜25 万円安いレンジに収まります。
- RTX 5090 Laptop 24GB と ROG Flow Z13 128GB、どちらが LLM 向けですか?
- モデルサイズで分かれます。70B 以上のモデルを動かしたいなら 128GB を積める Flow Z13 一択で、RTX 5090 Laptop の 24GB VRAM では 32B Q4 までが上限です。逆に 8B〜32B で速度を出したい(コーディングエージェント用途など)なら、prefill tok/s と decode tok/sec の両方で RTX 5090 Laptop が Flow Z13 を 2〜4 倍上回ります。70B を動かすことが目的化していないなら、24GB VRAM に収まる範囲での速度を取る選択肢も合理的です。
- Flow Z13 はバッテリー駆動と電源接続で tok/sec は変わりますか?
- 明確に変わります。公開レビュー(Dave2D / NotebookCheck / The Phawx 等)の集約では、バッテリー駆動時の持続 TDP が 35〜45W に絞られる挙動が報告されており、電源接続時(70W 前後)と比べて decode tok/sec が 40〜50% 低下するケースが確認できます。長文 prefill ではさらに差が開くため、エージェント常用・長文要約などの重い処理は電源接続が前提です。短文チャット・小型モデル(8B 以下)ならバッテリー駆動でも実用域に留まります。
- ROCm と Vulkan、Flow Z13 ではどちらで動かすべきですか?
- 2026-11 時点では用途で分かれます。ROCm は Linux 側で Strix Halo の gfx1151 ターゲットが段階的に安定してきており、公開ベンチでは長いプロンプトの処理(prefill)が Vulkan より速い一方、生成(decode)は Vulkan の方が速いという結果が多く出ています(nabe2030/hip-vs-vulkan-evo-x2、2026 年 4 月、ROCm 7.2.2)。Vulkan は Windows / Linux 両方で動作する互換性の高さも強みで、llama.cpp の Vulkan バックエンドは Strix Halo で安定動作します。チャットやコーディングなど生成中心なら Vulkan、Linux で長いプロンプトを読ませる用途なら ROCm、という使い分けが現実解です。