RX 7900 XTX 24GB 中古 LLM は買いか 2026 年版:ROCm 7.x 時代の 24GB VRAM と RTX 3090 中古 / RX 9070 XT 新品との住み分け
AMD Radeon RX 7900 XTX 24GB 中古は 2026 年 10 月時点でローカル LLM 用の買いか。ROCm 7.x 対応・RX 9070 XT 16GB 新品・RTX 3090 24GB 中古との tok/sec と価格、70B Q4 の動作可否を公開ベンチの集約で判定します。
- #Radeon RX 7900 XTX
- #RDNA 3
- #AMD
- #中古GPU
- #ローカルLLM
- #ROCm
- #70B
- #GPU比較
本記事は Amazon.co.jp および各販売店のアフィリエイトリンクを含む場合があります。推奨は性能・コスパ・実機ベンチマーク基準で編集判断しており、提供記事は受け付けていません。詳細は プライバシーポリシー をご覧ください。
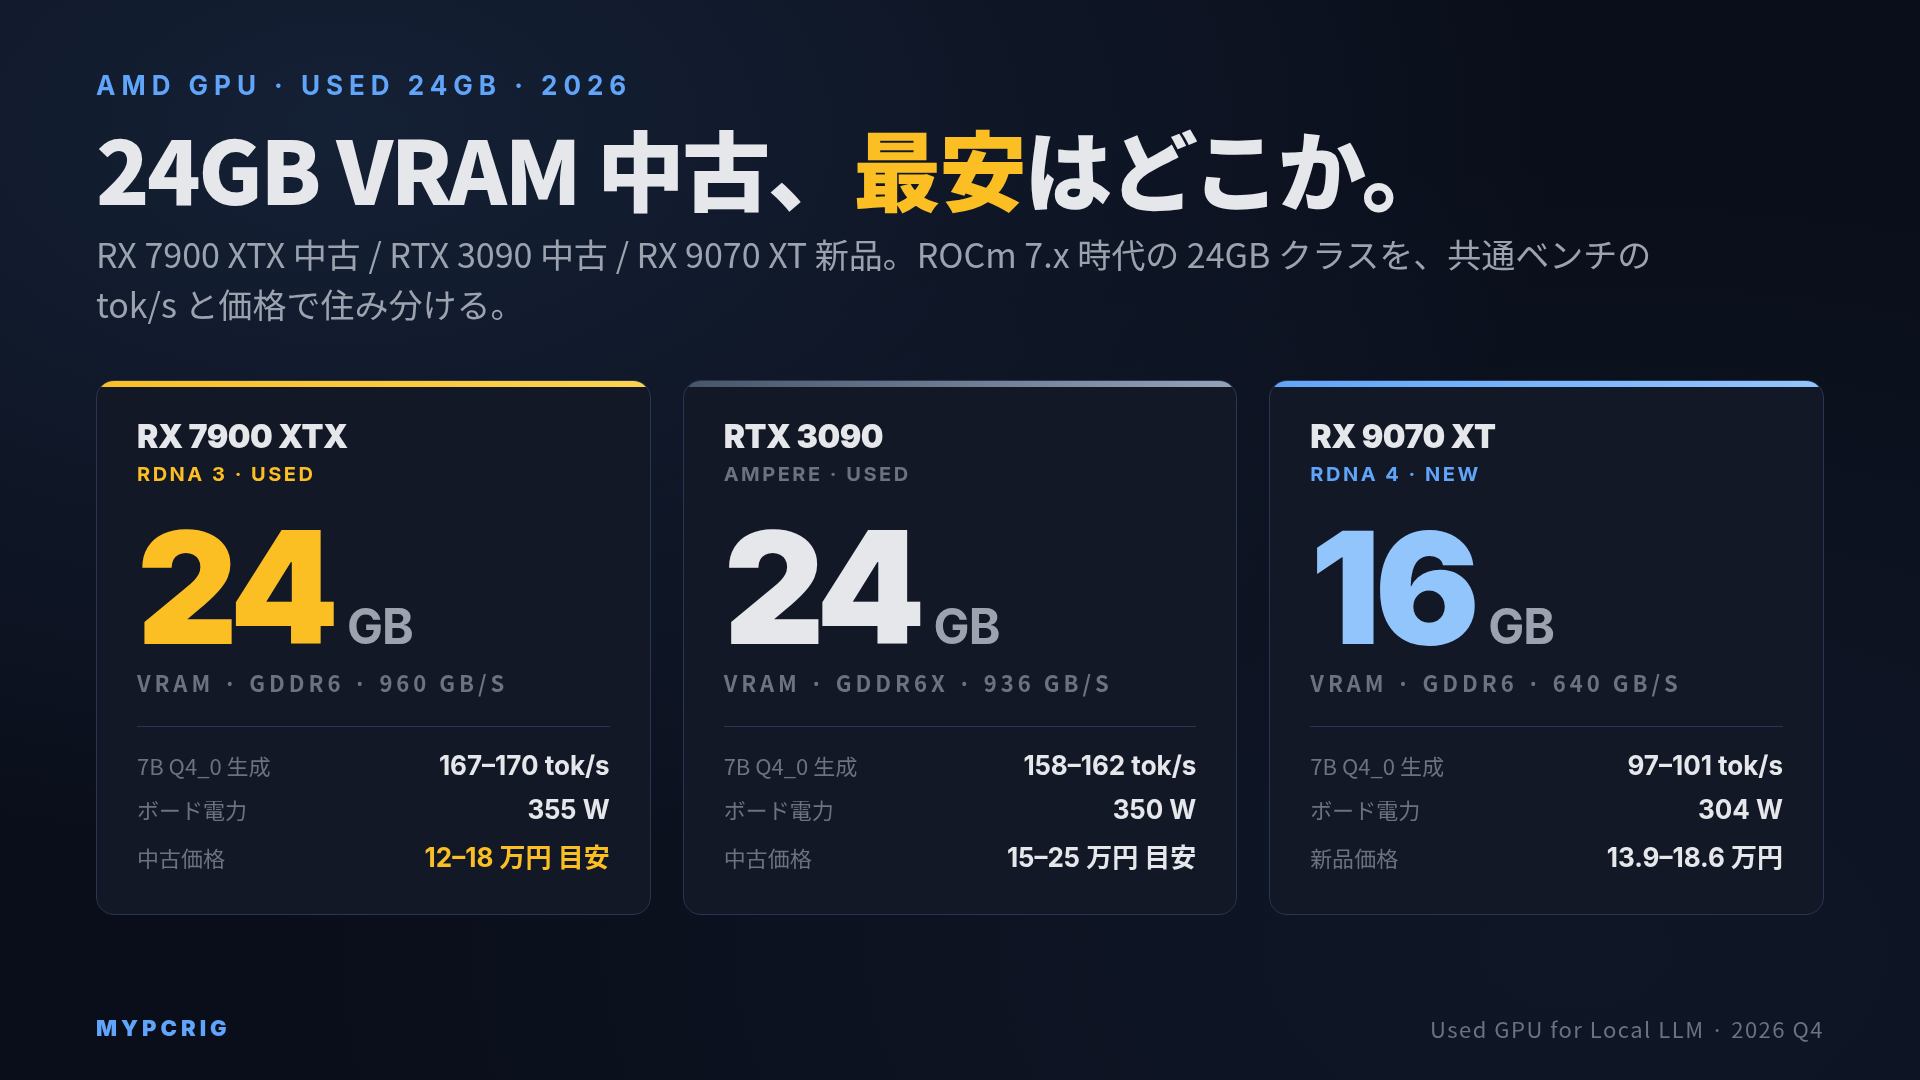
結論:AMD Radeon RX 7900 XTX(RDNA 3、24GB VRAM、帯域 960GB/s)の中古は、2026 年 10 月時点で「CUDA にこだわらない人が 24GB を取りにいく」ときの有力候補です。llama.cpp の共通ベンチ(Llama 2 7B Q4_0 の生成)では 7900 XTX が 167〜 170 tok/s で、RTX 3090 の 158〜 162 tok/s とほぼ同帯、新品 RX 9070 XT 16GB の 97〜 101 tok/s を大きく上回ります。新品の 9070 XT はソフマップで約 13.9 万〜 18.6 万円(2026 年 10 月 19 日時点)、7900 XTX の中古は目安で 12 万〜 18 万円程度なので、同じ予算帯で VRAM が 1.5 倍になります。ただし 70B を Q4 のまま単機に全層載せることはできず、24GB の主戦場は 30B 前後の Q4 です。CUDA 前提のライブラリを使うなら 3090、32GB 以上が要るなら Radeon AI PRO R9700 32GB や AMD Radeon PRO W7900 48GB へ上げる判断になります。
RX 7900 XTX は 2022 年 12 月発売の RDNA 3 旗艦です。2026 年 10 月時点では新品の流通がほぼ終わっていて、ソフマップの新品掲載 20 点は 10 月 19 日時点ですべて在庫切れか限定数終了でした(ソフマップの検索結果)。手に入れるなら中古が現実的です。本記事は、この 7900 XTX 中古が「ローカル LLM 用途として買いか」を、同じ 24GB の RTX 3090 中古と、16GB の RX 9070 XT 新品との比較で整理します。
数値の出典は、llama.cpp の公式ディスカッションに集まっている共通ベンチ、GitHub で公開されている llama-bench の結果、Hugging Face のモデルカード、AMD の公式ドキュメントです。各数値の横にリンクを置いています。mypcrig 側でこの 3 枚を測った数値はありません。
AMD GPU 全体の選び方と ROCm vs CUDA のソフト側事情は「ローカル LLM 向け GPU 選び方ガイド 2026 年版」と「ROCm vs CUDA ローカル LLM 対応状況 2026 年版」、中古 GPU 全般の判断は「中古 GPU でローカル LLM を組むガイド 2026 年版」を先に読むと本記事の位置付けがはっきりします。
スペック比較:RX 7900 XTX / RTX 3090 / RX 9070 XT
まず 3 枚の基本スペックを並べます。
| 項目 | Radeon RX 7900 XTX | GeForce RTX 3090 | Radeon RX 9070 XT |
|---|---|---|---|
| アーキテクチャ | RDNA 3 | Ampere | RDNA 4 |
| 発売 | 2022 年 12 月 | 2020 年 9 月 | 2025 年 3 月 |
| VRAM | 24GB GDDR6 | 24GB GDDR6X | 16GB GDDR6 |
| メモリ帯域 | 960 GB/s | 936 GB/s | 640 GB/s |
| バス幅 | 384 bit | 384 bit | 256 bit |
| ボード電力 | 355 W | 350 W | 304 W |
| 対応スタック | ROCm 7.x / Vulkan | CUDA / Vulkan | ROCm 7.x / Vulkan |
| 価格(2026 年 10 月、日本) | 中古 12〜 18 万円程度(目安) | 中古 15〜 25 万円程度(目安) | 新品 約 13.9〜 18.6 万円(ソフマップ、10/19) |
中古価格は個体の状態と店舗で大きく動くため、出典付きの単一価格ではなく目安の幅で書いています。買う直前に中古店の現在の掲載価格を確認してください。RX 9070 XT の新品価格は ソフマップの検索結果 で 2026 年 10 月 19 日に注文可能だった掲載品の範囲です。
注目すべきは 3 点です。
1 つは RX 7900 XTX のメモリ帯域が 960GB/s と、RTX 3090(936GB/s)とほぼ同じで、RX 9070 XT(640GB/s)の 1.5 倍ある点です。ローカル LLM の生成速度(tok/s)はメモリ帯域に強く縛られるため、7900 XTX は 3090 と同帯、9070 XT より速いと見込めます。次の節の共通ベンチもこの並びになっています(仕組みは「メモリ帯域幅(GB/s)がローカル LLM の tok/sec を決める仕組み 2026 年版」)。
2 つ目は VRAM 24GB という天井です。27〜 32B 級の Q4_K_M はファイルだけで 18GB 前後あり、16GB の 9070 XT には収まりません。24GB ならこの帯が KV キャッシュ込みで載ります。一方で 70B は Q4_K_M が約 42.5GB なので、24GB 単機には収まりません(詳しくは後述)。
3 つ目は 価格帯の重なりです。7900 XTX の中古の目安は、新品の 9070 XT と同じ予算帯に入ります。同じ予算で VRAM が 16GB から 24GB になるのが、7900 XTX 中古を選ぶ最大の理由です。
生成速度(tok/sec):公開ベンチの集約
公開されている数値を、条件の揃い方ごとに並べます。モデル・量子化・ランタイム・llama.cpp のビルドで変わる前提で読んでください。
| GPU | ランタイム | モデル / 量子化 | 生成速度 | 出典 |
|---|---|---|---|---|
| RX 7900 XTX | ROCm / llama.cpp | Llama 2 7B Q4_0(tg128) | 167〜 170 tok/s | llama.cpp #15021 |
| RTX 3090 | CUDA / llama.cpp | Llama 2 7B Q4_0(tg128) | 158〜 162 tok/s | llama.cpp #15013 |
| RX 9070 XT | ROCm / llama.cpp | Llama 2 7B Q4_0(tg128) | 97〜 101 tok/s | llama.cpp #15021 |
| RX 7900 XTX | ROCm / llama.cpp | Qwen3-30B-A3B(MoE) | 約 117 tok/s | ollama #10458 のユーザー報告 |
| RX 7900 XTX | Ollama | Qwen3-30B-A3B(MoE) | 約 33 tok/s | 同上 |
| RX 7900 XTX x2(層分割) | ROCm 7.1.1 / llama.cpp | Llama 3.1 70B Q4_K_M(全層 VRAM) | 13.06〜 13.37 tok/s | 1337hero/rx7900xtx-llama-bench-rocm |
上 3 行は llama.cpp の公式ディスカッションで同じモデル・同じ測り方(llama-bench の tg128、Flash Attention 無効と有効の両方)に揃えた結果なので、3 枚を横並びで比べられます。
差の読み方はこうです。
- 同じ条件の比較:7900 XTX(167〜 170 tok/s)と 3090(158〜 162 tok/s)はほぼ同帯で、9070 XT(97〜 101 tok/s)は 4 割ほど遅い並びです。帯域の比(960 / 936 / 640 GB/s)とおおむね同じ順序で、生成速度が帯域で決まる説明と合います
- MoE は活性化パラメータが少ないぶん速い:Qwen3-30B-A3B は総パラメータ 30.5B のうち 1 トークンあたり動くのが約 3.3B の MoE です(モデルカード)。読み出す重みが少ないので、ファイルサイズが同程度の dense モデルより生成が速くなります。7900 XTX の llama.cpp で約 117 tok/s という報告はこの性質どおりです。同じ報告で Ollama 経由は約 33 tok/s と 3 分の 1 程度にとどまっていて、MoE ではランタイムの差が速度に大きく出ます(2025 年 5 月時点のユーザー報告で、その後の改善で変わっている可能性があります)
- 70B は 2 枚で 13 tok/s 台:Llama 3.1 70B Q4_K_M を 7900 XTX 2 枚に層分割して全層 VRAM に載せた場合が 13.06〜 13.37 tok/s です。単機では Q4_K_M が載らないので、この数字は「2 枚買えばこう」という参考値として読んでください
自分の構成に近い数字が欲しい場合は、上の llama.cpp ディスカッションに同じ GPU の別投稿が並んでいるので、ビルドの日付が近いものを拾うのが確実です。
VRAM 24GB で何が動くか:7900 XTX の主戦場
ファイルサイズを基準に、24GB に何が載るかを整理します。KV キャッシュの分としてファイルサイズに数 GB の余裕を見ておく前提です(コンテキスト長で増えます)。
| モデル / 量子化 | ファイルサイズ | 7900 XTX 24GB 単機 | 出典 |
|---|---|---|---|
| 7〜 8B 級 Q4〜 Q8 | 約 4〜 9GB | ◎ 余裕 | - |
| Qwen3.6-27B(dense)Q4_K_M | 約 18.0GB | ◎ 載る。長コンテキストは注意 | bartowski/Qwen_Qwen3.6-27B-GGUF |
| Qwen3-30B-A3B(MoE)Q4_K_M | 約 18.6GB | ◎ 載る。MoE なので生成が速い | Qwen/Qwen3-30B-A3B-GGUF |
| Llama 3.1 70B IQ2_XS | 約 21.1GB | △ 載るが 2 bit 級で品質は落ちる | bartowski/Meta-Llama-3.1-70B-Instruct-GGUF |
| Llama 3.1 70B Q3_K_M | 約 34.3GB | ✗ 全層は載らない(一部 CPU オフロード) | 同上 |
| Llama 3.1 70B Q4_K_M | 約 42.5GB | ✗ 全層は載らない。2 枚構成なら全層 VRAM | 同上 |
| 100B 以上 | - | ✗ 単機 24GB では非現実的 | - |
ここで RX 9070 XT 16GB との差 がはっきりします。上の表の Qwen3.6-27B と Qwen3-30B-A3B は、Q4_K_M のファイルだけで 16GB を超えるので 9070 XT には載りません。「27〜 30B 級を Q4 で常用したいかどうか」が最初の分岐点で、常用したいなら 7900 XTX 中古が同じ予算帯の答えになります。
70B は 24GB 単機では中途半端です。全層を VRAM に載せられるのは 2 bit 級までで、Q3〜 Q4 は CPU 側のメモリに一部を逃がすことになり、そのぶん生成は大きく遅くなります。70B を Q4 で常用したいなら、7900 XTX を 2 枚にするか、48GB 級の AMD Radeon PRO W7900 などを検討してください。48GB クラス全般は「48GB VRAM ローカル LLM ガイド 2026 年版」、容量別の早見表は「VRAM 容量別ローカル LLM モデル早見表 2026 年版」にまとめています。
ROCm 7.x の現実:Linux なら公式対応、Windows は HIP SDK まで
RX 7900 XTX のソフト側は、Linux と Windows で状況が違います。
- Linux:2026 年 10 月時点の ROCm 7.14.0 の Linux 対応表 に RX 7900 XTX(gfx1100)が載っています。対応 OS は Ubuntu 24.04.4 / 22.04.5、RHEL 10.1 / 9.7 に限られるので、ディストリビューションは合わせておくのが無難です
- Windows:HIP SDK for Windows 7.2.0 の対応リスト に RX 7900 XTX が載っています。ただしこれは HIP SDK(ランタイムとコンパイラ)の対応で、Linux 版 ROCm と同じ範囲のライブラリが Windows で揃うわけではありません。実運用の報告でも、ROCm を本格的に使うなら Linux を勧める声が多いのが現状です
- Vulkan バックエンド:llama.cpp / LM Studio などの Vulkan ビルドは Windows・Linux の両方で動き、ドライバさえ入っていれば導入が軽いのが強みです。ROCm と Vulkan のどちらが速いかはモデルと llama.cpp のビルドで入れ替わる報告があり、一概には言えません
初手は Vulkan で動作確認してから、必要なら Linux の ROCm へ移る 順序が失敗しにくいです。ROCm vs CUDA の全体の対応状況は「ROCm vs CUDA ローカル LLM 対応状況 2026 年版」、Strix Halo での ROCm vs Vulkan の比較は「Strix Halo llama.cpp Vulkan vs ROCm ベンチマーク 2026 年版」で扱っています。
学習フレームワーク側は、PyTorch の ROCm ビルドで RDNA 3 が動くものの、TensorRT は CUDA 専用で、Flash Attention の実装や量子化ライブラリにも CUDA を先に対応させるものが残っています。推論特化なら 7900 XTX で足ります。学習や LoRA も見据えるなら、3090 のほうが互換性のストレスは少ないです。
消費電力・電気代:24 時間稼働で効く差
RX 7900 XTX のボード電力 355W は、RTX 3090 の 350W とほぼ同じで、RX 9070 XT の 304W より約 50W 高いです。この差は 24 時間稼働の自宅 LLM サーバー用途で電気代に効きます。
推論中の平均消費をボード電力の半分と仮定した場合の月次電気代の目安はこうです(実際の消費はモデルと負荷で変わります)。
| GPU | 想定平均消費 | 1 日 24 時間の電力量 | 1 ヶ月(30 日)の電気代(27 円 /kWh) |
|---|---|---|---|
| RX 7900 XTX | 178 W | 4.27 kWh | 約 3,460 円 |
| RTX 3090 | 175 W | 4.20 kWh | 約 3,400 円 |
| RX 9070 XT | 152 W | 3.65 kWh | 約 2,956 円 |
7900 XTX と 9070 XT の差は 1 ヶ月あたり約 500 円、年間で約 6,000 円です。VRAM が 16GB から 24GB になる代わりのコストとしては小さい差です。24 時間稼働の自宅 LLM サーバー全般の構成は「自宅ローカル LLM サーバー構築ガイド 2026 年版」を参照してください。
中古で買うときの注意点
中古 GPU は個体ごとに状態が違うため、以下 3 点の確認を勧めます。
- 使用歴:マイニングなど長時間フル負荷で使われていた個体は、ファン軸受け・サーマルパッドの劣化が進んでいる可能性があります。出品情報で使用歴を確認し、フリマで買う場合は動作確認の情報が出ている個体を選ぶと安全度が上がります
- 保証の有無:中古ショップは店舗ごとに保証期間が違います。24GB クラスは単価が大きいため、故障時のロスを考えると保証付きのほうが現実的です
- 電源容量・補助電源:7900 XTX のリファレンス設計は補助電源 8pin x2 で、カードによっては 8pin x3 です。AMD の推奨電源は 800W 以上です。既存機の電源容量が足りるか、コネクタの数が合うかを事前に確認してください。従来の 8pin PCIe なので、12VHPWR / 12V-2x6 系の変換アダプタは要りません
中古 GPU 全般の判断プロセスは「中古 GPU でローカル LLM を組むガイド 2026 年版」に整理しています。
判断軸:RX 7900 XTX 中古 / RTX 3090 中古 / RX 9070 XT 新品の使い分け
まとめると、次のように判断できます。
RX 7900 XTX 中古を選ぶべき人
- 9070 XT 新品と同じ予算で 24GB を取りたい人。帯域 960GB/s で、共通ベンチの生成速度は 3090 と同帯です
- 27〜 30B 級を Q4 で常用したい人。Qwen3.6-27B や Qwen3-30B-A3B の Q4_K_M が単機に載ります
- Linux で ROCm を使うか、Vulkan で足りる人。Windows で ROCm の全機能を使う前提だと、まだ詰まりやすいです
RTX 3090 中古を選ぶべき人
- CUDA 前提のライブラリを使う可能性がある人。TensorRT は CUDA 専用で、新しい手法の実装も CUDA が先に出ることが多いです
- 学習・LoRA も見据えている人。PyTorch + CUDA のエコシステム互換性は 2026 年秋時点でも最大です
- 「動かすまで」の時間を最短にしたい人。Windows でも CUDA ならそのまま動くツールが多いです
RX 9070 XT 16GB 新品を選ぶべき人
- 16GB で足りて、新品保証を優先する人。RX 9070 XT は 2025 年 3 月発売の RDNA 4 で、FSR 4 に対応し、ROCm の Linux 対応表にも載っています。詳細は「Radeon RX 9070 XT ローカル LLM は買いか 2026 年版」を参照してください
- 電気代を抑えたい人。ボード電力は 7900 XTX より約 50W 低く、上の仮定では 24 時間稼働の電気代が年間約 6,000 円安くなります
32GB / 48GB 以上へ上げるべき人
- 70B を Q4 以上で常用したい人。単機 24GB では 70B は 2 bit 級まで落とすか、一部 CPU オフロードが前提になります。全層を VRAM で回したいなら、7900 XTX の 2 枚構成か、48GB 級の AMD Radeon PRO W7900 が候補です。整理は「AMD Radeon PRO W7900 48GB ローカル LLM 2026 年版」と「48GB VRAM ローカル LLM ガイド 2026 年版」で扱っています
まとめ
- Radeon RX 7900 XTX 中古(RDNA 3、24GB VRAM、帯域 960GB/s)は、2026 年 10 月時点で CUDA にこだわらない人が 24GB を取りにいくときの有力候補。中古価格は目安で 12 万〜 18 万円程度、新品は流通がほぼ終わっている
- llama.cpp の共通ベンチ(Llama 2 7B Q4_0 の生成)で 7900 XTX 167〜 170 tok/s、RTX 3090 158〜 162 tok/s、RX 9070 XT 97〜 101 tok/s
- MoE の Qwen3-30B-A3B は活性化パラメータが約 3.3B と少ないので速く、7900 XTX の llama.cpp で約 117 tok/s のユーザー報告がある
- 24GB の主戦場は 27〜 30B 級の Q4。70B は Q4_K_M が約 42.5GB で単機には載らず、2 枚構成で 13 tok/s 台
- ROCm は Linux なら公式対応表に載っている。Windows は HIP SDK の対応までで、本格的に使うなら Linux
- 推論特化・同じ予算で 24GB なら 7900 XTX 中古、CUDA 必須・学習含むなら 3090 中古、16GB で足りて新品保証なら 9070 XT 新品
入手先・関連商品
当サイトは Amazon.co.jp アソシエイト・プログラムに参加しています。下記リンク経由で購入された場合、紹介料を受け取ることがあります。読者の負担は増えません。リンクは記事評価とは独立しており、編集判断には影響しません。中古 GPU は Amazon.co.jp のほか、ドスパラ中古・じゃんぱら・メルカリ・ヤフオクなどの中古 PC 市場でも流通しているため、価格と保証を比較して選んでください。
AMD Radeon 24GB クラス(本文で言及、ローカル LLM 24GB 本命)
- Radeon RX 7900 XTX を Amazon.co.jp で見る — 本記事の主役。新品の流通はほぼ終わっているため中古・マーケットプレイスが中心
- Radeon RX 7900 XT を Amazon.co.jp で見る — 7900 XTX の下位、20GB VRAM
NVIDIA 側の同帯対抗(本文で言及、CUDA 税を払う 24GB 中古)
- GeForce RTX 3090 24GB を Amazon.co.jp で見る — CUDA 派の 24GB 中古定番
AMD Radeon RDNA 4 新品(本文で言及、16GB で足りる人向け)
- Radeon RX 9070 XT を Amazon.co.jp で見る — 16GB 新品、FSR 4 対応で保証つき
- Radeon RX 9070 を Amazon.co.jp で見る — RX 9070 XT の下位、16GB でボード電力 220W
あなたに合うPCを診断する
用途や予算をもう少し細かく入力すると、3つの候補構成を提案します。
→ 診断スタート
関連記事
- Radeon RX 9070 XT ローカル LLM は買いか 2026 年版:16GB 新品 RDNA 4 との住み分け
- AMD Radeon PRO W7900 48GB はローカル LLM で買いか 2026 年版:48GB 新品ワークステーション側との差分
- ROCm vs CUDA ローカル LLM 対応状況 2026 年版:ROCm 7.x と CUDA のソフト側事情
- 中古 GPU でローカル LLM を組むガイド 2026 年版:中古 GPU 全般の判断プロセス
- 48GB VRAM ローカル LLM ガイド 2026 年版:24GB を超えたときの選択肢
- VRAM 容量別ローカル LLM モデル早見表 2026 年版:容量別に何が動くかの早見
- llama-swap 使い方 Ollama との違い 2026 年版:24GB で複数モデルを時間軸で使い回す運用
よくある質問
- RX 7900 XTX 24GB の 2026 年 10 月時点の中古価格はいくらですか?
- 中古の店頭価格は個体と店舗で大きく動くため、本記事では出典付きの単一価格ではなく、目安の幅として 12 万〜 18 万円程度で扱います。購入時は中古店の現在の掲載価格で確認してください。新品は流通がほぼ終わっていて、ソフマップの新品掲載 20 点は 2026 年 10 月 19 日時点ですべて在庫切れか限定数終了でした。同じ 24GB の RTX 3090 中古も目安の幅(15 万〜 25 万円程度)で見ると、7900 XTX と重なるか下回る帯です。
- RX 7900 XTX でローカル LLM の 70B は動きますか?
- Q4 のまま単機で全層を載せることはできません。Llama 3.1 70B の GGUF は Q4_K_M が約 42.5GB、Q3_K_M でも約 34.3GB あり、24GB に全層が入るのは IQ2_XS(約 21.1GB)以下の 2 bit 級です。Q4 以上で回すなら一部を CPU 側メモリに逃がす運用になり、生成速度は大きく落ちます。全層を VRAM に載せたい場合は 2 枚構成が現実的で、RX 7900 XTX 2 枚 + ROCm 7.1.1 で Llama 3.1 70B Q4_K_M が 13.06〜 13.37 tok/s という公開ベンチがあります。
- RX 7900 XTX は RTX 3090 24GB 中古と比べてどちらが買いですか?
- 推論特化で ROCm を自分で詰められるなら 7900 XTX、CUDA エコシステムと学習用途を含めるなら 3090 です。llama.cpp の共通ベンチ(Llama 2 7B Q4_0 の生成 tg128)では 7900 XTX が 167〜 170 tok/s(ROCm)、3090 が 158〜 162 tok/s(CUDA)で、生成速度はほぼ同帯です。メモリ帯域も 960GB/s と 936GB/s でほぼ同じです。差が出るのはソフト側で、TensorRT や一部の Flash Attention 実装など CUDA 前提のライブラリを使う可能性があるなら 3090 が無難です。
- RX 7900 XTX と新品 RX 9070 XT 16GB、ローカル LLM 用途ではどちらを選ぶべきですか?
- VRAM 24GB が要るなら 7900 XTX、16GB で足りて新品保証を優先するなら 9070 XT です。RX 9070 XT の新品はソフマップで 2026 年 10 月 19 日時点で約 13.9 万〜 18.6 万円(注文可能な掲載品)でした。7900 XTX の優位は 24GB VRAM と 960GB/s の帯域で、Qwen3.6-27B の Q4_K_M(約 18GB)や Qwen3-30B-A3B の Q4_K_M(約 18.6GB)が KV キャッシュ込みで余裕を持って載ります。16GB の 9070 XT ではこの 2 本は Q4_K_M のままでは収まりません。
- RX 7900 XTX で ROCm 7.x は安定して動きますか?
- Linux では動きます。2026 年 10 月時点の ROCm 7.14.0 の Linux 対応表に RX 7900 XTX(gfx1100)が載っています(Ubuntu 24.04.4 / 22.04.5、RHEL 10.1 / 9.7 のみ)。Windows は HIP SDK for Windows 7.2.0 の対応リストに 7900 XTX が載っていますが、これは HIP SDK の対応であって Linux 版 ROCm と同じ範囲が Windows で揃うわけではなく、実運用の報告でも Linux を勧める声が多いのが現状です。初手は Vulkan バックエンドで動作確認し、必要なら Linux の ROCm へ移る順序が失敗しにくいです。
- RX 7900 XTX の消費電力はどれくらいですか?24 時間稼働の電気代は?
- 公式の Typical Board Power は 355W です。推論中の平均消費を TBP の半分(約 178W)と仮定すると、24 時間稼働で 1 ヶ月あたり約 3,460 円(27 円 /kWh)、年間で約 4.2 万円です。RX 9070 XT の 304W より約 50W 高く、RTX 3090 の 350W とほぼ同等です。常時稼働なら、Linux の rocm-smi や Windows の AMD Software で電力上限を下げる運用も検討の余地があります。
- RX 7900 XTX 中古を買うときに気をつけるべきことは?
- 重要なのは 3 点です。(1) マイニングなど長時間フル負荷の使用歴がないか出品情報で確認する(ファン・サーマルパッドの劣化が進んでいる可能性があります)、(2) 保証の有無と期間を店舗ごとに確認する、(3) 補助電源の本数(リファレンス設計は 8pin x2、カードによっては 8pin x3)と電源容量を確認する(AMD の推奨は 800W 以上)。フリマで買う場合は動作確認の情報が出ている個体を選ぶと安全度が上がります。
- RX 7900 XTX は llama-swap で複数モデルの運用ができますか?
- できます。llama-swap は llama.cpp の llama-server などを前段で切り替えるプロキシなので、ROCm 版でも Vulkan 版でも同じように使えます。24GB あれば、小さいコード補完モデルと埋め込みモデルを常駐させつつ、Qwen3-30B-A3B のような大きめのモデルを必要なときだけ読み込む使い分けが組めます。詳細は関連記事「llama-swap 使い方 Ollama との違い」を参照してください。